一个群用便宜模型、一个群用旗舰模型:channel_overrides 怎么配,以及每轮丢缓存的那个坑
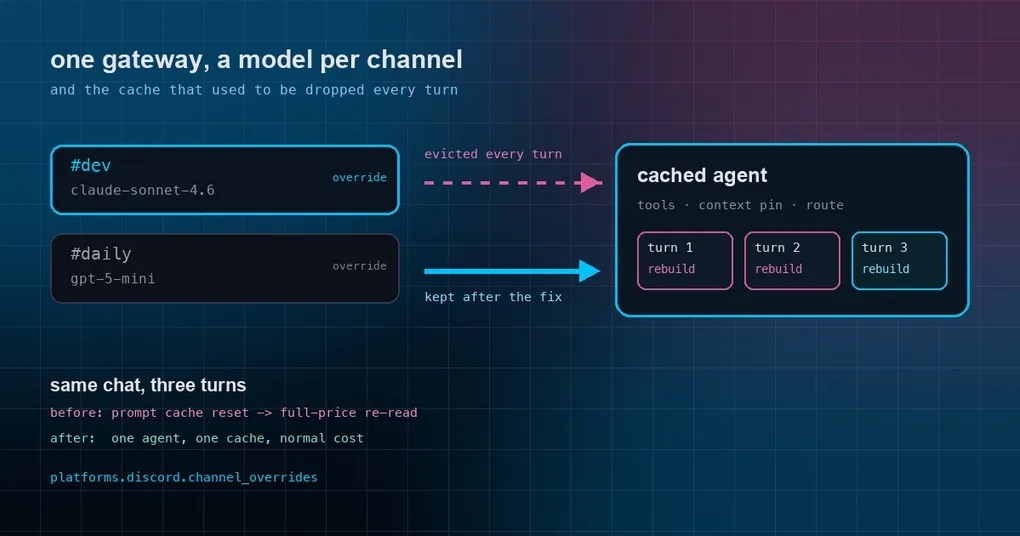
你在自己的 Discord 服务器里跑了一个 Hermes 机器人。#daily 频道大家只是闲聊、查资料,用旗舰模型完全是浪费;#dev 频道专门贴代码让它做评审,用便宜的小模型又会给你一堆似是而非的意见。你不想为此开两个机器人、维护两份配置和两份记忆——你只想让同一个机器人在不同频道里表现得不一样。
这件事 Hermes 一直支持,配置项叫 channel_overrides。但在这之前,它有一个让人很难发现的代价:只要某个频道的模型来自这个覆盖配置,Hermes 就会在每一轮对话结束后把缓存好的 agent 丢掉,下一轮从头再做一遍准备。表面上对话还能用,你只会觉得“这个频道的机器人怎么有点迟钝”。
10 月 6 日合并的 PR #133948 修掉了这个问题。下面先把功能本身讲清楚,再说这个坑到底贵在哪里。
为什么要在频道级别配模型
一个 gateway 可以同时接 Telegram、Discord、Slack 等多个平台,每个平台下又有许多频道、群组、话题(thread)。默认情况下,同一个平台里所有聊天共享同一个模型和同一个系统提示词。
这在两种场景下不够用:
- 成本:闲聊频道不需要旗舰模型,一天几百条消息全按旗舰价算,账单会很难看。
- 人设:代码评审频道需要一个“审查者”人设,生活频道需要一个“轻快助手”人设,共用一份全局提示词只会两头不讨好。
channel_overrides 就是为这两件事设计的:在同一个 gateway 里,让指定的频道或话题跑不同的 model、provider 和 system_prompt。
三步配好
配置写在 ~/.hermes/config.yaml 里,挂在对应平台下面。假设你的 Discord 服务器里 #dev 频道 ID 是 123456789012345678,#daily 是 987654321098765432:
platforms:
  discord:
    enabled: true
    channel_overrides:
      "123456789012345678":        # 频道或话题 id
        model: anthropic/claude-sonnet-4.6
        provider: anthropic
        system_prompt: "You are the #dev channel code-review specialist."
      "987654321098765432":
        model: openai/gpt-5-mini
三个键都是可选的,只写 model、只写 system_prompt、或者任意组合都行;没写的字段回落到全局默认值。system_prompt 是临时注入的——它只在那一轮拼进上下文,不会写进会话历史,所以不会污染你今后的对话记录。
改完配置后重启 gateway,或在会话里用 /reload 类命令让它重新读取配置,然后在一个受影响的频道里发一条消息验证。
优先级:会话里手动切换永远更高
知道谁赢谁输,比记住配置项更重要。模型的解析顺序是:
- 会话里的
/model覆盖 —— 用户在某个聊天里手动切的模型; channel_overrides—— 你写在配置里的频道级默认值;- 全局配置 / 环境变量 —— 其他所有情况。
也就是说,频道覆盖虽然比全局高,但压不过用户在那个聊天里亲自 /model 过的选择。另外,查找顺序是先精确匹配频道/话题 ID,再匹配父频道 ID——所以 Discord 里的话题(thread)会自动继承父频道的设置,你不需要给每个话题单独写一条。
那个坑:带覆盖的会话每轮都被清空一次
Hermes 的 gateway 为了省钱,会在内存里缓存一个“会话 agent”,让连续的对话复用同一套已经准备好的运行时状态(工具、上下文固定项等等)。这套缓存还在的时候,你连着发几条消息是很快的。
问题出在一轮对话结束后的自检上。原来的代码要判断“这一轮是不是因为备用路线(fallback)才换了模型”,判断方法拿的是全局模型当基准线。而带 channel_overrides 的聊天,模型本来就不应该等于全局模型——于是这个自检每一轮都误判成“刚才发生了一次 fallback”,顺手把缓存 agent 连同它的会话上下文固定项一起清掉。
结果就是:那个频道的每一轮对话都要重建一次 agent。你感觉到的只是“慢一点、贵一点”,日志里也不会有刺眼的报错。
为什么这件事值得当成 P0
一次 agent 重建不只是“多花几毫秒”。它会牵连到上游的提示词缓存:缓存的键里包含模型和上下文前缀,一旦前缀变了,下一次请求就得把整个对话按全价重新读一遍。对于一个聊了几十轮的频道,这意味着每轮都在为同一批历史 token 重复付费。
这也是修复被标成 P0 的原因——它不是崩溃,但它是持续、静默、每天都在发生的浪费,而且专挑那些做了正确配置(分频道设模型)的用户下手,属于“越想省钱的配置,越会被坑”。
修复做了什么
PR #133948 把那条基准线改成了和 agent 构建时一致的解析方式:
- 基准线也按同样顺序解析——先看这一轮实际用的会话
/model,再看频道覆盖,最后才是全局模型; - 比较基准线时使用 agent 的主路线(primary provider)做归一化,而不是它当时所在的路线,这样真正落到别的 provider 或欢迎主机的 fallback 依然会被识别出来;
- 在比名字之前,先看 agent 是否带着“provider fallback 生效中”的标记——这个标记只有真正激活过 fallback 才会亮,比单纯的模型名比较可靠得多。
顺带修了一个反方向的错误:以前某些真的发生了 fallback 的轮次反而被当成“正常”而留住了缓存。现在这张行为对照表两边的误判都收窄了。
怎么确认自己的情况
如果你在用频道级模型覆盖,可以按这个顺序自查:
- 打开
~/.hermes/config.yaml,确认platforms.<平台>.channel_overrides里的模型名和你预期的一致; - 在受影响的频道里发一条消息,看回应的首字节延迟是否明显高于其他频道;修复前这里会持续偏高;
- 如果这个 gateway 同时服务多个 profile,注意它和模型覆盖配置是两个不同层级的开关:
model_overrides管的是一个 profile 内部按任务分模型,channel_overrides管的是一个平台频道用哪个模型,两者可以叠加。
注意事项
- 手动切模型会主动清空提示词缓存。在会话里执行
/model换模型,缓存键就变了,下一条消息必然全价重读——这是设计如此,不是 bug。要长期固定,用/model --global写回config.yaml;不过如果这个聊天有channel_overrides,频道设置会继续压过config.yaml,这是有意的(否则你的频道设置会被一次全局切换悄悄抹掉)。 - 只覆盖 provider、不写 model 的条目目前仍然会拿全局模型当基准来比较,这是已知的边界情况,和修复前的行为一致。
- 别为了修这个问题去关掉 agent 缓存。缓存是省钱的关键,问题在判断逻辑,已经修好了;正确的做法是把 Hermes 更新到包含该修复的版本。
小结
channel_overrides 是一个被低估的功能:一个 gateway、一份记忆、一份配置,就能让不同频道承担不同角色,同时把最贵的模型留给真正需要它的地方。它的坑也很典型——不是报错,而是悄悄让你多付钱。把配置写对,再把 Hermes 更新到修好之后的版本,你才算真正拿到了它承诺的性价比。
如果你在意缓存这件事,可以接着看多 Profile 之间的提示词缓存共享,那是另一个维度的省钱技巧。