Um modelo barato num canal, um modelo de fronteira em outro: como o channel_overrides funciona (e o bug de cache que o deixou caro)
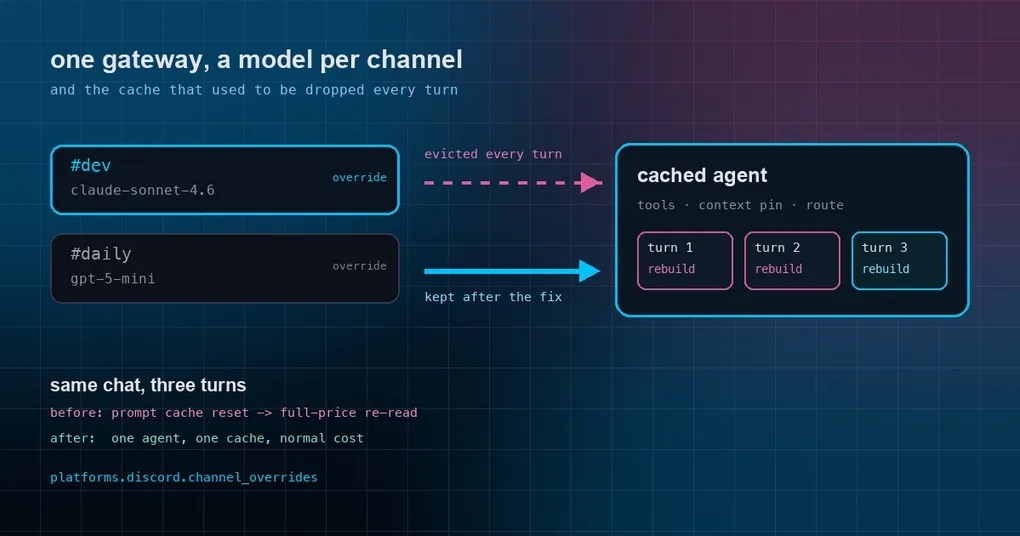
Você roda um único bot do Hermes no seu servidor do Discord. No #daily, o pessoal só conversa e consulta coisas, então pagar preço de modelo de fronteira ali é puro desperdício. No #dev, as pessoas colam código e querem uma revisão, e um modelo pequeno e barato te dá confiança em cima de bobagem. Você não quer dois bots, duas configs e duas memórias. Você quer o mesmo bot se comportando de forma diferente dependendo de onde ele está falando.
O Hermes já suporta isso há um tempo — a configuração se chama channel_overrides. Mas até esta semana ela vinha com um custo genuinamente difícil de perceber: sempre que o modelo de um chat vinha desse override, o Hermes descartava o seu agent em cache logo depois de cada turno e remontava tudo no turno seguinte. O chat continuava funcionando. Só que parecia lento, e custava mais sem você notar.
O PR #133948, mesclado em 6 de outubro, corrigiu isso. Primeiro a funcionalidade, depois a armadilha.
Por que você iria querer modelos por canal
Um único gateway pode atender Telegram, Discord, Slack e outros ao mesmo tempo, e cada plataforma tem vários canais, grupos e threads. Por padrão, todo chat de uma plataforma compartilha um modelo e um system prompt.
Isso quebra em duas situações bem conhecidas:
- Custo. Um canal de chat não precisa de um modelo de fronteira. Algumas centenas de mensagens por dia a preços de topo de linha somam rápido.
- Persona. Um canal de revisão de código precisa da voz de um revisor; um canal geral precisa de um assistente leve. Um único prompt global compartilhado vai mal nos dois.
channel_overrides existe exatamente para isso: dentro de um único gateway, dar a canais ou threads específicos o seu próprio model, provider e system_prompt.
Configurando
A configuração fica em ~/.hermes/config.yaml, dentro da plataforma. Digamos que o id do seu canal #dev seja 123456789012345678 e o do #daily seja 987654321098765432:
platforms:
  discord:
    enabled: true
    channel_overrides:
      "123456789012345678":        # id do canal ou da thread
        model: anthropic/claude-sonnet-4.6
        provider: anthropic
        system_prompt: "You are the #dev channel code-review specialist."
      "987654321098765432":
        model: openai/gpt-5-mini
As três chaves são opcionais. Defina só model, só system_prompt, ou qualquer combinação — o que você deixar de fora volta para o padrão global. O override de system_prompt é efêmero: é injetado a cada turno e nunca é guardado no histórico, então não polui o registro da sua conversa.
Reinicie o gateway (ou recarregue a config a partir de uma sessão) e depois mande uma mensagem num canal afetado para confirmar.
Prioridade: um switch manual no chat sempre vence
A resolução do modelo segue esta ordem:
- o próprio override
/modelda sessão — o que o usuário escolheu dentro daquele chat; channel_overrides— o padrão por canal que você configurou;- config global / ambiente.
Ou seja, um override de canal supera o padrão global, mas nunca vence um usuário que rodou /model de propósito naquela conversa. A busca também vai primeiro pelo id exato do canal ou da thread, depois pelo id do canal pai — o que significa que threads do Discord herdam automaticamente o override do canal pai. Você não precisa de uma entrada por thread.
A armadilha: um chat com override era apagado a cada turno
Para economizar, o gateway guarda em memória um agent por sessão, de modo que mensagens consecutivas reutilizem o mesmo runtime já preparado — ferramentas, pins de contexto e tudo mais que é caro de montar. Enquanto esse cache está quente, uma sequência de mensagens é rápida.
O problema estava na autoverificação pós-turno. Ela decidia se o turno tinha caído para outro modelo comparando o modelo do agent com o modelo global. Mas um chat com channel_overrides deve mesmo diferir do modelo global. Então a checagem concluía, em todo santo turno, que um fallback tinha acabado de acontecer — e descartava o agent em cache junto com o seu pin de contexto de sessão.
O resultado visível: cada turno naquele canal remontava o agent do zero. Sem crash, sem erro gritante nos logs, só um “esse bot parece meio lento” e uma conta maior do que o esperado.
Por que isso merecia um P0
Remontar um agent não é só alguns milissegundos. Isso também invalida o prompt cache a montante, cuja chave inclui o modelo e o prefixo de contexto. Assim que o prefixo muda, a próxima requisição tem que ler a conversa inteira de novo, a preço cheio de input. Num chat com dezenas de turnos, isso significa pagar o valor cheio pela mesma história vez após vez.
É por isso que a correção é rotulada como P0. Ela não quebra nada de forma barulhenta — desperdiça dinheiro continuamente, em silêncio, todo dia, e mira justamente os usuários que configuraram tudo certo. Quanto mais você tentava economizar, mais era cobrado.
O que a correção faz
O PR #133948 reconstrói essa baseline do mesmo jeito que o próprio agent foi montado:
- a baseline resolve na mesma ordem — o override
/modelda sessão realmente usado no turno, depois o override do canal, depois o modelo global; - normaliza pelo provider primary do agent e fixa na rota primary, então um fallback real para outro provider ou para o host de boas-vindas ainda é detectado;
- antes de comparar nomes, ela verifica se o agent tem uma flag de provider-fallback ativa. Só uma ativação real de fallback liga essa flag, e uma comparação de nome de modelo por si só não consegue enxergar um fallback que serve o modelo configurado a partir de um endpoint diferente.
Também corrigiu o erro oposto: turnos que tinham realmente caído para outro modelo eram tratados como saudáveis e mantinham o cache. Agora as duas direções de classificação errada são mais estreitas.
Conferindo a sua própria configuração
Se você usa overrides de modelo por canal:
- abra
~/.hermes/config.yamle confirme que os modelos emplatforms.<platform>.channel_overridessão o que você espera; - mande uma mensagem no canal afetado e observe o time to first token; antes da correção, ele ficava bem mais alto ali do que nos outros lugares;
- se o seu gateway atende vários perfis, note que esta é uma camada diferente da config de model overrides:
model_overridesescolhe modelos por tarefa dentro de um perfil,channel_overridesescolhe o modelo por canal da plataforma. Eles se acumulam.
Detalhes que vale a pena saber
- Trocar de modelo manualmente limpa o prompt cache. Mudar o modelo com
/modelno meio da sessão muda a chave do cache, então a próxima mensagem relê tudo a preço cheio. Isso é de propósito, não é bug. Para fixar, use/model --globalpara gravar emconfig.yaml— mas se aquele chat tem uma entrada emchannel_overrides, a configuração do canal continua vencendo de propósito; caso contrário, um switch global pontual apagaria silenciosamente o seu desenho por canal. - Overrides só de provider (sem
model) ainda são comparados com o modelo global. Esse é um caso extremo conhecido, inalterado em relação a antes. - Não “conserte” um problema de cache desativando o cache de agent. O cache é o ponto; o bug estava na lógica de comparação e já foi embora. Atualize o Hermes para um build que inclua a correção.
A versão curta
channel_overrides é um recurso subestimado: um gateway, uma memória, uma config, e cada canal recebe o modelo e a persona certos — com o modelo caro reservado para onde ele vale a pena. Também rendeu um bug de custo silencioso de manual: nada falhava, você só pagava mais. Acerte a configuração e rode um build do Hermes que inclua a correção.
Se economia de cache te interessa, compartilhamento de prompt cache entre perfis é a próxima camada dessa mesma história.