Un modèle économique dans un channel, un modèle frontier dans un autre : comment fonctionne channel_overrides (et le bug de cache qui le rendait cher)
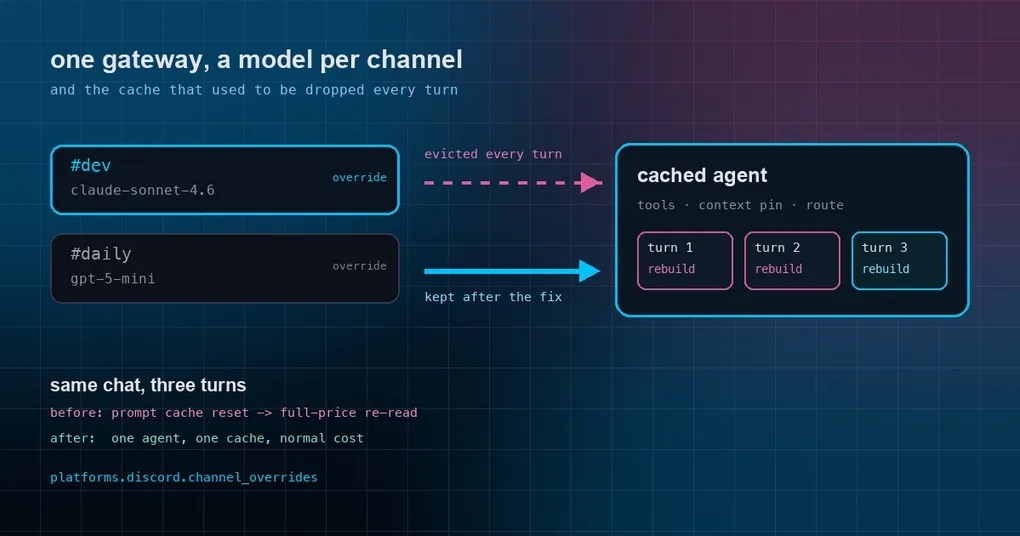
Vous faites tourner un seul bot Hermes sur votre serveur Discord. Dans #daily, les gens discutent et cherchent des infos : y payer le tarif des modèles frontier est du pur gaspillage. Dans #dev, on colle du code et on attend une relecture, et un petit modèle bon marché vous sort des bêtises avec assurance. Vous ne voulez pas deux bots, deux configs et deux mémoires. Vous voulez que le même bot se comporte différemment selon l’endroit où il parle.
Hermes prend cela en charge depuis un moment — le réglage s’appelle channel_overrides. Mais jusqu’à cette semaine, il s’accompagnait d’un coût vraiment difficile à repérer : dès que le modèle d’un chat provenait de cet override, Hermes jetait son agent mis en cache après chaque tour et reconstruisait tout au suivant. Le chat continuait de fonctionner. Il semblait juste un peu lent, et il coûtait discrètement plus cher.
La PR #133948, fusionnée le 6 octobre, a corrigé cela. Voici d’abord la fonctionnalité, puis le piège.
Pourquoi vouloir des modèles par channel
Une seule gateway peut servir Telegram, Discord, Slack et d’autres à la fois, et chaque platform compte de nombreux channels, groupes et threads. Par défaut, tous les chats d’une platform partagent un même modèle et un même system prompt.
Cela craque dans deux situations classiques :
- Le coût. Un channel de discussion n’a pas besoin d’un modèle frontier. Quelques centaines de messages par jour au tarif des modèles phares, et la facture grimpe vite.
- Le persona. Un channel de revue de code a besoin de la voix d’un relecteur ; un channel général a besoin d’un assistant léger. Un seul prompt global partagé est mauvais dans les deux cas.
channel_overrides existe exactement pour ça : au sein d’une seule gateway, donner à des channels ou threads précis leur propre model, provider et system_prompt.
La mise en place
La config se trouve dans ~/.hermes/config.yaml, sous la platform. Disons que l’id de votre channel #dev est 123456789012345678 et celui de #daily est 987654321098765432 :
platforms:
  discord:
    enabled: true
    channel_overrides:
      "123456789012345678":        # id de channel ou de thread
        model: anthropic/claude-sonnet-4.6
        provider: anthropic
        system_prompt: "You are the #dev channel code-review specialist."
      "987654321098765432":
        model: openai/gpt-5-mini
Les trois clés sont optionnelles. Ne définissez que model, que system_prompt, ou n’importe quelle combinaison — tout ce que vous omettez retombe sur la valeur globale par défaut. L’override de system_prompt est éphémère : il est injecté à chaque tour et jamais stocké dans l’historique, donc il ne pollue pas l’enregistrement de votre conversation.
Redémarrez la gateway (ou rechargez la config depuis une session), puis envoyez un message dans un channel concerné pour vérifier.
Priorité : un changement manuel dans le chat gagne toujours
L’ordre de résolution du modèle est le suivant :
- l’override
/modelde la session — ce qu’un utilisateur a choisi dans ce chat ; channel_overrides— la valeur par défaut par channel que vous avez configurée ;- la config globale / l’environnement.
Ainsi, un override de channel prime sur la valeur globale par défaut, mais ne bat jamais un utilisateur qui a délibérément lancé /model dans cette conversation. La recherche se fait aussi d’abord par id exact de channel ou de thread, puis par id du channel parent — ce qui veut dire que les threads Discord héritent automatiquement de l’override de leur channel parent. Vous n’avez pas besoin d’une entrée par thread.
Le piège : un chat en override était vidé à chaque tour
Pour économiser de l’argent, la gateway met en cache un agent par session en mémoire, afin que des messages consécutifs réutilisent le même runtime préparé — outils, context pins, et tout ce qui coûte cher à construire. Tant que ce cache est chaud, une série de messages est rapide.
Le problème venait de l’auto-vérification d’après-tour. Elle décidait si le tour avait basculé vers un autre modèle en comparant le modèle de l’agent au modèle global. Or un chat avec channel_overrides est censé différer du modèle global. La vérification concluait donc, à chaque tour, qu’un basculement venait d’avoir lieu — et abandonnait l’agent en cache ainsi que son context pin de session.
Résultat visible : chaque tour dans ce channel reconstruisait l’agent de zéro. Pas de crash, pas d’erreur bruyante dans les logs, juste « ce bot a l’air un peu lent » et une facture plus élevée que prévu.
Pourquoi cela méritait un P0
Reconstruire un agent, ce n’est pas juste quelques millisecondes. Cela invalide aussi le prompt cache en amont, dont la clé inclut le modèle et le préfixe de contexte. Une fois le préfixe changé, la requête suivante doit relire toute la conversation au tarif d’entrée plein. Dans un chat de plusieurs dizaines de tours, cela revient à payer plein tarif pour le même historique, encore et encore.
C’est pourquoi le correctif est étiqueté P0. Il ne casse rien bruyamment — il gaspille de l’argent en continu, en silence, chaque jour, et il vise précisément les utilisateurs qui avaient bien configuré les choses. Plus vous essayiez d’économiser, plus vous payiez.
Ce que fait le correctif
La PR #133948 reconstruit cette référence de la même manière que l’agent lui-même a été construit :
- la référence se résout dans le même ordre — l’override
/modelde session réellement utilisé pour le tour, puis l’override de channel, puis le modèle global ; - elle se normalise sur le provider primaire de l’agent et se fixe sur la route primaire, de sorte qu’un vrai basculement vers un autre provider ou vers l’hôte de bienvenue est toujours détecté ;
- avant même de comparer les noms, elle vérifie si l’agent a un flag de provider-fallback actif. Seule une véritable activation de fallback pose ce flag, et une simple comparaison de noms de modèles ne peut pas voir un fallback qui sert le modèle configuré depuis un endpoint différent.
Il corrige aussi l’erreur inverse : les tours qui avaient vraiment basculé étaient traités comme sains et conservaient leur cache. Les deux sens de la mauvaise classification sont désormais plus étroits.
Vérifier votre propre configuration
Si vous utilisez des overrides de modèle au niveau du channel :
- ouvrez
~/.hermes/config.yamlet confirmez que les modèles sousplatforms.<platform>.channel_overridessont bien ceux que vous attendez ; - envoyez un message dans le channel concerné et surveillez le time to first token ; avant le correctif, il restait nettement plus élevé là que partout ailleurs ;
- si votre gateway sert plusieurs profiles, notez qu’il s’agit d’une couche différente de la config model overrides :
model_overrideschoisit les modèles par tâche dans un même profile,channel_overrideschoisit le modèle par channel de platform. Les deux se cumulent.
Avertissements à connaître
- Changer de modèle à la main vide le prompt cache. Modifier le modèle avec
/modelen cours de session change la clé de cache, donc le message suivant relit tout au tarif plein. C’est voulu, pas un bug. Pour que le changement persiste, utilisez/model --globalpour l’écrire dansconfig.yaml— mais si ce chat possède une entréechannel_overrides, le réglage du channel continue délibérément de l’emporter, sinon un changement global ponctuel effacerait en silence votre conception par channel. - Les overrides de provider seul (sans
model) se comparent toujours au modèle global. C’est un cas limite connu, inchangé. - Ne désactivez pas le cache d’agent pour soi-disant corriger un problème de cache. Le cache, c’est justement tout l’intérêt ; le bug était dans la logique de comparaison, et il a disparu. Mettez Hermes à jour vers une build qui inclut le correctif.
En bref
channel_overrides est une fonctionnalité sous-estimée : une seule gateway, une seule mémoire, une seule config, et chaque channel obtient le bon modèle et le bon persona — avec le modèle coûteux réservé là où il gagne sa place. Elle a aussi produit un bug de coût silencieux typique : rien n’échouait, vous payiez simplement plus. Réglez bien la config, et exécutez une build Hermes qui inclut le correctif.
Si l’économie du cache vous intéresse, le partage du prompt cache entre profiles est la couche suivante de la même histoire.