Ein günstiges Modell im einen Kanal, ein Frontier-Modell im anderen: Wie channel_overrides funktioniert (und der Cache-Bug, der es teuer machte)
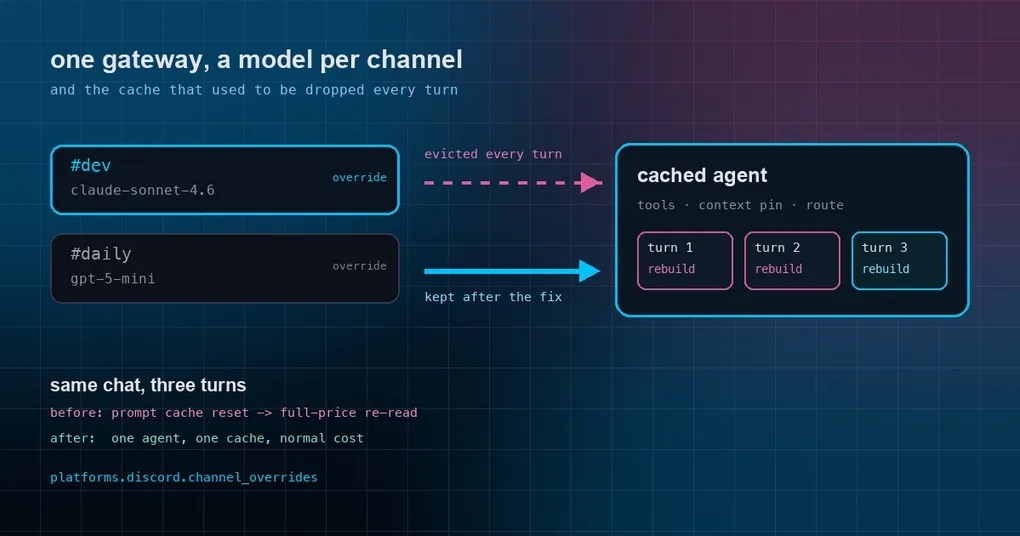
Du betreibst einen einzigen Hermes-Bot in deinem Discord-Server. In #daily wird einfach gequatscht und nachgeschlagen, also wäre es reine Verschwendung, dort Frontier-Modell-Preise zu zahlen. In #dev wird Code gepostet und ein Review gewünscht, und ein billiges kleines Modell liefert dir selbstbewussten Unsinn. Du willst nicht zwei Bots, zwei Configs und zwei Memories. Du willst, dass derselbe Bot sich je nach Kanal anders verhält.
Hermes unterstützt das schon eine Weile – die Einstellung heißt channel_overrides. Doch bis diese Woche ging damit ein Preis einher, der wirklich schwer zu bemerken war: Immer wenn das Modell eines Chats aus diesem Override kam, warf Hermes seinen gecachten Agenten nach jedem einzelnen Turn weg und baute beim nächsten alles neu auf. Der Chat lief weiter. Er fühlte sich nur träge an und kostete still mehr.
PR #133948, gemergt am 6. Oktober, hat das behoben. Zuerst kommt das Feature, dann die Falle.
Warum du Modelle pro Kanal willst
Ein einzelnes Gateway kann Telegram, Discord, Slack und weitere gleichzeitig bedienen, und jede Plattform hat viele Kanäle, Gruppen und Threads. Standardmäßig teilen sich alle Chats einer Plattform ein Modell und einen System-Prompt.
Das geht in zwei vertrauten Situationen schief:
- Kosten. Ein Chat-Kanal braucht kein Frontier-Modell. Ein paar hundert Nachrichten pro Tag zu Flaggschiff-Preisen summieren sich schnell.
- Persona. Ein Code-Review-Kanal braucht die Stimme eines Reviewers; ein allgemeiner Kanal braucht einen leichten Assistenten. Ein einziger gemeinsamer globaler Prompt ist bei beidem schlecht.
channel_overrides gibt es genau dafür: Innerhalb eines Gateways bekommen bestimmte Kanäle oder Threads ihre eigenen model, provider und system_prompt.
Einrichtung
Die Config liegt in ~/.hermes/config.yaml, unter der Plattform. Angenommen, deine #dev-Kanal-ID ist 123456789012345678 und #daily ist 987654321098765432:
platforms:
  discord:
    enabled: true
    channel_overrides:
      "123456789012345678":        # Kanal- oder Thread-ID
        model: anthropic/claude-sonnet-4.6
        provider: anthropic
        system_prompt: "You are the #dev channel code-review specialist."
      "987654321098765432":
        model: openai/gpt-5-mini
Alle drei Schlüssel sind optional. Setze nur model, nur system_prompt oder eine beliebige Kombination – alles, was du weglässt, fällt auf den globalen Default zurück. Der system_prompt-Override ist ephemer: Er wird pro Turn injiziert und nie in der History gespeichert, sodass er deinen Konversationsverlauf nicht verunreinigt.
Starte das Gateway neu (oder lade die Config aus einer Session neu) und schicke dann eine Nachricht in einem betroffenen Kanal, um es zu bestätigen.
Priorität: Ein manueller Wechsel im Chat gewinnt immer
Die Auflösungsreihenfolge für das Modell ist:
- der eigene
/model-Override der Session – also das, was ein Nutzer in diesem Chat gewählt hat; channel_overrides– der pro Kanal konfigurierte Default;- globale Config / Umgebung.
Ein Kanal-Override steht also über dem globalen Default, schlägt aber nie einen Nutzer, der in dieser Konversation bewusst /model ausgeführt hat. Die Suche geht außerdem zuerst nach der exakten Kanal- oder Thread-ID, dann nach der ID des übergeordneten Kanals – das heißt, Discord-Threads erben den Override ihres übergeordneten Kanals automatisch. Du brauchst nicht einen Eintrag pro Thread.
Die Falle: Ein Chat mit Override wurde bei jedem Turn gelöscht
Um Geld zu sparen, cacht das Gateway einen Agenten pro Session im Speicher, damit aufeinanderfolgende Nachrichten dieselbe vorbereitete Runtime wiederverwenden – Tools, Context-Pins und alles andere, dessen Aufbau teuer ist. Solange dieser Cache warm ist, ist eine Reihe von Nachrichten schnell.
Das Problem lag im Self-Check nach dem Turn. Er entschied, ob der Turn auf ein anderes Modell zurückgefallen war, indem er das Modell des Agenten mit dem globalen Modell verglich. Aber ein Chat mit channel_overrides soll sich ja vom globalen Modell unterscheiden. Also schloss der Check bei jedem einzelnen Turn, dass gerade ein Fallback stattgefunden habe – und verwarf den gecachten Agenten samt seinem Session-Context-Pin.
Das sichtbare Ergebnis: Jeder Turn in diesem Kanal baute den Agenten von Grund auf neu auf. Kein Absturz, kein lauter Fehler in den Logs, nur „dieser Bot fühlt sich etwas langsam an“ und eine höhere Rechnung als erwartet.
Warum das ein P0 verdient hat
Einen Agenten neu aufzubauen dauert nicht nur ein paar Millisekunden. Es macht auch den vorgelagerten Prompt-Cache ungültig, dessen Key das Modell und das Context-Prefix enthält. Sobald sich das Prefix ändert, muss die nächste Anfrage die gesamte Konversation erneut lesen – zum vollen Input-Preis. In einem Chat mit Dutzenden Turns bedeutet das, dieselbe History immer wieder zum vollen Tarif zu bezahlen.
Deshalb ist der Fix als P0 eingestuft. Er geht nicht laut kaputt – er verschwendet kontinuierlich, still, jeden Tag Geld, und er trifft genau die Nutzer, die alles richtig konfiguriert haben. Je mehr du sparen wolltest, desto mehr wurde dir berechnet.
Was der Fix bewirkt
PR #133948 baut diese Baseline genauso auf, wie der Agent selbst aufgebaut ist:
- die Baseline löst in derselben Reihenfolge auf – der für den Turn tatsächlich verwendete
/model-Override der Session, dann der Kanal-Override, dann das globale Modell; - sie normalisiert auf den primären Provider des Agenten und pinnt auf die primäre Route, sodass ein echter Fallback auf einen anderen Provider oder auf den Welcome-Host weiterhin erkannt wird;
- bevor überhaupt Namen verglichen werden, prüft sie, ob der Agent ein aktives Provider-Fallback-Flag hat. Nur eine echte Fallback-Aktivierung setzt dieses Flag, und ein reiner Modellnamen-Vergleich kann einen Fallback nicht erkennen, der das konfigurierte Modell von einem anderen Endpoint ausliefert.
Sie hat auch den umgekehrten Fehler behoben: Turns, die tatsächlich zurückgefallen waren, wurden früher als gesund behandelt und behielten ihren Cache. Beide Richtungen der Fehlklassifizierung sind jetzt enger.
Überprüfe dein eigenes Setup
Wenn du Modell-Overrides auf Kanalebene nutzt:
- öffne
~/.hermes/config.yamlund stelle sicher, dass die Modelle unterplatforms.<platform>.channel_overridesdeinen Erwartungen entsprechen; - schicke eine Nachricht in dem betroffenen Kanal und beobachte die Time to First Token; vor dem Fix blieb sie dort spürbar höher als anderswo;
- wenn dein Gateway mehrere Profile bedient: Beachte, dass dies eine andere Ebene ist als die Model-Overrides-Config:
model_overrideswählt Modelle pro Task innerhalb eines Profils,channel_overrideswählt das Modell pro Plattform-Kanal. Sie stapeln sich.
Wissenswerte Einschränkungen
- Ein manueller Modellwechsel leert den Prompt-Cache. Änderst du mitten in der Session das Modell mit
/model, ändert sich der Cache-Key, sodass die nächste Nachricht alles zum vollen Preis neu liest. Das ist beabsichtigt, kein Bug. Damit es dauerhaft gilt, schreibe es mit/model --globalin dieconfig.yaml– doch wenn dieser Chat einenchannel_overrides-Eintrag hat, gewinnt die Kanal-Einstellung bewusst weiter, denn sonst würde ein einmaliger globaler Wechsel dein Pro-Kanal-Design still auslöschen. - Reine Provider-Overrides (ohne
model) werden weiterhin mit dem globalen Modell verglichen. Das ist ein bekannter Edge Case, unverändert gegenüber vorher. - „Repariere“ ein Cache-Problem nicht, indem du den Agenten-Cache deaktivierst. Der Cache ist der Sinn der Sache; der Bug lag in der Vergleichslogik und ist weg. Aktualisiere Hermes auf einen Build, der den Fix enthält.
Die Kurzfassung
channel_overrides ist ein unterschätztes Feature: ein Gateway, ein Memory, eine Config, und jeder Kanal bekommt das richtige Modell und die richtige Persona – wobei das teure Modell dort reserviert bleibt, wo es sich bezahlt macht. Es hat außerdem einen lehrbuchmäßigen Silent-Cost-Bug hervorgebracht: Nichts schlug fehl, du hast einfach mehr bezahlt. Bring die Config in Ordnung und fahre einen Hermes-Build, der den Fix enthält.
Wenn dich die Ökonomie des Cachings interessiert, ist Prompt-Cache-Sharing über Profile hinweg die nächste Ebene derselben Geschichte.