Un modelo barato en un canal y uno frontier en otro: cómo funciona channel_overrides (y el bug de caché que lo encarecía)
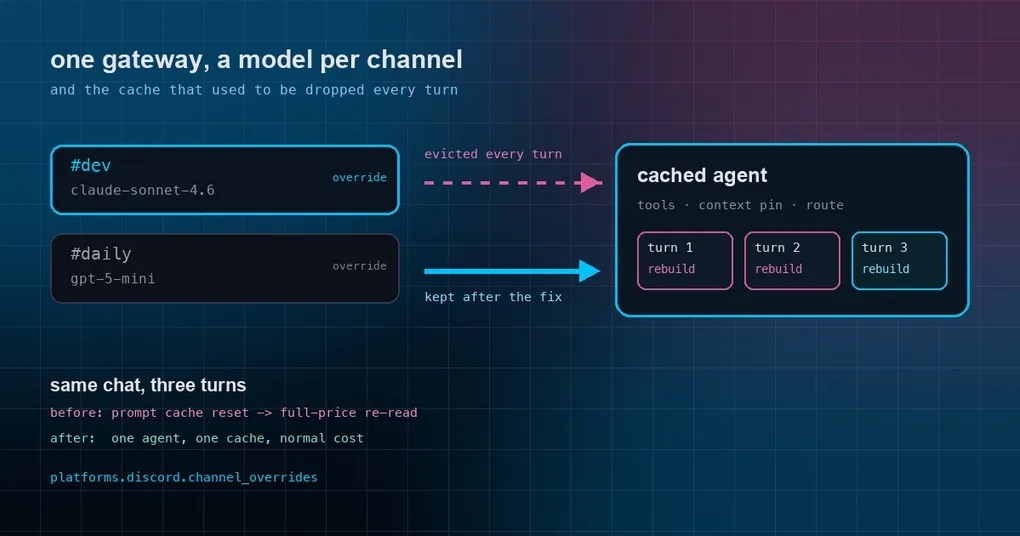
Tienes un solo bot de Hermes en tu servidor de Discord. En #daily la gente solo charla y consulta cosas, así que pagar precios de modelo frontier ahí es tirar el dinero. En #dev la gente pega código y quiere una revisión, y un modelo pequeño y barato te da sandeces con mucha seguridad. No quieres dos bots, dos configs y dos memorias. Quieres que el mismo bot se comporte distinto según dónde esté hablando.
Hermes lleva un tiempo soportando esto: el ajuste se llama channel_overrides. Pero hasta esta semana venía con un coste difícil de notar de verdad: cada vez que el modelo de una conversación salía de ese override, Hermes tiraba su agente en caché después de cada turno y lo reconstruía todo en el siguiente. La conversación seguía funcionando. Solo se sentía lenta y costaba más sin que te dieras cuenta.
El PR #133948, fusionado el 6 de octubre, lo arregló. Primero la función, después la trampa.
Por qué querrías modelos por canal
Un solo gateway puede atender Telegram, Discord, Slack y otros a la vez, y cada plataforma tiene muchos canales, grupos e hilos. Por defecto, cada conversación de una plataforma comparte un modelo y un system prompt.
Eso se rompe en dos situaciones conocidas:
- Coste. Un canal de chat no necesita un modelo frontier. Unos cientos de mensajes al día a precios de gama alta se acumulan rápido.
- Persona. Un canal de revisión de código necesita la voz de un revisor; un canal general necesita un asistente ligero. Un único prompt global compartido es malo para ambas cosas.
channel_overrides existe justo para esto: dentro de un mismo gateway, dar a canales o hilos concretos su propio model, provider y system_prompt.
Cómo configurarlo
La config vive en ~/.hermes/config.yaml, dentro de la plataforma. Digamos que el id de tu canal #dev es 123456789012345678 y el de #daily es 987654321098765432:
platforms:
  discord:
    enabled: true
    channel_overrides:
      "123456789012345678":        # id de canal o hilo
        model: anthropic/claude-sonnet-4.6
        provider: anthropic
        system_prompt: "You are the #dev channel code-review specialist."
      "987654321098765432":
        model: openai/gpt-5-mini
Las tres claves son opcionales. Pon solo model, solo system_prompt, o cualquier combinación: lo que dejes fuera cae al valor global por defecto. El override de system_prompt es efímero: se inyecta en cada turno y nunca se guarda en el historial, así que no ensucia tu registro de conversación.
Reinicia el gateway (o recarga la config desde una sesión) y luego manda un mensaje en un canal afectado para confirmar.
Prioridad: un cambio manual en el chat siempre gana
El orden de resolución del modelo es:
- el override
/modelde la propia sesión — lo que el usuario eligió dentro de ese chat; channel_overrides— el valor por defecto por canal que configuraste;- la config global / el entorno.
Así que un override de canal se impone al valor global por defecto, pero nunca gana a un usuario que ejecutó /model a propósito en esa conversación. Además, la búsqueda va primero por id exacto de canal o hilo, y luego por el id del canal padre, lo que significa que los hilos de Discord heredan automáticamente el override de su canal padre. No necesitas una entrada por hilo.
La trampa: una conversación con override se borraba cada turno
Para ahorrar dinero, el gateway cachea en memoria un agente por sesión, de modo que los mensajes consecutivos reutilizan el mismo runtime ya preparado: herramientas, context pins y todo lo demás que es caro de construir. Mientras esa caché está caliente, una tanda de mensajes va rápida.
El problema estaba en la autocomprobación posterior al turno. Decidía si el turno había caído a otro modelo comparando el modelo del agente con el modelo global. Pero una conversación con channel_overrides se supone que difiere del modelo global. Así que la comprobación concluía, en cada turno, que acababa de ocurrir un fallback, y descartaba el agente en caché junto con su context pin de sesión.
El resultado visible: cada turno en ese canal reconstruía el agente desde cero. Sin crashes, sin errores escandalosos en los logs, solo un “este bot va un poco lento” y una factura más alta de lo esperado.
Por qué esto merecía un P0
Reconstruir un agente no son solo unos milisegundos. También invalida el prompt cache del lado del servidor, cuya clave incluye el modelo y el prefijo de contexto. En cuanto el prefijo cambia, la siguiente petición tiene que releer toda la conversación a precio completo de entrada. En un chat con decenas de turnos, eso significa pagar tarifa completa por el mismo historial una y otra vez.
Por eso el arreglo lleva la etiqueta P0. No rompe nada de forma ruidosa: desperdicia dinero de forma continua, silenciosa, todos los días, y golpea justo a los usuarios que configuraron bien las cosas. Cuanto más intentabas ahorrar, más te cobraban.
Qué hace el arreglo
El PR #133948 reconstruye esa línea base igual que se construyó el propio agente:
- la línea base se resuelve en el mismo orden — el override
/modelde la sesión que realmente se usó en el turno, luego el override de canal, luego el modelo global; - normaliza según el provider primario del agente y fija la ruta primaria, de modo que un fallback real a otro provider o al host de bienvenida se sigue detectando;
- antes de comparar nombres, comprueba si el agente tiene activado un flag de fallback de provider. Solo una activación real de fallback pone ese flag, y una comparación de nombres de modelo por sí sola no puede ver un fallback que sirve el modelo configurado desde otro endpoint.
También arregló el error contrario: los turnos que sí habían caído a un fallback se trataban como sanos y conservaban su caché. Ahora ambas direcciones de la mala clasificación son más estrechas.
Cómo revisar tu propia configuración
Si usas overrides de modelo a nivel de canal:
- abre
~/.hermes/config.yamly confirma que los modelos bajoplatforms.<platform>.channel_overridesson los que esperas; - manda un mensaje en el canal afectado y observa el time to first token; antes del arreglo se mantenía bastante más alto ahí que en otros sitios;
- si tu gateway sirve varios profiles, ten en cuenta que esta es una capa distinta de la config de model overrides:
model_overrideselige modelos por tarea dentro de un mismo profile, ychannel_overrideselige el modelo por canal de plataforma. Se apilan.
Advertencias que conviene conocer
- Cambiar de modelo a mano limpia el prompt cache. Cambiar el modelo con
/modela mitad de sesión cambia la clave de caché, así que el siguiente mensaje relee todo a precio completo. Eso es por diseño, no un bug. Para que persista, usa/model --globalpara escribirlo enconfig.yaml; pero si ese chat tiene una entrada enchannel_overrides, el ajuste del canal sigue ganando a propósito, porque si no un cambio global puntual borraría en silencio tu diseño por canal. - Los overrides solo de provider (sin
model) siguen comparándose con el modelo global. Ese es un caso límite conocido, sin cambios respecto a antes. - No “arregles” un problema de caché desactivando la caché del agente. La caché es el punto; el bug estaba en la lógica de comparación y ya no está. Actualiza Hermes a una build que incluya el arreglo.
La versión corta
channel_overrides es una función infravalorada: un gateway, una memoria, una config, y cada canal recibe el modelo y la persona correctos, reservando el modelo caro para donde de verdad lo aprovecha. También produjo un bug de coste silencioso de manual: nada fallaba, simplemente pagabas más. Configúralo bien y usa una build de Hermes que incluya el arreglo.
Si te interesa la economía del caching, compartir el prompt cache entre profiles es la siguiente capa de esta misma historia.