hermes doctor e o WAL grande: um aviso agora honesto
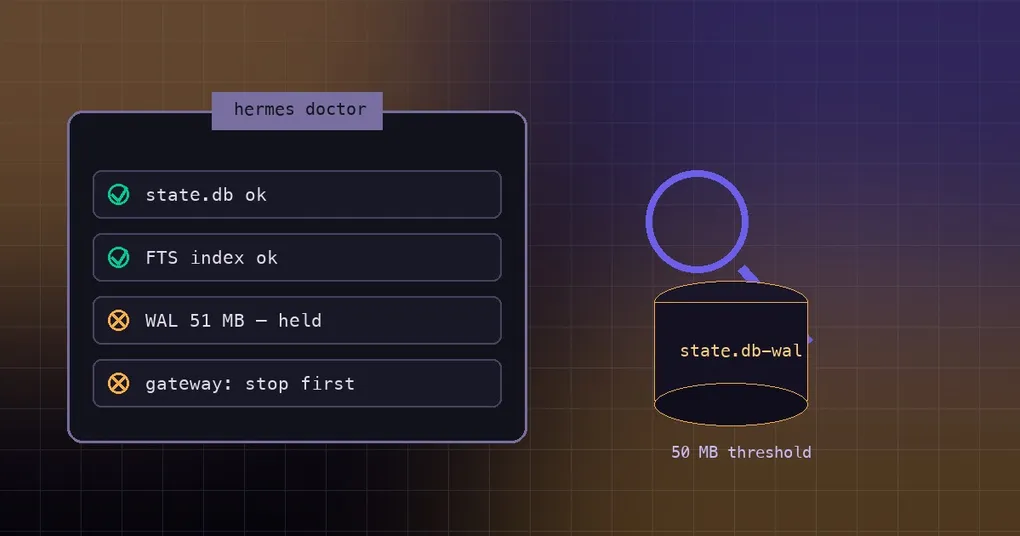
Seu assistente sempre ligado roda há semanas sem parar: o gateway nunca desliga, o Desktop fica aberto em segundo plano e o cron grava no banco em intervalos regulares. Num sábado tranquilo você faz o que é sensato e roda hermes doctor — e ele mostra um aviso: o arquivo WAL está grande, rode hermes doctor --fix para fazer um checkpoint. Você roda, a ferramenta informa checkpoint concluído e um achado corrigido, e tudo parece limpo. Depois você volta ao trabalho e metade da lista de sessões sumiu, ou a próxima inicialização falha direto com o state.db danificado. Esse conselho não tinha má intenção: ele simplesmente não sabia que o banco estava em uso. O PR #113055, mesclado em 16 de setembro de 2026, trata exatamente dessa linha de saída.
O sintoma: um diagnóstico cujo conselho machuca
hermes doctor diagnostica problemas de configuração e de dependências, e hermes doctor --fix é a variante de autorreparo. A documentação da CLI descreve a opção em uma frase: tentar reparos automáticos quando possível.
Antes do #113055, qualquer state.db-wal acima de 50 MB gerava uma sugestão incondicional de rodar --fix. A varredura de holders — a etapa que verifica se outro processo está segurando o banco — só rodava dentro do --fix. Aí está a contradição: o checkpoint que o --fix executa precisa de um banco parado, e com o gateway ou o Desktop rodando o banco está tudo menos parado. As threads no Discord da issue #110054 são usuários seguindo exatamente essa linha para dentro do --fix com o gateway vivo, virando o segundo writer sobre o qual a proteção de WAL apagado dispara depois — e é assim que os danos ao state.db são relatados.
O que é um WAL e quando um grande é normal
WAL (write-ahead log, log de escrita antecipada) é um modo de journal do SQLite: as escritas novas primeiro são anexadas ao arquivo state.db-wal e depois mescladas de volta no state.db principal. Um checkpoint é essa mesclagem, e de quebra encolhe o arquivo WAL. Uma varredura de holders é uma checagem curta: existe algum processo, além do atual, com o banco aberto?
Com esse desenho, o WAL crescer é comportamento esperado. Gateway, Desktop e cron escrevem sem parar, e quando os checkpoints não acontecem com frequência suficiente o arquivo simplesmente aumenta. O doctor observa exatamente dois limites: acima de 10 MB ele imprime uma linha informativa dizendo normal for active sessions, e acima de 50 MB o achado vira aviso. Um WAL de 51 MB numa instalação movimentada pode estar perfeitamente saudável. A pergunta real nunca foi o número no disco, e sim se esse WAL pode ser mesclado com segurança agora.
O que mudou: a varredura de holders agora roda também no caminho de aviso
O _state_db_wal, em hermes_cli/doctor_state.py, agora faz a checagem de holder (hermes_state_repair._live_writer_holds_db, o mesmo wrapper usado por _write_health_reason) antes de dizer qualquer coisa acionável. Com um holder presente, ou com o banco impossível de inspecionar:
WAL file is large (51 MB) (normal while Desktop or the gateway is running, or state.db cannot be inspected — checkpoint only with them stopped)
Large WAL file — cannot prove state.db is quiet (stop the profile's gateway first, then run 'hermes doctor --fix' to checkpoint)
A primeira linha é o texto de aviso da checagem, a segunda é o issue que ela acrescenta. Sem holder, o texto muda e a ordem de parar vem antes da sugestão:
WAL file is large (51 MB) (may indicate missed checkpoints)
Large WAL file — stop the profile's gateway, then run 'hermes doctor --fix' to checkpoint
Dois detalhes dessa redação são propositais. Um verdadeiro na checagem de holder significa “há um holder ou não dá para provar”, nunca “existe um writer ativo com certeza” — por isso a mensagem diz Desktop or the gateway is running or state.db cannot be inspected. Quando a resposta é desconhecida, o doctor falha pelo lado seguro e supõe um writer em vez de afirmar que existe um. Entre 10 MB e 50 MB a linha continua sendo WAL file is 12 MB (normal for active sessions). A semântica do --fix em si não mudou.
O procedimento correto de checkpoint
A ordem importa mais que os comandos: pare os writers, faça o checkpoint, coloque tudo de volta.
hermes gateway status     # veja se o gateway deste profile está rodando
hermes gateway stop       # se estiver, pare
hermes doctor             # ainda sem --fix: veja o que ele diz agora
hermes doctor --fix # só quando ele deixar de apontar um banco não inspecionável- Pare os writers. Pare o gateway deste profile com
hermes gateway stope feche o Desktop pelo menu, sem minimizar. Também não deixe nenhuma sessão de terminal aberta no mesmo profile. - Confirme que está parado. Rode
hermes doctorde novo sem--fix. Se ainda aparecercannot prove state.db is quiet, algo continua segurando o banco: procure o que é, em vez de forçar. - Faça o checkpoint. Rode
hermes doctor --fix. - Leia o resultado. Em caso de sucesso aparece um par de números no formato
WAL checkpoint performed (51200K → 176K): o tamanho do WAL antes da mesclagem, a seta, e o tamanho depois, em kilobytes. - Recoloque os serviços. Reinicie o gateway e reabra o Desktop se você usa.
Se o passo 3 imprimir WAL checkpoint skipped: could not take exclusive ownership of state.db, vem em seguida o motivo informado pelo guard e a dica de parar o gateway e rodar de novo. É o novo comportamento cumprindo a promessa: sem posse exclusiva, sem checkpoint.
Como saber se um writer ativo ainda segura o banco
A varredura de holders não é você que roda; é o doctor. O que ela faz cabe em uma frase: procura qualquer outro processo com o state.db aberto e, só quando a varredura não encontra nenhum, dispara uma sonda BEGIN IMMEDIATE para provar que o banco está mesmo parado — qualquer caso indefinido no meio do caminho é tratado como se houvesse um holder. Essa sonda só roda depois que a varredura descartou um holder estranho, então a própria checagem não pode virar o segundo writer contra o qual ela avisa.
O que dá para conferir na mão é mais simples: hermes gateway status para o gateway, o monitor de atividade ou gerenciador de tarefas para ver se o Desktop ainda roda, e nenhuma sessão de terminal aberta no mesmo profile. Com os três limpos, o checkpoint é seguro.
O que o --fix ainda faz — e o que não faz
Ele ainda faz o checkpoint: executa PRAGMA wal_checkpoint(PASSIVE), agora sob o guard exclusivo de reparo (_exclusive_repair_db_guard). O guard significa que um processo que tente abrir o banco no meio do caminho é recusado, em vez de ser arrastado para o mesmo checkpoint.
Ele avisa quando não consegue. Sem posse exclusiva ele imprime WAL checkpoint skipped: could not take exclusive ownership of state.db, traz o erro do guard e a dica de parar o gateway e rodar de novo, e mantém o issue de que não dá para provar que o state.db está parado — em vez de fingir que o reparo deu certo.
Ele não briga com um writer ativo nem conserta um state.db já danificado. Um banco que já quebrou precisa do outro caminho: comece por como o state.db se cura sozinho. Se o seu sintoma é database is locked e não corrupção, é outra falha com outras correções — veja as correções de lock do state.db.
O resto do hermes doctor, sem pânico
Quase tudo o que a checagem imprime é um status aprovado, e só algumas linhas merecem atenção:
- Um WAL entre 10 MB e 50 MB é informativo. A própria mensagem diz
normal for active sessions. - O aviso de WAL grande com um writer ativo também está dizendo “isto é normal”. A única exigência é que o checkpoint espere o gateway e o Desktop pararem.
- Para compartilhar a sua instalação, use o
hermes dump. É um resumo em texto puro feito para colar numa issue ou num chat, sem cores nem formatação.
Existe exatamente uma situação que pede ação: sem holder, e o WAL nunca encolhe. É aí que o checkpoint offline acima vale a pena. A lista completa de opções está na referência do comando hermes doctor.
A versão curta
O conselho de um diagnóstico vale o que valem as suas premissas. A linha antiga dizia “rode --fix” aos 50 MB sem nunca perguntar se o banco estava parado; desde o PR #113055 o doctor procura primeiro um holder e, quando existe um ou não dá para descartá-lo, avisa que o WAL grande é normal enquanto o Desktop ou o gateway rodam — e que o checkpoint só deve ser feito com eles parados. Isso faz parte do mesmo trabalho de o patch de estabilidade v0.21.2, que corrigiu outra classe de “a ferramenta disse algo que não era bem verdade”. Se você vai fazer uma checagem num install de longa duração, guarde só a ordem: pare o gateway e o Desktop → hermes doctor --fix → inicie os dois de novo.