hermes doctor und die große WAL-Datei: ein ehrlicher Hinweis
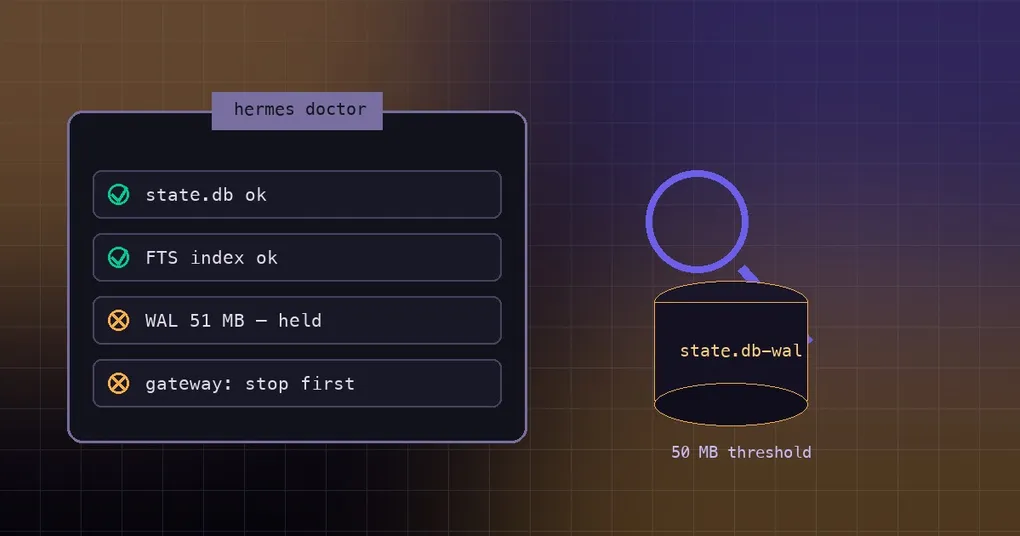
Dein Assistent läuft seit Wochen durch: der Gateway hört nicht auf, Desktop bleibt im Hintergrund offen, cron schreibt regelmäßig in die Datenbank. Also machst du an einem ruhigen Samstag das Vernünftige und rufst hermes doctor auf — und bekommst eine Warnung: die WAL-Datei sei groß, bitte hermes doctor --fix ausführen, um sie zu checkpointen. Du tust das auch, das Werkzeug meldet einen erfolgreichen Checkpoint und einen behobenen Befund, alles sieht ordentlich aus. Dann kehrst du zur Arbeit zurück und die halbe Session-Liste fehlt, oder der nächste Start scheitert direkt an einer beschädigten state.db. Dieser Rat war nicht böswillig; er wusste schlicht nicht, dass die Datenbank gerade benutzt wird. Um genau diese eine Ausgabezeile geht es in PR #113055, gemergt am 16. September 2026.
Das Symptom: eine Diagnose, deren Rat Schaden anrichtet
hermes doctor diagnostiziert Konfigurations- und Abhängigkeitsprobleme, und hermes doctor --fix ist die Selbstreparatur-Variante. Die CLI-Dokumentation beschreibt die Option in einem Satz: automatische Reparaturen versuchen, wo es möglich ist.
Vor #113055 erzeugte jede state.db-wal über 50 MB einen bedingungslosen Hinweis, doch --fix auszuführen. Der Holder-Scan — der Schritt, der prüft, ob ein anderer Prozess die Datenbank hält — lief nur innerhalb von --fix. Das ist der Widerspruch: der Checkpoint, den --fix ausführt, braucht eine ruhige Datenbank, und mit laufendem Gateway oder Desktop ist sie alles andere als ruhig. Die Discord-Threads in Issue #110054 zeigen Nutzer, die genau dieser Zeile in --fix hinein folgen, während der Gateway läuft — sie werden damit zum zweiten Schreiber, auf den die Schutzlogik gegen gelöschte WAL-Dateien anschließend feuert, und so entstehen die gemeldeten Schäden an state.db.
Was eine WAL-Datei ist und wann eine große normal ist
WAL (write-ahead log) ist ein Journal-Modus von SQLite: neue Schreibvorgänge landen zuerst in der Datei state.db-wal und werden später in die Hauptdatei state.db zurückgeführt. Ein Checkpoint ist genau diese Zusammenführung, und nebenbei schrumpft dabei die WAL-Datei. Ein Holder-Scan ist eine kurze Prüfung, ob außer dem aktuellen noch ein anderer Prozess die Datenbank geöffnet hat.
Mit diesem Aufbau ist eine wachsende WAL-Datei erwartetes Verhalten. Gateway, Desktop und cron schreiben ständig, und wenn Checkpoints nicht oft genug passieren, wird die Datei eben größer. Doctor beobachtet genau zwei Schwellen: über 10 MB gibt es eine Info-Zeile mit dem Text normal for active sessions, über 50 MB wird der Befund zur Warnung. Eine 51 MB große WAL kann auf einer beschäftigten Installation völlig gesund sein. Die eigentliche Frage war nie die Zahl auf der Platte, sondern ob diese WAL im Moment sicher zusammengeführt werden kann.
Was sich geändert hat: Der Holder-Scan läuft jetzt auch auf dem Warnpfad
_state_db_wal in hermes_cli/doctor_state.py führt die Holder-Prüfung (hermes_state_repair._live_writer_holds_db, derselbe Wrapper, den _write_health_reason verwendet) jetzt aus, bevor es etwas Handlungsleitendes sagt. Mit einem Holder — oder wenn die Datenbank nicht überprüfbar ist:
WAL file is large (51 MB) (normal while Desktop or the gateway is running, or state.db cannot be inspected — checkpoint only with them stopped)
Large WAL file — cannot prove state.db is quiet (stop the profile's gateway first, then run 'hermes doctor --fix' to checkpoint)
Die erste Zeile ist der Warn-Text der Prüfung, die zweite das Issue, das sie anhängt. Ohne Holder ändert sich die Formulierung, und die Stop-Anweisung steht vor dem Hinweis:
WAL file is large (51 MB) (may indicate missed checkpoints)
Large WAL file — stop the profile's gateway, then run 'hermes doctor --fix' to checkpoint
Zwei Details in dieser Formulierung sind Absicht. Ein Wahr vom Holder-Scan bedeutet „gehalten oder nicht nachweisbar“, niemals „hier schreibt garantiert ein Prozess“ — deshalb lautet die Meldung Desktop or the gateway is running or state.db cannot be inspected. Ist die Antwort unbekannt, scheitert doctor auf der sicheren Seite und nimmt einen Schreiber an, statt einen zu behaupten. Zwischen 10 MB und 50 MB bleibt es bei WAL file is 12 MB (normal for active sessions). Die Semantik von --fix selbst ist unverändert.
Die richtige Checkpoint-Reihenfolge
Die Reihenfolge ist wichtiger als die Befehle: Schreiber stoppen, checkpointen, wieder starten.
hermes gateway status     # prüfen, ob der Gateway dieses profile läuft
hermes gateway stop       # falls ja, stoppen
hermes doctor             # noch ohne --fix: schauen, was jetzt gemeldet wird
hermes doctor --fix # erst, wenn keine nicht überprüfbare Datenbank mehr gemeldet wird- Schreiber stoppen. Den Gateway dieses profile mit
hermes gateway stopstoppen und Desktop über sein Menü beenden — nicht minimieren. Auch keine Terminal-Session auf demselben profile offen lassen. - Ruhe bestätigen.
hermes doctorerneut ohne--fixausführen. Steht dort weiterhincannot prove state.db is quiet, hält noch etwas die Datenbank — suche es, statt es zu erzwingen. - Checkpoint ausführen.
hermes doctor --fix. - Ergebnis lesen. Bei Erfolg erscheint ein Zahlenpaar der Form
WAL checkpoint performed (51200K → 176K): WAL-Größe vor der Zusammenführung, Pfeil, Größe danach, beide in Kilobyte. - Dienste zurückholen. Gateway neu starten und Desktop wieder öffnen, falls du es nutzt.
Steht in Schritt 3 WAL checkpoint skipped: could not take exclusive ownership of state.db, folgt darauf der Grund des Guards plus der Hinweis, den Gateway zu stoppen und erneut zu starten. Genau so hält das neue Verhalten sein Versprechen: ohne exklusiven Zugriff kein Checkpoint.
Wie du erkennst, ob ein laufender Schreiber die Datenbank noch hält
Den Holder-Scan führst du nicht selbst aus, das macht doctor. Was er tut, lässt sich in einem Satz zusammenfassen: er sucht jeden anderen Prozess, der state.db offen hält, und nur wenn der Scan keinen findet, setzt er eine BEGIN IMMEDIATE-Sonde ab, um zu beweisen, dass die Datenbank wirklich ruhig ist — alles Unklare dazwischen gilt als gehaltener Holder. Diese Sonde läuft erst, nachdem der Scan einen fremden Holder ausgeschlossen hat; die Prüfung kann also nicht selbst zu dem zweiten Schreiber werden, vor dem sie warnt.
Von Hand ist es einfacher: hermes gateway status für den Gateway, Aktivitätsanzeige oder Task-Manager für ein laufendes Desktop und keine offene Terminal-Session auf demselben profile. Wenn alle drei sauber sind, ist ein Checkpoint sicher.
Was --fix weiterhin tut — und was nicht
Es checkpointet weiterhin: es führt PRAGMA wal_checkpoint(PASSIVE) aus, inzwischen unter dem exklusiven Reparatur-Guard (_exclusive_repair_db_guard). Der Guard bedeutet, dass ein Prozess, der mittendrin öffnen will, abgewiesen statt in denselben Checkpoint hineingezogen wird.
Es sagt es, wenn es nicht kann. Ohne exklusiven Zugriff erscheint WAL checkpoint skipped: could not take exclusive ownership of state.db, dazu der Fehler des Guards und der Hinweis, den Gateway zu stoppen und erneut auszuführen — und das Issue, dass sich nicht beweisen lässt, dass state.db ruhig ist, bleibt bestehen, statt die Reparatur als gelungen darzustellen.
Es kämpft nicht gegen einen laufenden Schreiber und es repariert keine bereits beschädigte state.db. Eine schon beschädigte Datenbank braucht den anderen Weg: beginne mit wie sich state.db selbst heilt. Ist das Symptom database is locked statt Korruption, ist das ein anderer Fehlerfall mit anderen Maßnahmen — siehe die state.db-Lock-Fixes.
Der Rest von hermes doctor, ohne Panik
Fast alles, was der Health-Check ausgibt, ist ein bestandener Status; nur wenige Zeilen verdienen Aufmerksamkeit:
- Eine WAL zwischen 10 MB und 50 MB ist eine Information. Die Meldung selbst sagt
normal for active sessions. - Die Warnung bei großer WAL mit laufendem Schreiber sagt ebenfalls „das ist normal“. Ihre einzige Forderung: der Checkpoint wartet, bis Gateway und Desktop gestoppt sind.
- Zum Weitergeben deines Setups nutze
hermes dump. Es ist eine Klartext-Zusammenfassung zum Einfügen in ein Issue oder einen Chat, ohne Farben und Formatierung.
Genau eine Situation verlangt Handeln: kein Holder und die WAL schrumpft nie. Dann lohnt sich der Offline-Checkpoint von oben. Die vollständige Optionsliste steht in der Referenz zum Befehl hermes doctor.
Die Kurzfassung
Der Rat einer Diagnose ist nur so gut wie seine Voraussetzungen. Die alte Zeile sagte bei 50 MB „führe --fix aus“, ohne je zu fragen, ob die Datenbank ruhig ist; seit PR #113055 sucht doctor zuerst nach einem Holder und erklärt dir, wenn einer existiert oder nicht ausgeschlossen werden kann, dass die große WAL normal ist, solange Desktop oder der Gateway laufen — und dass du nur mit gestoppten Diensten checkpointen solltest. Das gehört zum selben Arbeitspaket wie der Stabilitäts-Patch v0.21.2, der eine andere Klasse von „das Werkzeug hat etwas gesagt, das nicht ganz stimmte“ behoben hat. Wenn du eine lange laufende Installation prüfen willst, merke dir einfach die Reihenfolge: Gateway und Desktop stoppen → hermes doctor --fix → wieder starten.