hermes doctor y el WAL grande: un aviso honesto
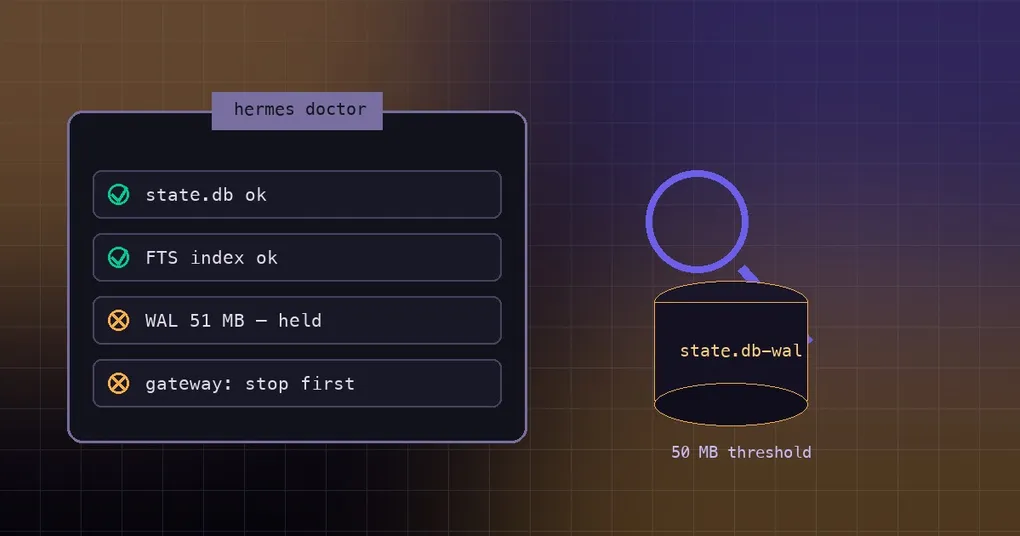
Tu asistente siempre encendido lleva semanas sin parar: el gateway no se detiene, Desktop vive en segundo plano y cron escribe en la base de datos cada cierto tiempo. Un sábado tranquilo haces lo responsable y ejecutas hermes doctor, y te responde con una advertencia: el archivo WAL es grande, ejecuta hermes doctor --fix para hacer un checkpoint. Lo haces, la herramienta informa de un checkpoint correcto y de un hallazgo reparado, y todo parece en orden. Después vuelves al trabajo y falta la mitad de la lista de sesiones, o el siguiente arranque falla directamente por un state.db dañado. Aquel consejo no tenía mala intención: simplemente no sabía que la base de datos estaba en uso. El PR #113055, fusionado el 16 de septiembre de 2026, va exactamente sobre esa línea de salida.
El síntoma: un diagnóstico cuyo consejo hace daño
hermes doctor diagnostica problemas de configuración y de dependencias, y hermes doctor --fix es su variante de autorreparación. La documentación de la CLI describe la opción en una sola frase: intentar reparaciones automáticas cuando sea posible.
Antes del #113055, cualquier state.db-wal de más de 50 MB producía una sugerencia incondicional de ejecutar --fix. El holder scan —el paso que comprueba si otro proceso tiene abierta la base de datos— solo corría dentro de --fix. Ahí está la contradicción: el checkpoint que hace --fix necesita una base de datos tranquila, y con el gateway o Desktop en marcha la base no está tranquila en absoluto. Los hilos de Discord del issue #110054 son usuarios siguiendo justamente esa línea hacia --fix con el gateway vivo, convirtiéndose en el segundo escritor sobre el que luego dispara la protección de WAL borrado, que es como se reportan los daños en state.db.
Qué es un WAL y cuándo es normal que sea grande
WAL (write-ahead log, registro de escritura anticipada) es un modo de journal de SQLite: las escrituras nuevas se añaden primero al archivo state.db-wal y se fusionan después con el state.db principal. Un checkpoint es esa fusión, y de paso encoge el archivo WAL. Un holder scan es una comprobación corta: busca cualquier proceso, distinto del actual, que tenga la base de datos abierta.
Con ese diseño, que el WAL crezca es lo esperado. El gateway, Desktop y cron escriben sin parar, y cuando los checkpoints no ocurren con suficiente frecuencia el archivo simplemente se hace más grande. Doctor vigila exactamente dos umbrales: por encima de 10 MB imprime una línea informativa que dice normal for active sessions, y por encima de 50 MB el hallazgo pasa a ser advertencia. Un WAL de 51 MB en una instalación ocupada puede estar perfectamente sano. La pregunta real nunca fue el número en disco, sino si ese WAL se puede fusionar de forma segura en este momento.
Qué cambió: el holder scan ahora también corre en la ruta de aviso
_state_db_wal, en hermes_cli/doctor_state.py, ahora hace la comprobación de titular (hermes_state_repair._live_writer_holds_db, el mismo envoltorio que usa _write_health_reason) antes de decir nada accionable. Con un titular presente, o con la base imposible de verificar:
WAL file is large (51 MB) (normal while Desktop or the gateway is running, or state.db cannot be inspected — checkpoint only with them stopped)
Large WAL file — cannot prove state.db is quiet (stop the profile's gateway first, then run 'hermes doctor --fix' to checkpoint)
La primera línea es el texto de advertencia de la comprobación; la segunda es el issue que añade. Sin titular, la redacción cambia y la orden de detener aparece antes de la sugerencia:
WAL file is large (51 MB) (may indicate missed checkpoints)
Large WAL file — stop the profile's gateway, then run 'hermes doctor --fix' to checkpoint
Hay dos detalles deliberados en ese texto. Un verdadero del holder scan significa «lo tiene o no se puede demostrar», nunca «hay seguro un escritor activo»: de ahí que el mensaje diga Desktop or the gateway is running or state.db cannot be inspected. Cuando la respuesta es desconocida, doctor falla del lado seguro y asume que hay un escritor en lugar de afirmarlo. Entre 10 MB y 50 MB la línea sigue siendo WAL file is 12 MB (normal for active sessions). La semántica de --fix no ha cambiado.
El procedimiento correcto de checkpoint
El orden importa más que los comandos: detén a los escritores, haz el checkpoint y vuelve a levantarlos.
hermes gateway status     # comprueba si el gateway de este profile está corriendo
hermes gateway stop       # deténlo si lo está
hermes doctor             # todavía sin --fix: mira qué dice ahora
hermes doctor --fix # solo cuando deje de reportar una base no verificable- Detén a los escritores. Para el gateway de este profile con
hermes gateway stopy cierra Desktop desde su menú, no lo minimices. Tampoco dejes una sesión de terminal abierta sobre el mismo profile. - Confirma que está tranquila. Vuelve a ejecutar
hermes doctorsin--fix. Si sigue diciendocannot prove state.db is quiet, algo continúa sujetando la base: búscalo en lugar de forzar. - Haz el checkpoint. Ejecuta
hermes doctor --fix. - Lee el resultado. El éxito imprime un par de cifras con la forma
WAL checkpoint performed (51200K → 176K): tamaño del WAL antes de la fusión, la flecha, y el tamaño después, ambos en kilobytes. - Devuelve los servicios a su sitio. Reinicia el gateway y vuelve a abrir Desktop si lo usas.
Si el paso 3 imprime WAL checkpoint skipped: could not take exclusive ownership of state.db, detrás viene el motivo del guard y la indicación de parar el gateway y reintentar. Eso es el nuevo comportamiento cumpliendo su promesa: sin propiedad exclusiva, no hay checkpoint.
Cómo saber si un escritor activo sigue teniendo la base
El holder scan no lo ejecutas tú; lo ejecuta doctor. Lo que hace se resume en una frase: busca cualquier otro proceso que tenga abierto state.db y solo cuando el escaneo no encuentra ninguno lanza una sonda BEGIN IMMEDIATE para demostrar que la base está realmente tranquila; cualquier caso desconocido por el camino se trata como si hubiera un titular. Esa sonda corre únicamente después de que el escaneo haya descartado a un titular ajeno, así que la comprobación no puede convertirse ella misma en el segundo escritor del que te avisa.
Lo que sí puedes mirar a mano es más simple: hermes gateway status para el gateway, tu monitor de actividad o administrador de tareas para ver si Desktop sigue corriendo, y ninguna sesión de terminal abierta sobre el mismo profile. Cuando los tres están limpios, un checkpoint es seguro.
Qué sigue haciendo --fix y qué no
Sigue haciendo el checkpoint: ejecuta PRAGMA wal_checkpoint(PASSIVE), ahora bajo el guard exclusivo de reparación (_exclusive_repair_db_guard). El guard significa que un proceso que intente abrir la base a mitad de camino es rechazado, en lugar de ser arrastrado al mismo checkpoint.
Lo dice cuando no puede. Sin propiedad exclusiva imprime WAL checkpoint skipped: could not take exclusive ownership of state.db, arrastra el error del guard y la indicación de parar el gateway y reintentar, y mantiene el issue de «no se puede demostrar que state.db esté tranquila» en vez de fingir que la reparación salió bien.
No se pelea con un escritor activo ni repara un state.db ya dañado. Una base que ya se rompió necesita el otro camino: empieza por cómo se cura state.db a sí mismo. Si tu síntoma es database is locked y no corrupción, es otro fallo con otras soluciones: mira las correcciones de bloqueo de state.db.
El resto de hermes doctor, sin alarmarse
Casi todo lo que imprime el chequeo es un estado correcto, y solo un par de líneas merecen atención:
- Un WAL entre 10 MB y 50 MB es informativo. El propio mensaje dice
normal for active sessions. - La advertencia de WAL grande con un escritor activo también dice «esto es normal». Su única exigencia es que el checkpoint espere a que el gateway y Desktop estén detenidos.
- Para compartir tu instalación usa
hermes dump. Es un resumen en texto plano pensado para pegar en un issue o en un chat, sin colores ni formato.
Hay exactamente una situación en la que te toca actuar: no hay titular y el WAL nunca encoge. Ese es el momento de hacer el checkpoint offline de arriba. La lista completa de opciones está en la referencia del comando hermes doctor.
La versión corta
El consejo de un diagnóstico vale lo que valen sus premisas. La línea antigua decía «ejecuta --fix» a los 50 MB sin preguntar nunca si la base estaba tranquila; desde el PR #113055 doctor busca primero un titular y, cuando existe o no puede descartarse, te dice que el WAL grande es normal mientras Desktop o el gateway corren, y que solo hagas checkpoint con ellos detenidos. Esto forma parte del mismo trabajo que el parche de estabilidad v0.21.2, que arregló otra clase de «la herramienta dijo algo que no era del todo cierto». Si vas a hacer un chequeo a una instalación de larga vida, recuerda el orden: detén el gateway y Desktop → hermes doctor --fix → vuelve a arrancarlos.