hermes doctor et un gros WAL : un avertissement enfin honnête
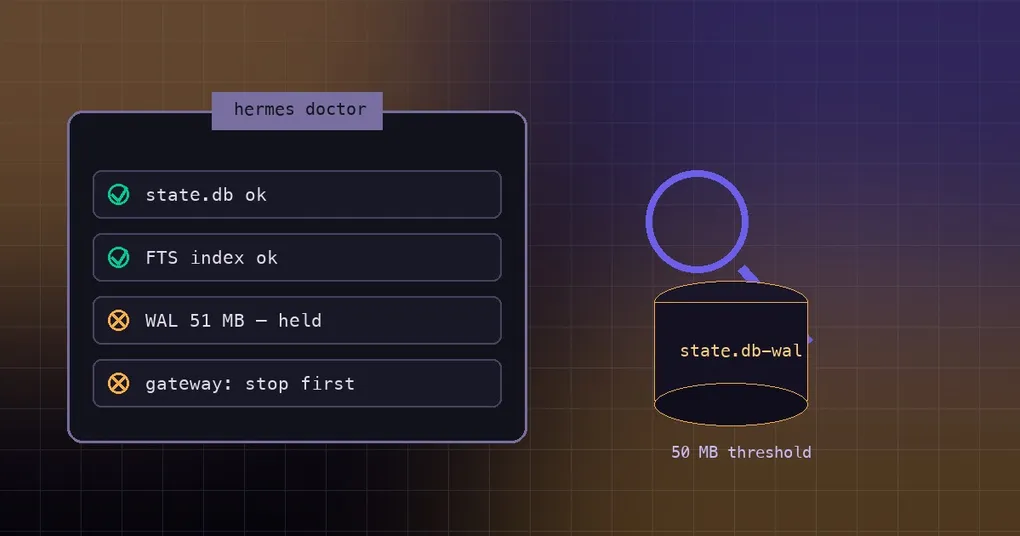
Votre assistant tourne sans interruption depuis des semaines : le gateway ne s’arrête jamais, Desktop reste ouvert en arrière-plan, cron écrit dans la base à intervalles réguliers. Un samedi tranquille, vous faites ce qu’il faut et lancez hermes doctor — et il affiche un avertissement : le fichier WAL est volumineux, lancez hermes doctor --fix pour faire un checkpoint. Vous le faites aussi, l’outil annonce un checkpoint réussi et un constat corrigé, tout paraît propre. Puis vous revenez au travail et la moitié de la liste des sessions a disparu, ou le démarrage suivant échoue directement sur un state.db corrompu. Ce conseil n’avait rien de malveillant : il ignorait simplement que la base était utilisée. Le PR #113055, fusionné le 16 septembre 2026, porte sur cette seule ligne de sortie.
Le symptôme : un diagnostic dont le conseil fait mal
hermes doctor diagnostique les problèmes de configuration et de dépendances, et hermes doctor --fix en est la variante de réparation automatique. La documentation de la CLI décrit l’option en une phrase : tenter les réparations automatiques lorsque c’est possible.
Avant #113055, tout state.db-wal dépassant 50 MB produisait une suggestion inconditionnelle de lancer --fix. Le holder scan — l’étape qui vérifie si un autre processus détient la base — ne tournait qu’à l’intérieur de --fix. C’est là toute la contradiction : le checkpoint exécuté par --fix a besoin d’une base au repos, et avec le gateway ou Desktop en marche, la base est tout sauf au repos. Les fils Discord de l’issue #110054 montrent des utilisateurs qui suivent exactement cette ligne vers --fix alors que le gateway tournait : ils deviennent le second writer, celui sur lequel se déclenche ensuite la protection contre les WAL supprimés, et c’est ainsi que les dommages sur state.db sont signalés.
Ce qu’est un WAL, et quand un gros WAL est normal
WAL (write-ahead log, journal d’écriture anticipée) est un mode de journal de SQLite : les nouvelles écritures sont d’abord ajoutées au fichier state.db-wal, puis fusionnées plus tard dans le state.db principal. Un checkpoint est cette fusion, et il réduit le fichier WAL au passage. Un holder scan est une vérification brève : y a-t-il, à part le processus courant, un autre processus qui a la base ouverte ?
Avec cette conception, voir le WAL grossir est normal. Le gateway, Desktop et cron écrivent en continu, et quand les checkpoints ne surviennent pas assez souvent, le fichier grossit simplement. Doctor surveille exactement deux seuils : au-delà de 10 MB il affiche une ligne d’information qui dit normal for active sessions, et au-delà de 50 MB le constat devient un avertissement. Un WAL de 51 MB sur une installation active peut donc être parfaitement sain. La vraie question n’a jamais été le chiffre sur le disque, mais de savoir si ce WAL peut être fusionné en toute sécurité maintenant.
Ce qui change : le holder scan tourne désormais aussi sur le chemin d’avertissement
_state_db_wal, dans hermes_cli/doctor_state.py, effectue maintenant la vérification du détenteur (hermes_state_repair._live_writer_holds_db, le même wrapper que celui utilisé par _write_health_reason) avant de dire quoi que ce soit d’actionnable. Avec un détenteur présent, ou une base impossible à inspecter :
WAL file is large (51 MB) (normal while Desktop or the gateway is running, or state.db cannot be inspected — checkpoint only with them stopped)
Large WAL file — cannot prove state.db is quiet (stop the profile's gateway first, then run 'hermes doctor --fix' to checkpoint)
La première ligne est le texte d’avertissement de la vérification, la seconde l’issue qu’elle ajoute. Sans détenteur, la formulation change et l’ordre d’arrêt passe avant la suggestion :
WAL file is large (51 MB) (may indicate missed checkpoints)
Large WAL file — stop the profile's gateway, then run 'hermes doctor --fix' to checkpoint
Deux détails de formulation sont délibérés. Un vrai du holder scan signifie « détenu ou non démontrable », jamais « un writer est forcément là » — d’où le message Desktop or the gateway is running or state.db cannot be inspected. Quand la réponse est inconnue, doctor échoue du côté sûr et suppose un writer au lieu d’en affirmer un. Entre 10 MB et 50 MB, la ligne reste WAL file is 12 MB (normal for active sessions). La sémantique de --fix elle-même est inchangée.
La bonne procédure de checkpoint
L’ordre compte plus que les commandes : arrêter les writers, faire le checkpoint, les relancer.
hermes gateway status     # vérifier si le gateway de ce profile tourne
hermes gateway stop       # l'arrêter si c'est le cas
hermes doctor             # toujours sans --fix : voir ce qu'il dit maintenant
hermes doctor --fix # seulement quand il ne signale plus une base non inspectable- Arrêtez les writers. Arrêtez le gateway de ce profile avec
hermes gateway stopet quittez Desktop depuis son menu, sans le réduire. Ne laissez pas non plus de session de terminal ouverte sur le même profile. - Confirmez le repos. Relancez
hermes doctorsans--fix. S’il affiche encorecannot prove state.db is quiet, quelque chose détient toujours la base : cherchez-le au lieu de forcer. - Faites le checkpoint. Lancez
hermes doctor --fix. - Lisez le résultat. En cas de succès, un couple de chiffres apparaît sous la forme
WAL checkpoint performed (51200K → 176K): la taille du WAL avant la fusion, la flèche, puis la taille après, en kilo-octets. - Remettez les services en route. Relancez le gateway et rouvrez Desktop si vous l’utilisez.
Si l’étape 3 affiche WAL checkpoint skipped: could not take exclusive ownership of state.db, la raison donnée par le guard suit, avec l’indication d’arrêter le gateway et de relancer. C’est le nouveau comportement qui tient sa promesse : pas de propriété exclusive, pas de checkpoint.
Comment savoir si un writer actif détient encore la base
Le holder scan n’est pas à lancer à la main, c’est doctor qui s’en charge. Son fonctionnement tient en une phrase : il cherche tout autre processus détenant state.db, et c’est seulement quand le scan n’en trouve aucun qu’il lance une sonde BEGIN IMMEDIATE pour prouver que la base est réellement au repos — tout cas incertain est traité comme un détenteur. Cette sonde ne s’exécute qu’après que le scan a écarté un détenteur étranger : la vérification ne peut donc pas devenir elle-même le second writer contre lequel elle vous met en garde.
Ce que vous pouvez vérifier vous-même est plus simple : hermes gateway status pour le gateway, votre moniteur d’activité pour un Desktop encore lancé, et aucune session de terminal ouverte sur le même profile. Quand les trois sont clairs, un checkpoint est sans risque.
Ce que --fix fait encore, et ce qu’il ne fait pas
Il fait toujours le checkpoint : il exécute PRAGMA wal_checkpoint(PASSIVE), désormais sous le guard de réparation exclusive (_exclusive_repair_db_guard). Ce guard signifie qu’un processus qui tente d’ouvrir la base entre-temps est refusé plutôt qu’entraîné dans le même checkpoint.
Il le dit quand il ne peut pas. Sans propriété exclusive il affiche WAL checkpoint skipped: could not take exclusive ownership of state.db, avec l’erreur du guard et l’indication d’arrêter le gateway puis de relancer, et il conserve l’issue « impossible de prouver que state.db est au repos » au lieu de faire croire à une réparation réussie.
Il ne se bat pas contre un writer actif et il ne répare pas un state.db déjà endommagé. Une base déjà abîmée relève de l’autre chemin : commencez par comment state.db se répare lui-même. Si votre symptôme est database is locked et non la corruption, c’est un autre échec avec d’autres correctifs — voir les correctifs de verrouillage de state.db.
Le reste de hermes doctor, sans paniquer
Presque tout ce qu’affiche le contrôle de santé est un état conforme, et seules quelques lignes méritent votre attention :
- Un WAL entre 10 MB et 50 MB est une information. Le message dit lui-même
normal for active sessions. - L’avertissement de gros WAL avec un writer actif dit aussi « c’est normal ». Son unique exigence : que le checkpoint attende que le gateway et Desktop soient arrêtés.
- Pour partager votre installation, utilisez
hermes dump. C’est un résumé en texte brut conçu pour être collé dans une issue ou un chat, sans couleurs ni mise en forme.
Une seule situation demande d’agir : aucun détenteur, et un WAL qui ne diminue jamais. C’est là que le checkpoint hors ligne ci-dessus vaut la peine. La liste complète des options se trouve dans la référence de la commande hermes doctor.
En résumé
Le conseil d’un diagnostic ne vaut que par ses prémisses. L’ancienne ligne disait « lancez --fix » à 50 MB sans jamais demander si la base était au repos ; depuis le PR #113055, doctor cherche d’abord un détenteur et, lorsqu’il en existe un ou qu’on ne peut pas l’exclure, vous dit que le gros WAL est normal tant que Desktop ou le gateway tourne — et qu’il ne faut faire un checkpoint qu’avec eux arrêtés. Cela relève du même train de travaux que le correctif de stabilité v0.21.2, qui a réglé une autre catégorie de « l’outil a dit quelque chose d’à peu près vrai ». Si vous vous apprêtez à contrôler une installation qui tourne depuis longtemps, retenez simplement l’ordre : arrêter le gateway et Desktop → hermes doctor --fix → les redémarrer.