Telegram 断线重连后消息凭空消失:这一轮把"冲突期丢消息"修掉了
你在外面,掏出手机给家里的 Hermes 发了一条消息:“把那个备份脚本重跑一遍。” 屏幕上没有已读,也没有回复。两分钟后再发一条,还是没有。你以为是机器卡了,回家打开日志,看到几行 409 Conflict,然后一切正常——只是那两条消息再也不会被处理了。
这就是 Long Polling 的老毛病:两个进程抢同一个 bot 的 getUpdates,Telegram 只允许一个赢,另一个收到 409。Hermes 早就会重试,问题出在重试时顺手做的那件事。
先分清三种“连不上”
Telegram 这一侧的故障,听起来都像“网络不好”,实际是三条完全不同的路径,修法也完全不同:
- 冲突(409):另一个 poller 正握着这个 bot 的
getUpdates会话。常见来源是同一台机器上跑了两份网关、旧进程没死干净,或者两台机器配了同一个 bot token。 - 瞬时错误(502 之类):Bot API 抖了一下,一次
getUpdates失败。 - “假活”轮询:
getUpdates每次都说“成功”,但队列里的消息就是不交出来。
11 月 9 日合并的这批修复(PR #150983,附带 #151077)分别动了这三条路。先说最要命的冲突。
409 时代价:它把队列清空了
冲突恢复的代码里有这么一步:重启轮询,并带上 drop_pending_updates=True。
这个参数的语义很容易被误读。它不会“结束”另一个 poller 的会话——它做的是让 Telegram 把服务端排队的更新全部丢掉。于是冲突发生的那几十秒里,你发的消息就停在那个队列里,等恢复时被一次性清空。没有报错,没有日志,没有重试:消息就这么没了。
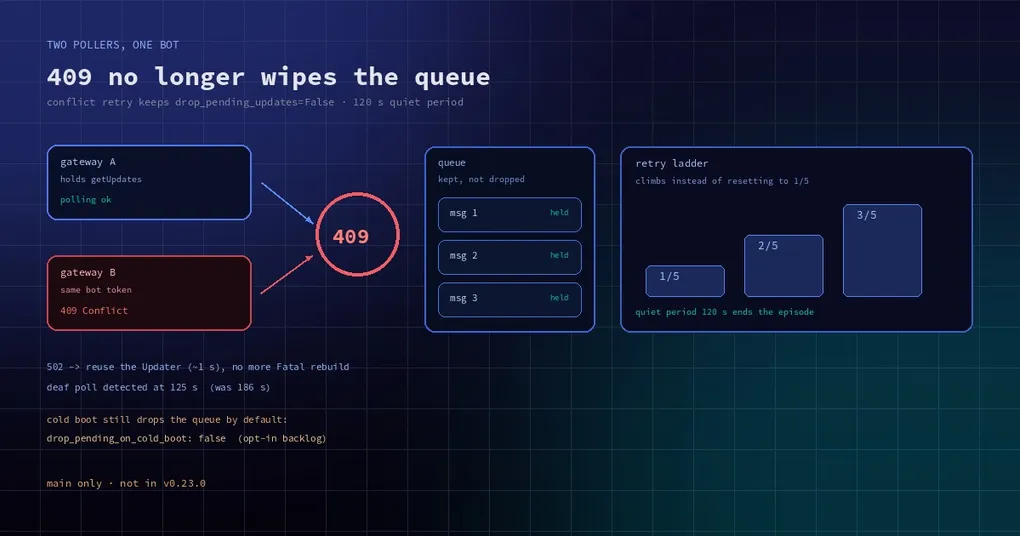
更糟的是重试计数。冲突恢复的逻辑里有五次重试的阶梯,日志里会打 (1/5)、(2/5)。实测发现三次冲突打出来的全是 (1/5)——阶梯根本没爬。原因有两个,都在同一处:恢复标记在 start_polling() 一返回就被清掉了,而那时 PTB 的后台 getUpdates 还没动静;更麻烦的是,在 409 风暴中间,getUpdates 偶尔也会成功一次,于是计数被重置回起点。所以“冲突持续多久,就重试多久”这个设计从来没真正生效过。
现在:队列保住,阶梯真的会爬
修复后的行为,实测对比很清楚。同一个场景:竞争 poller 连发三次 409,每次冲突期间各排一条私聊消息。
| 场景 | 修复前 | 修复后 |
|---|---|---|
| 三次 409,冲突期各一条私聊 | 日志三次 (1/5),四次 deleteWebhook(drop_pending_updates=true),第一条私聊永远没有回复 |
(1/5) → (2/5) → (3/5),只有冷启动那一次清队列,三条私聊全部回复 |
两处改动:
- 冲突恢复的重启改成
drop_pending_updates=False,和网络错误那条阶梯保持一致。冷启动时该清还是清,冲突时不再清。 - 一次冲突什么时候算结束,改成一个 120 秒的静默期(
_POLLING_CONFLICT_QUIET_PERIOD = 120.0)。这个数字比任何一场冲突风暴内部的间隔都长,所以中间偶尔成功的那一次 getUpdates 不会再把计数打回 1/5。
换句话说,以前的行为是“一有 409 就重置,然后清空队列”,现在是“把这一轮冲突当成一个持续的事件,队列留着,退避时间一级一级往上走”。文档里也写进了这一条:冲突恢复会保留队列,冲突期间发的消息会在轮询恢复后送达。
502 不该被当成致命错误
第二条路是瞬时错误。以前一次 502 Bad Gateway 会让恢复流程等在 15 秒的截止时间上,然后打出一行 updater.stop() did not finish before the network-recovery deadline,接着把整条错误升级成 Fatal telegram adapter error——适配器被整个重建。为了一次几百毫秒的抖动,付出一次完整重建的代价。
现在的做法是复用同一个 Updater 重启,大约一秒就回来了:没有 fatal,没有截止时间那行日志,下一条私聊照常回复。
“假活”检测:186 秒变成 125 秒
第三条路最阴。getUpdates 每次往返都成功,但队列里的消息就是不上交——网络层看起来一切正常。Hermes 有一个心跳探针专门盯这个:连续两次探针发现“队列里有更新但没被消费”,就判定卡住并重启轮询。
以前从消息进队列到重启是 186 秒,现在是 125 秒,而且能在同一个清醒窗口内完成。对一台会休眠的笔记本来说,这个差别很实际:以前中间睡一觉,计时就断了,永远凑不满两次连续探针。
冷启动是另一回事,别搞混
冲突恢复保留队列,但冷启动默认仍然清队列。这是有意的:常开的服务器重启意味着“清干净重来”,服务端积压的旧消息按陈旧处理。
如果你的机器是笔记本、晚上会关机,那些在你关机时发来的消息就躺在 Telegram 的队列里,下一次启动时被直接丢掉——静默地,无日志。要让它们进来,得显式打开:
platforms:
  telegram:
    extra:
      drop_pending_on_cold_boot: false
打开之后有代价:崩溃重启时,一条被部分处理过的更新可能会重投一次。Telegram 的 offset 通常能挡住这种情况,但长时间离线期间发的时效性命令,确实会在启动时被执行。这是你要自己权衡的取舍。
还有一个更安静的坑:没处理的消息被“记账”了
这批里还有一条(PR #151077),症状更隐蔽:某些 Hermes 根本不处理的更新类型——比如一个 🎲 骰子消息——被悄悄标记成“已完成”。标记的后果是 Telegram 认为这条消息已经送达,不再重投,而日志里一个字都没有。
现在的行为是:没被任何处理器接手的更新,不打收据,并打一行 INFO,只记录字段名、不记录内容:
Update 1000 matched no core handler; not receipted (fields: message(chat,date,dice,from,message_id), update_id)顺带修掉了关闭流程里的一个边角:以前停止适配器可能在释放“已处理更新”记录之前就结束,现在会等这些释放完成;一个在排队等待时被取消的更新,它的协程也会被正确关闭,不再泄漏。
你自己能做的两件事
第一,确认没有两个进程抢同一个 bot。hermes gateway list 会列出所有 profile 和各自网关是否在跑、pid 是多少,一眼就能看出是不是多开了一份。如果你有多个 profile 各配一个 bot,hermes gateway migrate --dry-run 的预检会明确报出重复的 bot token——这正是 409 最常见的来源。
hermes gateway list
hermes gateway migrate --dry-run
第二,别把 409 当成“Telegram 抽风”。它几乎总是本地配置问题:同一个 token 被用了两次。修掉重复的那一份,比调任何超时参数都管用。
这批改动什么时候能用上
PR #150983 和 #151077 都是 2026 年 11 月 9 日合并进 main 的。v0.23.0 是 11 月 6 日发的,所以这些改动不在 v0.23.0 里,要等下一个正式版本。
如果你现在正被丢消息折磨,有两个临时办法:一是把重复的网关关掉(治本),二是把 drop_pending_on_cold_boot 显式设成 false,至少别让重启吞掉积压——注意上面说的重投风险。
想了解 Hermes 判断“网关是不是哑了”的另一套机制,可以看我们之前写的静默断连与心跳;Telegram 那边偏交互的配置(内联按钮、选择器)在这篇指南里。
一句话总结
三条故障路径,三种坏法:冲突清队列(消息直接没)、瞬时错误当致命(整条适配器重建)、假活轮询发现太慢(三分钟才反应)。这次分别改成保队列 + 真爬阶梯、复用 Updater、两分钟内判定。它们都还只在 main 上,但对任何把 Hermes 挂在 Telegram 上的人来说,这就是“消息到底丢没丢”的答案。
更新(2026-11-10):这批改动已随 v0.23.1 发布(2026-11-09),
hermes update升级即可用。上文「不在 v0.23.0 里」仍然成立,v0.23.1 把缺口补上了。