Mensajes que desaparecen tras reconectar: el arreglo del conflicto de Telegram que deja de perder tu cola
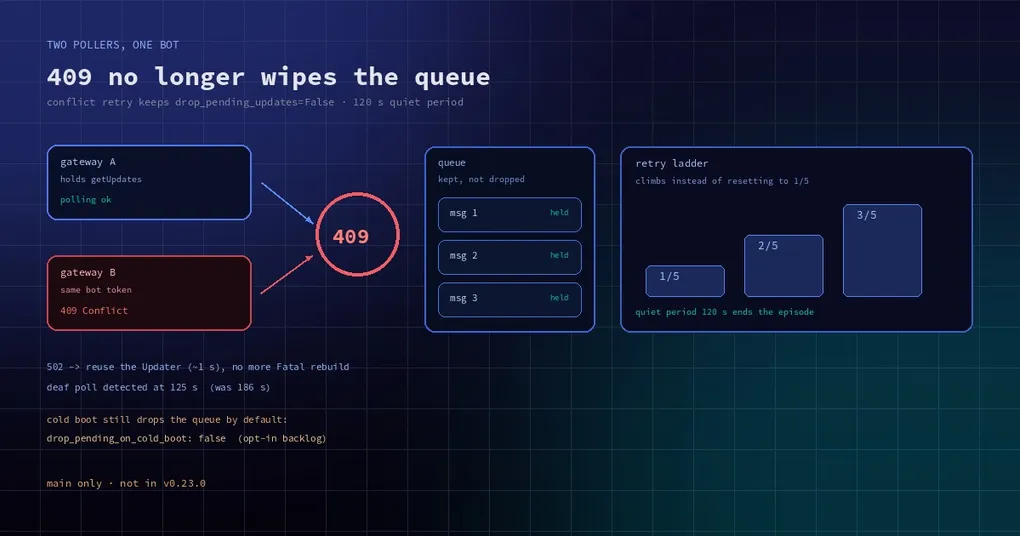
Estás fuera de casa, así que le escribes al equipo de Hermes que tienes en casa: «vuelve a ejecutar ese script de backup». Sin acuse de lectura, sin respuesta. Dos minutos después lo mandas otra vez. Nada. Llegas a casa, abres el log y encuentras unas cuantas líneas 409 Conflict y después la normalidad, salvo que esos dos mensajes no se procesarán jamás.
Es el viejo problema del Long Polling: dos procesos compiten por el getUpdates del mismo bot, Telegram deja ganar a exactamente uno, y el otro recibe un 409. Hermes ya reintentaba. El problema era lo que hacía mientras reintentaba.
Tres fallos distintos que parecen «la red»
Los fallos del lado de Telegram suenan parecido y se comportan de forma totalmente distinta. Hay tres caminos, y cada uno necesita un arreglo diferente:
- Conflicto (409): otro poller retiene la session
getUpdatesde este bot. Normalmente dos gateways en la misma máquina, un proceso viejo que nunca terminó, o dos máquinas configuradas con el mismo bot token. - Errores transitorios (un 502 y compañía): una llamada
getUpdatesfalló. - Un poll «sano» que nunca entrega: cada ida y vuelta reporta éxito, y los mensajes en cola siguen sin llegar.
El lote fusionado el 9 de noviembre (PR #150983, más el #151077) toca los tres. Empieza por el conflicto, porque ahí estaba el daño.
Lo que costaba un 409: la cola
La recuperación de conflicto reiniciaba el polling con drop_pending_updates=True.
Ese parámetro se malinterpreta con facilidad. No termina la session del otro poller: le dice a Telegram que tire a la basura cada update que haya en la cola del lado del servidor. Así que los mensajes que enviaste durante esos pocos segundos se borraban al recuperarse. Sin error, sin línea de log, sin reintento. Simplemente desaparecidos.
El contador de reintentos era peor. La recuperación de conflicto tiene una escalera de cinco intentos que registra (1/5), (2/5) y así. En una prueba en vivo, tres conflictos distintos registraron todos (1/5): la escalera nunca subía. Dos causas, ambas en el mismo sitio. El marcador de recuperación se borraba en un bloque finally en cuanto start_polling() volvía, antes de que el getUpdates en segundo plano de PTB avanzara nada. Y durante una tormenta de 409, getUpdates acierta de vez en cuando entre conflicto y conflicto, lo que reiniciaba la cuenta a uno. El diseño —«seguir reintentando mientras dure el conflicto»— nunca llegó a ejecutarse.
Hoy: la cola sobrevive y la escalera sube
El antes y el después es concreto. El mismo escenario en las dos ejecuciones: un poller competidor produce tres 409, con un mensaje directo en cola durante cada conflicto.
| Escenario | Antes | Después |
|---|---|---|
| Tres 409, un DM en cola durante cada uno | el log muestra (1/5) tres veces, cuatro llamadas deleteWebhook(drop_pending_updates=true), el DM 1 nunca se responde |
(1/5) → (2/5) → (3/5), solo el drop de arranque en frío, los tres DM respondidos |
Dos cambios:
- La recuperación de conflicto ahora reinicia con
drop_pending_updates=False, igual que la escalera de errores de red. Un arranque en frío sigue vaciando la cola; un conflicto ya no. - Cuándo termina un episodio de conflicto lo gobierna ahora un periodo de calma de 120 segundos (
_POLLING_CONFLICT_QUIET_PERIOD = 120.0). Es más largo que cualquier hueco dentro de una misma tormenta, así que ungetUpdatesexitoso ocasional ya no reinicia la cuenta a1/5.
En otras palabras: el camino viejo era «veo un 409, reinicio, borro la cola». El nuevo es «trata esto como un único episodio en curso, conserva la cola y retrocede paso a paso». La documentación ya lo dice sin rodeos: la recuperación de conflicto preserva la cola, y los mensajes enviados durante un 409 se entregan en cuanto el polling se reanuda.
Un 502 no es un error fatal
El segundo camino son los errores transitorios. Un solo 502 Bad Gateway hacía que la recuperación esperara un plazo de 15 segundos, luego registrara updater.stop() did not finish before the network-recovery deadline, y después escalara todo a Fatal telegram adapter error y reconstruyera el adaptador desde cero. Un parpadeo de medio segundo costaba una reconstrucción completa.
Ahora el mismo Updater se reinicia en aproximadamente un segundo: sin línea fatal, sin línea de plazo, y el siguiente DM se responde con normalidad.
Polls «sanos»: de 186 segundos a 125
El tercer camino es el más traicionero. getUpdates sigue teniendo éxito, pero los mensajes en cola nunca se entregan: la capa de red parece perfecta. Una sonda de heartbeat vigila esto: dos sondas consecutivas que ven «updates en cola pero sin consumir» y declara el poll atascado y lo reinicia.
Antes, el hueco entre la llegada del mensaje y el reinicio era de 186 segundos. Ahora es de 125, y cabe dentro de una sola ventana de actividad. En un portátil que hiberna, esa diferencia es práctica: el temporizador viejo podía interrumpirse por el sueño y no llegar a acumular dos sondas consecutivas.
El arranque en frío es una decisión aparte
La recuperación de conflicto ahora conserva la cola, pero un arranque en frío sigue descartándola por defecto. Es deliberado: en un servidor siempre encendido, un reinicio significa «limpiar», y el backlog se trata como obsoleto.
Si tu host es un portátil que se apaga por la noche, los mensajes enviados mientras estaba apagado se quedan en la cola del Bot API de Telegram y se descartan en el siguiente arranque: en silencio, sin línea de log. Para recibir ese backlog en orden:
platforms:
  telegram:
    extra:
      drop_pending_on_cold_boot: false
Tiene un costo. Después de un crash, una cola preservada puede reentregar un update que la instancia caída había procesado a medias. El offset de Telegram suele evitarlo, pero los comandos sensibles al tiempo enviados durante una caída larga se ejecutarán al arrancar. Ese trade-off es tuyo.
El bug más silencioso: se estaba acusando recibo de updates sin manejar
Hay otra corrección en este lote (PR #151077) con un síntoma más sutil. Algunos tipos de update que Hermes no maneja —un mensaje de dado 🎲, por ejemplo— se marcaban calladamente como «hechos». Ese acuse de recibo le decía a Telegram que el update se había entregado, así que dejaba de reenviarlo, y en el log no aparecía absolutamente nada.
Ahora un update que ningún handler reclama no recibe acuse, y se registra una línea INFO solo con nombres de campo, nunca con contenido:
Update 1000 matched no core handler; not receipted (fields: message(chat,date,dice,from,message_id), update_id)El mismo PR arregla un borde de apagado: detener el adaptador podía terminar antes de que se liberaran sus registros de updates manejados. Ahora espera esas liberaciones, y una corrutina cancelada mientras espera su turno se cierra en lugar de filtrarse.
Dos cosas que puedes hacer tú
Primero, asegúrate de que dos procesos no se peleen por un mismo bot. hermes gateway list muestra todos los profiles con si su gateway está corriendo y el pid, que es exactamente cómo se detecta un duplicado. Si corres varios profiles con sus propios bots, hermes gateway migrate --dry-run ejecuta una comprobación previa que reporta bot tokens duplicados, la fuente más común de 409.
hermes gateway list
hermes gateway migrate --dry-run
Segundo, deja de leer 409 como «Telegram está inestable». Casi siempre es configuración local: un token usado dos veces. Eliminar el duplicado hace más que cualquier ajuste de timeout.
Cuándo puedes usar esto
Los PR #150983 y #151077 entraron los dos en main el 9 de noviembre de 2026. La v0.23.0 salió el 6 de noviembre, así que estos arreglos no están en la v0.23.0; llegan con la próxima release estable.
Actualización (10/11/2026): estos cambios ya salieron en la v0.23.1 (9 de noviembre): basta con
hermes update. Lo de «no está en v0.23.0» sigue siendo cierto; la v0.23.1 cierra la brecha.
Si estás perdiendo mensajes ahora mismo, hay dos parches: mata el gateway duplicado (el arreglo de verdad) y pon drop_pending_on_cold_boot: false para que los reinicios dejen de tragarse el backlog, teniendo en cuenta la advertencia sobre reentrega de más arriba.
Para la otra mitad del cuadro de fiabilidad —cómo decide Hermes que un gateway se ha quedado callado— mira las desconexiones silenciosas y el heartbeat. Para la configuración de Telegram del lado de la interacción (botones inline, pickers), mira esta guía.
La versión corta
Tres caminos de fallo, tres modos de fallo: un conflicto vacía la cola (mensajes perdidos sin más), un error transitorio se trata como fatal (reconstrucción completa del adaptador), un poll de aspecto sano se detecta demasiado tarde (tres minutos). Los arreglos conservan la cola y suben la escalera, reutilizan el Updater y bajan la detección por debajo de los dos minutos. Todo esto hoy es solo de main, pero para quien corre Hermes en Telegram es la respuesta a «¿se perdió de verdad mi mensaje?».