Nachrichten verschwinden nach einem Reconnect: der Telegram-Conflict-Fix, der deine Queue nicht mehr verliert
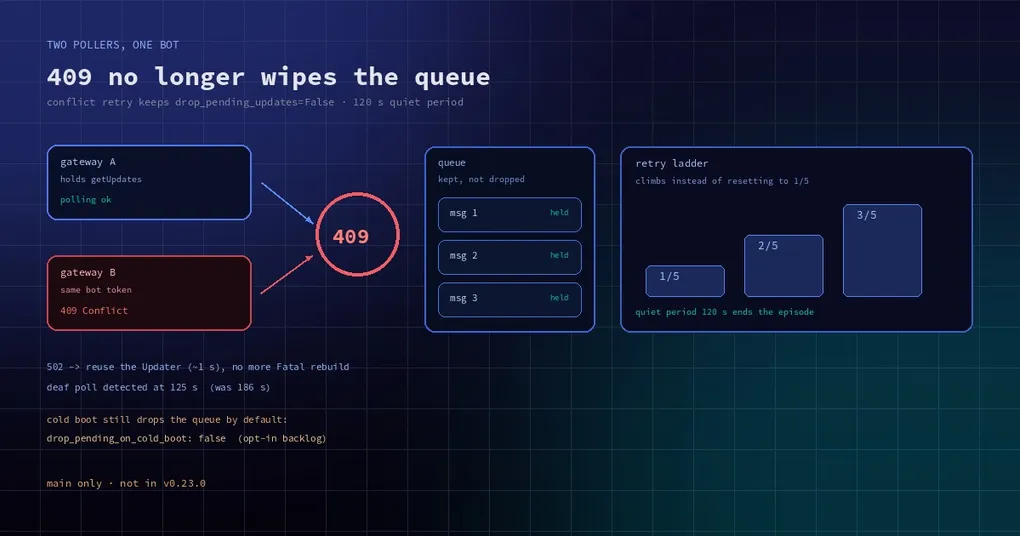
Du bist außer Haus und schreibst der Hermes-Box zu Hause: „Führ das Backup-Skript nochmal aus.“ Kein Read-Receipt, keine Antwort. Zwei Minuten später schickst du es erneut. Immer noch nichts. Du kommst heim, öffnest das Log und findest ein paar 409 Conflict-Zeilen und dann Business as usual — außer dass diese beiden Nachrichten nie verarbeitet werden.
Das ist das alte Long-Polling-Problem: Zwei Prozesse kämpfen um das getUpdates desselben Bots, Telegram lässt genau einen gewinnen, und der andere bekommt ein 409. Hermes versuchte es bereits erneut. Das Problem war, was es beim Wiederholen tat.
Drei verschiedene Fehler, die alle wie „das Netzwerk“ aussehen
Fehler auf der Telegram-Seite klingen ähnlich und verhalten sich völlig anders. Es gibt drei Pfade, und jeder braucht einen anderen Fix:
- Conflict (409): Ein anderer Poller hält die
getUpdates-session dieses Bots. Meist zwei gateways auf einer Maschine, ein alter Prozess, der nie beendet wurde, oder zwei Maschinen mit demselben Bot-token. - Transiente Fehler (ein 502 und Verwandte): Ein
getUpdates-Aufruf ist fehlgeschlagen. - Ein „gesunder“ Poll, der nie liefert: Jeder Roundtrip meldet Erfolg, und die in der Queue liegenden Nachrichten kommen trotzdem nie an.
Das am 9. November gemergte Batch (PR #150983, plus #151077) berührt alle drei. Fang mit dem Conflict an, denn dort lag der Schaden.
Was ein 409 früher gekostet hat: die Queue
Die Conflict-Recovery startete das Polling mit drop_pending_updates=True neu.
Dieser Parameter ist leicht falsch zu lesen. Er beendet nicht die session des anderen Pollers — er sagt Telegram, jedes Update wegzuwerfen, das in der serverseitigen Queue liegt. Nachrichten, die du während dieser paar Dutzend Sekunden geschickt hast, wurden bei der Recovery also gelöscht. Kein Fehler, keine Log-Zeile, kein Retry. Einfach weg.
Der Retry-Zähler war schlimmer. Die Conflict-Recovery hat eine Leiter mit fünf Versuchen, die (1/5), (2/5) und so weiter loggt. In einer Live-Probe loggten drei getrennte Conflicts alle (1/5): Die Leiter stieg nie. Zwei Ursachen, beide an derselben Stelle. Der Recovery-Marker wurde in einem finally-Block gelöscht, sobald start_polling() zurückkehrte, bevor PTBs Hintergrund-getUpdates irgendeinen Fortschritt gemacht hatte. Und während eines 409-Sturms gelingt getUpdates gelegentlich zwischen den Conflicts, was den Zähler auf eins zurücksetzte. Das Design — „so lange weiter versuchen, wie der Conflict anhält“ — lief nie wirklich.
Heute: die Queue überlebt, und die Leiter steigt
Das Vorher/Nachher ist konkret. Dieselbe Szene in beiden Läufen: Ein konkurrierender Poller erzeugt drei 409s, mit je einer DM, die während jedes Conflicts in die Queue geht.
| Szenario | Vorher | Nachher |
|---|---|---|
| Drei 409s, je eine DM während jedes Conflicts in der Queue | Log zeigt dreimal (1/5), vier deleteWebhook(drop_pending_updates=true)-Aufrufe, DM 1 nie beantwortet |
(1/5) → (2/5) → (3/5), nur der Cold-Boot-Drop, alle drei DMs beantwortet |
Zwei Änderungen:
- Die Conflict-Recovery startet jetzt mit
drop_pending_updates=False, passend zur Leiter für Netzwerkfehler. Ein Cold Boot leert die Queue weiterhin; ein Conflict nicht mehr. - Wann eine Conflict-Episode endet, regelt jetzt eine 120-Sekunden-Quiet-Period (
_POLLING_CONFLICT_QUIET_PERIOD = 120.0). Die ist länger als jede Lücke innerhalb eines einzelnen Sturms, ein gelegentlich erfolgreichesgetUpdatessetzt den Zähler also nicht mehr auf1/5zurück.
Mit anderen Worten: Der alte Pfad war „409 sehen, zurücksetzen, Queue plätten.“ Der neue Pfad ist „das als eine laufende Episode behandeln, die Queue behalten und schrittweise zurückweichen.“ Die Docs sagen es jetzt klar: Conflict-Recovery erhält die Queue, und Nachrichten, die während eines 409 gesendet wurden, werden zugestellt, sobald das Polling wieder läuft.
Ein 502 ist kein fataler Fehler
Der zweite Pfad sind transiente Fehler. Ein 502 Bad Gateway ließ die Recovery früher eine 15-Sekunden-Deadline abwarten, dann updater.stop() did not finish before the network-recovery deadline loggen, dann das Ganze zu Fatal telegram adapter error eskalieren und den Adapter von Grund auf neu bauen. Ein Halbsekunden-Aussetzer kostete einen kompletten Rebuild.
Jetzt wird derselbe Updater in etwa einer Sekunde neu gestartet: keine fatal-Zeile, keine Deadline-Zeile, und die nächste DM wird normal beantwortet.
„Gesunde“ Polls: 186 Sekunden runter auf 125
Der dritte Pfad ist der heimtückischste. getUpdates gelingt weiter, aber die in der Queue liegenden Nachrichten werden nie übergeben — die Netzwerkschicht sieht perfekt aus. Eine Heartbeat-Probe wacht darüber: Zwei aufeinanderfolgende Probes, die „Updates in der Queue, aber nicht konsumiert“ sehen, und sie erklärt den Poll für festgefahren und startet ihn neu.
Vorher lag die Spanne von Nachrichtenankunft bis Neustart bei 186 Sekunden. Jetzt sind es 125, und das passt in ein einziges Wachfenster. Auf einem Laptop, der döst, ist dieser Unterschied praktisch: Der alte Timer konnte vom Sleep unterbrochen werden und nie zwei aufeinanderfolgende Probes ansammeln.
Cold Boot ist eine eigene Entscheidung
Die Conflict-Recovery behält jetzt die Queue, aber ein Cold Boot verwirft sie standardmäßig weiterhin. Das ist Absicht: Für einen Always-on-Server heißt ein Neustart „aufräumen“, und der Backlog gilt als veraltet.
Wenn dein Host ein Laptop ist, der über Nacht herunterfährt, liegen Nachrichten, die während der Aus-Zeit gesendet wurden, in Telegrams Bot-API-Queue und werden beim nächsten Boot verworfen — still, ohne Log-Zeile. Um diesen Backlog in Reihenfolge zu bekommen:
platforms:
  telegram:
    extra:
      drop_pending_on_cold_boot: false
Das hat einen Preis. Nach einem Crash kann eine erhaltene Queue ein Update erneut zustellen, das die abgestürzte Instanz teilweise verarbeitet hatte. Telegrams Offset verhindert das meist, aber zeitkritische Befehle, die während eines langen Ausfalls gesendet wurden, laufen beim Boot. Diesen Trade-off musst du selbst machen.
Der leisere Bug: unbehandelte Updates wurden quittiert
Ein weiterer Fix in diesem Batch (PR #151077) hat ein subtileres Symptom. Einige Update-Typen, die Hermes nicht behandelt — eine 🎲-Würfel-Nachricht zum Beispiel — wurden still als „done“ markiert. Diese Quittung sagte Telegram, das Update sei zugestellt, also hörte es auf, es erneut zuzustellen, und im Log erschien nichts.
Jetzt wird ein Update, das kein Handler beansprucht, nicht quittiert, und es loggt eine INFO-Zeile nur mit Feldnamen, nie mit Inhalt:
Update 1000 matched no core handler; not receipted (fields: message(chat,date,dice,from,message_id), update_id)Derselbe PR behebt eine Shutdown-Kante: Das Stoppen des Adapters konnte fertig sein, bevor seine Handled-Update-Records freigegeben waren. Jetzt wartet es auf diese Freigaben, und eine Coroutine, die beim Warten auf ihren Turn abgebrochen wird, wird geschlossen statt zu leaken.
Zwei Dinge, die du selbst tun kannst
Erstens: Stell sicher, dass nicht zwei Prozesse um einen Bot kämpfen. hermes gateway list zeigt jedes profile mit der Angabe, ob sein gateway läuft, und der pid — genau so erkennst du ein Duplikat. Wenn du mehrere profile mit eigenen Bots fährst, führt hermes gateway migrate --dry-run einen Preflight aus, der doppelte Bot-tokens meldet — die häufigste Quelle von 409s.
hermes gateway list
hermes gateway migrate --dry-run
Zweitens: Hör auf, 409 als „Telegram ist flaky“ zu lesen. Es ist fast immer lokale Konfiguration: ein token, zweimal verwendet. Das Duplikat zu entfernen bringt mehr als jede Timeout-Anpassung.
Wann du das nutzen kannst
Die PRs #150983 und #151077 wurden beide am 9. November 2026 nach main gemergt. v0.23.0 ging am 6. November raus, diese Fixes sind also nicht in v0.23.0; sie kommen mit dem nächsten stabilen Release.
Update (10.11.2026): Diese Änderungen sind mit v0.23.1 (9. November) erschienen – ein
hermes updategenügt. Die Aussage „nicht in v0.23.0“ oben stimmt weiterhin; v0.23.1 schließt die Lücke.
Wenn du gerade Nachrichten verlierst, gibt es zwei Stopgaps: das doppelte gateway killen (der echte Fix) und drop_pending_on_cold_boot: false setzen, damit Neustarts den Backlog nicht mehr schlucken — den Redelivery-Vorbehalt oben im Kopf.
Für die andere Hälfte des Zuverlässigkeitsbilds — wie Hermes entscheidet, dass ein gateway still geworden ist — siehe silent disconnects und den Heartbeat. Für das Telegram-Setup auf der Interaktionsseite (Inline-Buttons, Picker) siehe diesen Guide.
Die Kurzfassung
Drei Fehlerpfade, drei Fehlermodi: Ein Conflict plättet die Queue (Nachrichten endgültig verloren), ein transienter Fehler wird als fatal behandelt (kompletter Adapter-Rebuild), ein gesund aussehender Poll wird zu spät erkannt (drei Minuten). Die Fixes behalten die Queue und steigen die Leiter, verwenden den Updater wieder und drücken die Erkennung unter zwei Minuten. Alles davon ist heute main-only, aber für jeden, der Hermes auf Telegram fährt, ist das die Antwort auf „ist meine Nachricht wirklich verloren gegangen?“