Des messages qui disparaissent après une reconnexion : le correctif Telegram qui cesse de perdre votre file
Vous êtes sorti de chez vous, alors vous écrivez à la machine Hermes restée à la maison : « relance ce script de sauvegarde ». Pas d’accusé de lecture, pas de réponse. Deux minutes plus tard, vous renvoyez le message. Toujours rien. Vous rentrez, vous ouvrez le log, et vous trouvez quelques lignes 409 Conflict puis le cours normal des choses — sauf que ces deux messages ne seront jamais traités.
C’est le vieux problème du Long Polling : deux processus se disputent le getUpdates du même bot, Telegram n’en laisse gagner qu’un, et l’autre reçoit un 409. Hermes réessayait déjà. Le problème, c’était ce qu’il faisait pendant qu’il réessayait.
Trois pannes différentes qui ressemblent toutes au « réseau »
Les pannes côté Telegram se ressemblent à l’oreille et se comportent de façon totalement différente. Il y a trois chemins, et chacun demande un correctif distinct :
- Conflit (409) : un autre poller détient la session
getUpdatesde ce bot. En général deux gateways sur la même machine, un vieux processus qui n’est jamais sorti, ou deux machines configurées avec le même token de bot. - Erreurs transitoires (un 502 et compagnie) : un appel
getUpdatesa échoué. - Un poll « sain » qui ne livre jamais rien : chaque aller-retour rapporte un succès, et les messages en file n’arrivent toujours pas.
La série fusionnée le 9 novembre (PR #150983, plus #151077) touche les trois. Commençons par le conflit, parce que c’est là que les dégâts se produisaient.
Ce que coûtait un 409 : la file
La récupération de conflit redémarrait le polling avec drop_pending_updates=True.
Ce paramètre se lit facilement de travers. Il ne met pas fin à la session de l’autre poller — il demande à Telegram de jeter tous les updates en attente dans la file côté serveur. Les messages envoyés pendant ces quelques dizaines de secondes étaient donc effacés au moment de la récupération. Pas d’erreur, pas de ligne de log, pas de nouvelle tentative. Simplement disparus.
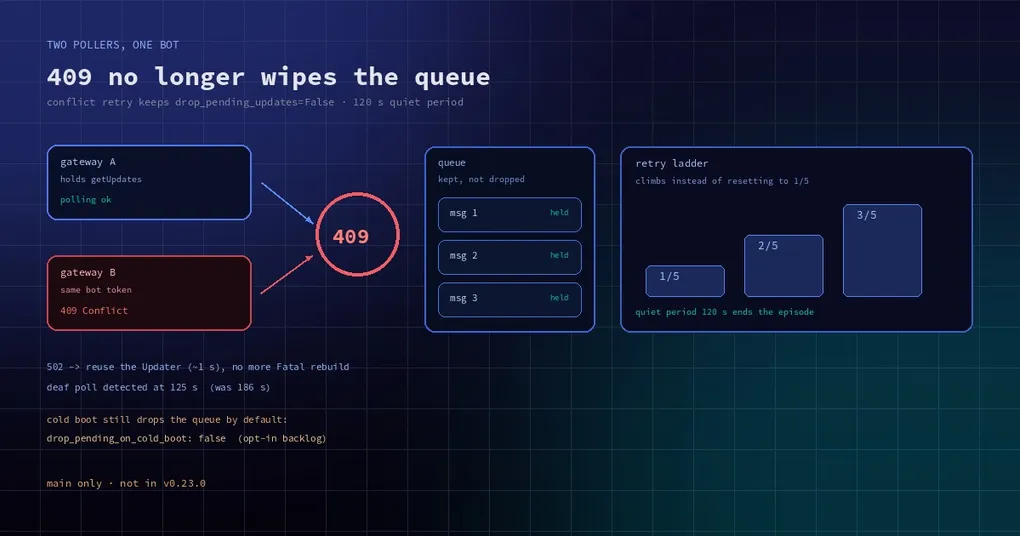
Le compteur de tentatives était pire. La récupération de conflit dispose d’une échelle de cinq essais qui journalise (1/5), (2/5), etc. Lors d’une sonde en conditions réelles, trois conflits distincts ont tous journalisé (1/5) : l’échelle ne montait jamais. Deux causes, au même endroit. Le marqueur de récupération était effacé dans un bloc finally dès que start_polling() rendait la main, avant que le getUpdates d’arrière-plan de PTB n’ait progressé. Et pendant une tempête de 409, getUpdates réussit parfois entre deux conflits, ce qui remettait le compteur à un. Le design — « réessayer tant que le conflit dure » — ne s’exécutait donc jamais vraiment.
Aujourd’hui : la file survit, et l’échelle monte
Le avant/après est concret. Même scénario dans les deux exécutions : un poller concurrent produit trois 409, avec un message direct mis en file pendant chaque conflit.
| Scénario | Avant | Après |
|---|---|---|
| Trois 409, un DM en file pendant chacun | le log affiche (1/5) trois fois, quatre appels deleteWebhook(drop_pending_updates=true), le DM 1 jamais répondu |
(1/5) → (2/5) → (3/5), seul le drop du démarrage à froid, les trois DM répondus |
Deux changements :
- La récupération de conflit redémarre maintenant avec
drop_pending_updates=False, comme l’échelle des erreurs réseau. Un démarrage à froid vide toujours la file ; un conflit, plus. - La fin d’un épisode de conflit est désormais régie par une période de calme de 120 secondes (
_POLLING_CONFLICT_QUIET_PERIOD = 120.0). C’est plus long que n’importe quel intervalle à l’intérieur d’une même tempête, donc ungetUpdatesréussi de temps en temps ne remet plus le compteur à1/5.
Autrement dit : l’ancien chemin consistait à « voir un 409, réinitialiser, effacer la file ». Le nouveau consiste à « traiter cela comme un seul épisode en cours, garder la file, et reculer pas à pas ». La doc le dit maintenant clairement : la récupération de conflit préserve la file, et les messages envoyés pendant un 409 sont livrés dès que le polling reprend.
Un 502 n’est pas une erreur fatale
Le deuxième chemin, ce sont les erreurs transitoires. Un seul 502 Bad Gateway faisait attendre à la récupération une échéance de 15 secondes, puis journalisait updater.stop() did not finish before the network-recovery deadline, puis faisait escalader le tout en Fatal telegram adapter error et reconstruisait l’adaptateur de zéro. Un hoquet d’une demi-seconde coûtait une reconstruction complète.
Désormais le même Updater est redémarré en une seconde environ : pas de ligne fatale, pas de ligne d’échéance, et le DM suivant reçoit une réponse normale.
Les polls « sains » : de 186 secondes à 125
Le troisième chemin est le plus sournois. getUpdates continue de réussir, mais les messages en file ne sont jamais remis — la couche réseau a l’air parfaite. Une sonde de heartbeat surveille ce cas : deux sondes consécutives qui constatent « des updates en file mais non consommés » et elle déclare le poll bloqué, puis le redémarre.
Avant, l’écart entre l’arrivée du message et le redémarrage était de 186 secondes. Il est maintenant de 125, et il tient dans une seule fenêtre d’éveil. Sur un portable qui somnole, la différence est pratique : l’ancien minuteur pouvait être interrompu par la mise en veille et ne jamais accumuler deux sondes consécutives.
Le démarrage à froid reste une décision à part
La récupération de conflit conserve désormais la file, mais un démarrage à froid la vide toujours par défaut. C’est délibéré : pour un serveur toujours allumé, un redémarrage signifie « nettoyage », et le retard accumulé est considéré comme périmé.
Si votre hôte est un portable qui s’éteint la nuit, les messages envoyés pendant qu’il était hors ligne dorment dans la file de la Bot API de Telegram et sont jetés au démarrage suivant — en silence, sans ligne de log. Pour recevoir ce retard dans l’ordre :
platforms:
  telegram:
    extra:
      drop_pending_on_cold_boot: false
Il y a un coût. Après un crash, une file préservée peut relivrer un update que l’instance plantée avait partiellement traité. L’offset de Telegram l’empêche généralement, mais des commandes sensibles au temps envoyées pendant une longue panne s’exécuteront au démarrage. Cet arbitrage vous revient.
Le bug plus discret : les updates non gérés étaient acquittés
Un correctif supplémentaire de cette série (PR #151077) a un symptôme plus subtil. Certains types d’updates que Hermes ne gère pas — un message 🎲 dé, par exemple — étaient marqués « traités » en douce. Cet accusé de réception disait à Telegram que l’update avait été livré, donc Telegram arrêtait de le relivrer, et rien n’apparaissait dans le log.
Désormais, un update qu’aucun handler ne réclame n’est pas acquitté, et il journalise une seule ligne INFO avec les noms de champs uniquement, jamais le contenu :
Update 1000 matched no core handler; not receipted (fields: message(chat,date,dice,from,message_id), update_id)La même PR corrige un cas limite à l’arrêt : l’arrêt de l’adaptateur pouvait se terminer avant que ses enregistrements d’updates traités ne soient libérés. Il attend maintenant ces libérations, et une coroutine annulée pendant qu’elle attendait son tour est fermée au lieu de fuir.
Deux choses que vous pouvez faire vous-même
D’abord, assurez-vous que deux processus ne se battent pas pour un seul bot. hermes gateway list affiche chaque profil avec l’état de son gateway et son pid, ce qui est exactement la façon de repérer un doublon. Si vous faites tourner plusieurs profils avec leurs propres bots, hermes gateway migrate --dry-run lance un contrôle préalable qui signale les tokens de bot en double — la source la plus fréquente de 409.
hermes gateway list
hermes gateway migrate --dry-run
Ensuite, arrêtez de lire 409 comme « Telegram est capricieux ». C’est presque toujours de la configuration locale : un token utilisé deux fois. Supprimer le doublon fait plus que n’importe quel réglage de timeout.
Quand pourrez-vous en profiter
Les PR #150983 et #151077 ont toutes deux été fusionnées sur main le 9 novembre 2026. La v0.23.0 est sortie le 6 novembre, donc ces correctifs ne sont pas dans la v0.23.0 ; ils arriveront avec la prochaine release stable.
Mise à jour (10/11/2026) : ces changements sont sortis dans la v0.23.1 (9 novembre) : un
hermes updatesuffit. Le « pas dans la v0.23.0 » ci-dessus reste exact ; la v0.23.1 comble l’écart.
Si vous perdez des messages en ce moment même, il y a deux palliatifs : tuer le gateway en double (le vrai correctif), et mettre drop_pending_on_cold_boot: false pour que les redémarrages cessent d’avaler le retard — en gardant en tête la réserve sur la relivraison ci-dessus.
Pour l’autre moitié du tableau de fiabilité — comment Hermes décide qu’un gateway est devenu silencieux — voir les déconnexions silencieuses et le heartbeat. Pour la configuration Telegram côté interaction (boutons inline, pickers), voir ce guide.
La version courte
Trois chemins de panne, trois modes de défaillance : un conflit efface la file (messages perdus pour de bon), une erreur transitoire est traitée comme fatale (reconstruction complète de l’adaptateur), un poll d’apparence saine est détecté trop tard (trois minutes). Les correctifs conservent la file et font monter l’échelle, réutilisent l’Updater, et ramènent la détection sous les deux minutes. Tout cela est main uniquement aujourd’hui, mais pour quiconque fait tourner Hermes sur Telegram, c’est la réponse à « mon message s’est-il vraiment perdu ? »