Mensagens sumindo depois de uma reconexão: a correção do conflito no Telegram que para de perder a sua fila
Você está na rua, então manda uma mensagem para a máquina do Hermes em casa: “roda de novo aquele script de backup”. Nenhum recibo de leitura, nenhuma resposta. Dois minutos depois você manda outra vez. Nada. Você chega em casa, abre o log e encontra algumas linhas 409 Conflict e depois tudo normal — só que aquelas duas mensagens nunca serão processadas.
Esse é o velho problema do Long Polling: dois processos disputam o getUpdates do mesmo bot, o Telegram deixa exatamente um vencer, e o outro leva um 409. O Hermes já tentava de novo. O problema era o que ele fazia enquanto tentava.
Três falhas diferentes que parecem todas “a rede”
As falhas do lado do Telegram soam parecidas e se comportam de maneiras completamente distintas. São três caminhos, e cada um exige uma correção diferente:
- Conflito (409): outro poller segura a session de
getUpdatesdeste bot. Normalmente são dois gateways na mesma máquina, um processo antigo que nunca terminou, ou duas máquinas configuradas com o mesmo token do bot. - Erros transitórios (um 502 e companhia): uma chamada de
getUpdatesfalhou. - Um poll “saudável” que nunca entrega: toda ida e volta reporta sucesso, e as mensagens enfileiradas continuam sem chegar.
O lote integrado em 9 de novembro (PR #150983, mais o #151077) mexe nos três. Comece pelo conflito, porque é ali que estava o estrago.
O que um 409 custava: a fila
A recuperação de conflito reiniciava o polling com drop_pending_updates=True.
Esse parâmetro é fácil de ler errado. Ele não encerra a session do outro poller — ele diz ao Telegram para jogar fora todo update que está na fila do lado do servidor. Ou seja, as mensagens que você mandou naqueles alguns segundos eram limpas na recuperação. Sem erro, sem linha de log, sem retentativa. Simplesmente sumiam.
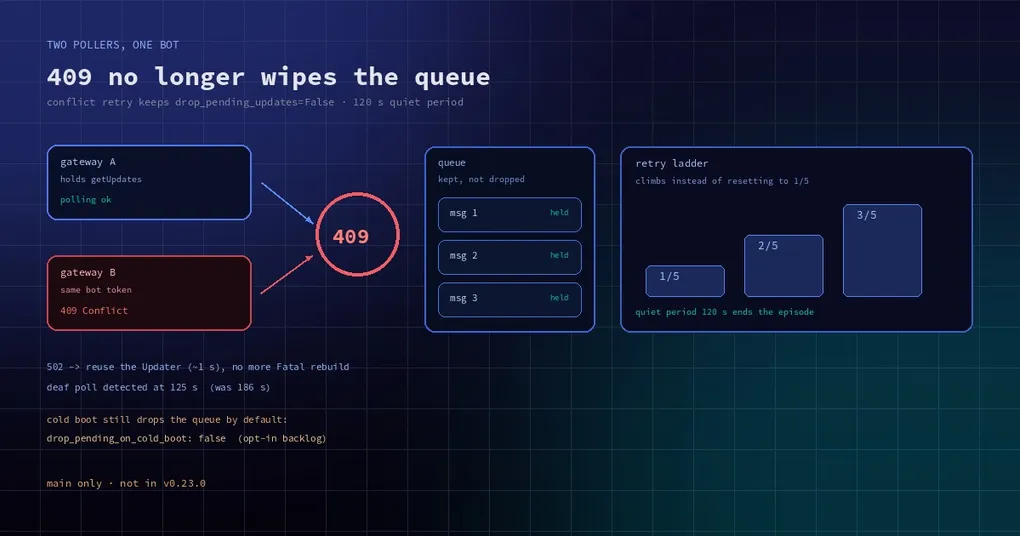
O contador de retentativas era pior. A recuperação de conflito tem uma escada de cinco tentativas que registra (1/5), (2/5) e assim por diante. Em um teste ao vivo, três conflitos separados registraram todos (1/5): a escada nunca subia. Duas causas, ambas no mesmo lugar. O marcador de recuperação era limpo em um bloco finally assim que start_polling() retornava, antes de o getUpdates em background do PTB fazer qualquer progresso. E, durante uma tempestade de 409, o getUpdates às vezes dá certo entre conflitos, o que zerava a contagem para um. O projeto — “continue tentando enquanto o conflito durar” — nunca chegava a rodar de fato.
Hoje: a fila sobrevive e a escada sobe
O antes e o depois são concretos. Mesmo cenário nas duas execuções: um poller concorrente produz três 409, com uma mensagem direta enfileirada durante cada conflito.
| Cenário | Antes | Depois |
|---|---|---|
| Três 409, uma DM enfileirada em cada | log mostra (1/5) três vezes, quatro chamadas deleteWebhook(drop_pending_updates=true), a DM 1 nunca é respondida |
(1/5) → (2/5) → (3/5), só o descarte do cold boot, as três DMs respondidas |
Duas mudanças:
- A recuperação de conflito agora reinicia com
drop_pending_updates=False, igual à escada de erros de rede. Um cold boot ainda limpa a fila; um conflito não limpa mais. - O fim de um episódio de conflito passou a ser governado por um período de silêncio de 120 segundos (
_POLLING_CONFLICT_QUIET_PERIOD = 120.0). É mais longo que qualquer intervalo dentro de uma mesma tempestade, então umgetUpdatesbem-sucedido ocasional não zera mais a contagem para1/5.
Em outras palavras: o caminho antigo era “viu um 409, reseta, apaga a fila”. O novo é “trate isto como um episódio contínuo, mantenha a fila e recue passo a passo”. A documentação agora diz isso com todas as letras: a recuperação de conflito preserva a fila, e mensagens enviadas durante um 409 são entregues quando o polling retoma.
Um 502 não é erro fatal
O segundo caminho são os erros transitórios. Um único 502 Bad Gateway fazia a recuperação esperar um prazo de 15 segundos, registrar updater.stop() did not finish before the network-recovery deadline, escalar tudo para Fatal telegram adapter error e reconstruir o adapter do zero. Um soluço de meio segundo custava uma reconstrução completa.
Agora o mesmo Updater é reiniciado em cerca de um segundo: sem linha fatal, sem linha de prazo, e a próxima DM é respondida normalmente.
Polls “saudáveis”: de 186 segundos para 125
O terceiro caminho é o mais sorrateiro. O getUpdates continua dando certo, mas as mensagens enfileiradas nunca são entregues — a camada de rede parece perfeita. Uma sonda de heartbeat vigia isso: duas sondagens consecutivas que veem “updates na fila mas não consumidos” e ela declara o poll travado e o reinicia.
Antes, o intervalo entre a chegada da mensagem e o restart era de 186 segundos. Agora é de 125, e cabe dentro de uma única janela acordada. Em um notebook que hiberna, essa diferença é prática: o timer antigo podia ser interrompido pelo sleep e nunca acumular duas sondagens consecutivas.
O cold boot é uma decisão separada
A recuperação de conflito agora mantém a fila, mas um cold boot ainda a descarta por padrão. Isso é deliberado: em um servidor sempre ligado, reiniciar significa “limpar”, e o backlog é tratado como velho.
Se o seu host é um notebook que desliga à noite, as mensagens enviadas enquanto ele estava desligado ficam na fila da Bot API do Telegram e são descartadas no próximo boot — em silêncio, sem linha de log. Para receber esse backlog em ordem:
platforms:
  telegram:
    extra:
      drop_pending_on_cold_boot: false
Há um custo. Depois de um crash, uma fila preservada pode reentregar um update que a instância quebrada já tinha processado em parte. O offset do Telegram normalmente evita isso, mas comandos sensíveis ao tempo enviados durante uma queda longa vão rodar no boot. Esse trade-off é seu para decidir.
O bug mais silencioso: updates não tratados recebiam recibo
Mais uma correção deste lote (PR #151077) tem um sintoma mais discreto. Alguns tipos de update que o Hermes não trata — uma mensagem de dado 🎲, por exemplo — eram marcados como “concluídos” sem alarde. Esse recibo dizia ao Telegram que o update havia sido entregue, então ele parava de reentregar, e nada aparecia no log.
Agora um update que nenhum handler assume não recebe recibo, e gera uma linha INFO apenas com nomes de campo, nunca com conteúdo:
Update 1000 matched no core handler; not receipted (fields: message(chat,date,dice,from,message_id), update_id)O mesmo PR corrige uma borda de desligamento: parar o adapter podia terminar antes de os registros de updates tratados serem liberados. Agora ele espera essas liberações, e uma corrotina cancelada enquanto esperava a vez é fechada em vez de vazar.
Duas coisas que você pode fazer sozinho
Primeiro, garanta que dois processos não estão brigando por um bot. O hermes gateway list mostra todos os profiles, com o estado do gateway e o pid, que é exatamente como se identifica uma duplicata. Se você roda vários profiles com bots próprios, o hermes gateway migrate --dry-run executa uma verificação prévia que reporta tokens de bot duplicados — a fonte mais comum de 409.
hermes gateway list
hermes gateway migrate --dry-run
Segundo, pare de ler 409 como “o Telegram está instável”. Quase sempre é configuração local: um token usado duas vezes. Remover a duplicata resolve mais do que qualquer ajuste de timeout.
Quando você pode usar isto
Os PRs #150983 e #151077 foram integrados na main em 9 de novembro de 2026. A v0.23.0 saiu em 6 de novembro, então essas correções não estão na v0.23.0; elas chegam na próxima release estável.
Atualização (10/11/2026): essas mudanças saíram na v0.23.1 (9 de novembro): basta um
hermes update. O « não está na v0.23.0 » acima continua correto; a v0.23.1 fecha a lacuna.
Se você está perdendo mensagens agora, há dois paliativos: mate o gateway duplicado (a correção de verdade) e defina drop_pending_on_cold_boot: false para que os restarts parem de engolir o backlog — lembrando da ressalva sobre reentrega acima.
Para a outra metade do quadro de confiabilidade — como o Hermes decide que um gateway ficou quieto — veja desconexões silenciosas e o heartbeat. Para a configuração do Telegram no lado da interação (botões inline, pickers), veja este guia.
Resumo rápido
Três caminhos de falha, três modos de falha: um conflito apaga a fila (mensagens perdidas de vez), um erro transitório é tratado como fatal (reconstrução completa do adapter), um poll de aparência saudável é detectado tarde demais (três minutos). As correções mantêm a fila e fazem a escada subir, reaproveitam o Updater e reduzem a detecção para menos de dois minutos. Tudo isso é exclusivo da main hoje, mas, para quem roda o Hermes no Telegram, esta é a resposta para “minha mensagem se perdeu mesmo?”.