会话压缩到第 40 次,它还记得什么?官方做了个评测
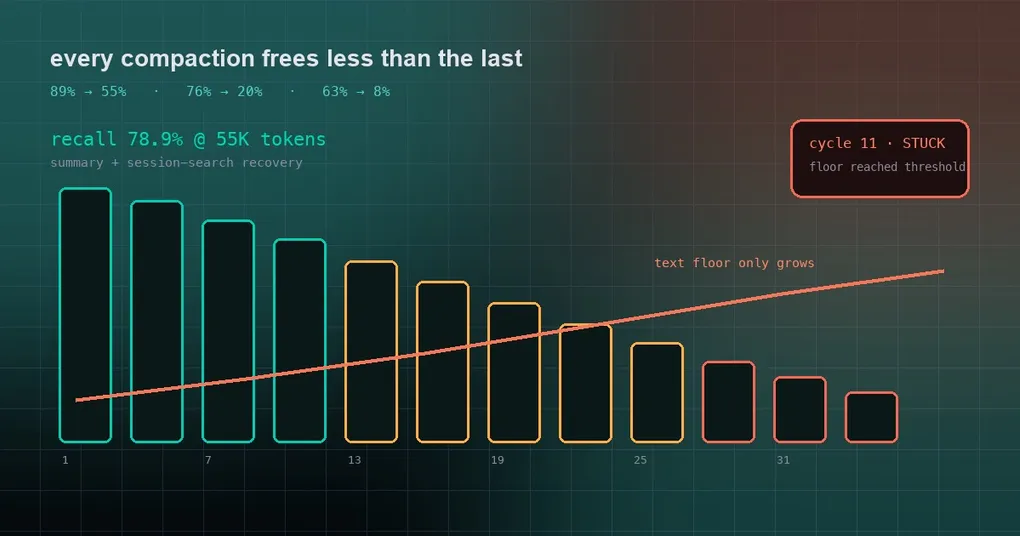
你有没有那种「开了三天一直没关」的会话?前面讨论过的接口命名、踩过的那个报错原文、当初为什么否掉某个方案——第一天全在,第三天你问「我们之前那个超时是怎么修的」,它一本正经地给你一个新答案。你没有换模型,也没有改提示词。变的是上下文:它在你看不见的地方被压缩了很多次。
问题是:压缩到底会磨掉什么?磨到什么程度开始出问题?这不是靠感觉能回答的事。9 月 19 日,Hermes 仓库里多了一份完整的对照评测(evals/compaction/),用真实会话给出了数字。
评测是怎么做的
材料是三个真实的 50 万 token 会话谱系,从本地 state.db 里重建出来的:一场 PR review 战役、一次系统提示词 token 分析、一个 SIGSEGV 排查。压缩会把历史上的轮次卷成摘要,于是评测先「针对即将被卷走的那段」生成 15 道事实回忆题,再把压缩后的上下文单独交给一个模型答题,然后由另一个模型对照标准答案判分。答对 2 分、部分正确 1 分、错 0 分。
这样得到的是两条轴的组合:回忆准确率和为此保留了多少 token。上下文留得多,分数高是理所当然的;只有把两者放在一起看,才知道压缩做得好不好。
结果:出厂路径 78.9%,成本还更低
| 方案 | 平均回忆率 | 保留 token | 每次压缩耗时 / 花费 |
|---|---|---|---|
| 只给摘要(不给恢复指针) | 43.3% | 5.5 万 | 37 秒 / $0.061 |
| 摘要 + 会话检索恢复(出厂默认) | 78.9% | 5.5 万 | 37 秒 / $0.061 |
| 只保留最近内容的精简尾部 | 41.1% | 5.5 万 | 33 秒 / $0.062 |
| 第三方方案 Jev(默认阈值) | 75.5% | 11.5 万 | 1.4 秒 / $0.007 |
| Jev(把工具预算放宽到 6 万 token) | 77.8% | 17.6 万 | 1.5 秒 / $0.007 |
| 纯按「最近的先留」同样 6 万 token | 77.8% | 17.7 万 | 0 秒 / $0 |
先解释一下什么叫「会话检索恢复」。Hermes 压缩完不是只丢给你一段摘要,摘要里还带着一个指针:被卷走的那段历史仍在库里,用会话检索(同样的全文索引)可以拉回来。评测给了答题模型一次检索机会,就是表中第二行。同一份摘要、不做检索,分数掉到 43.3%——差的这 35 分,就是「归档还在」和「归档不在」的区别。
再看那个第三方方案,它来自社区的一个思路:不写摘要,改用一个小模型给每次工具调用和结果打分,把过期的丢掉、把人和助手说过的话一字不改地保留。它的卖点很有说服力——闭卷情况下比摘要高 32 分(75.5% vs 43.3%),压缩成本只有 1/9、耗时 1/25。
但把保留 token 摆上来看,账就不一样了:它要多留 2.1 倍的上下文,而这部分上下文在之后的每一轮对话里都要重新计费。更关键的是,评测发现它的「判断」其实没起作用——在默认阈值下,851 个候选它 100% 全部丢弃,也就是说它实际等价于一条极简规则:「旧工具结果全删,对话文本全留」。真正救回分数的不是模型判断,而是「文本留了原文」。把工具预算放宽到和「最近的先留」一样大再比,两者打成平手(77.8 对 77.8)——排序判断的价值,落在评测噪声里。
真正要命的不是一次压缩,是第一百次
单次评测看不出长期会话的故障模式。于是评测又加了一个「反复压缩模拟器」:把会话按时间喂进去,每次估算超过阈值就压一次,记录这一轮释放了多少、剩了多少。
| 场景 | 压缩轮数 | 每轮释放比例 | 文本地板 | 结局 |
|---|---|---|---|---|
| PR review @50 万窗口 | 32 | 89% → 55% | 4.3 万 → 13.9 万 | 还能跑 |
| 系统提示词分析 @50 万窗口 | 40 | 76% → 20% | 9.1 万 → 24 万 | 已明显退化 |
| SIGSEGV 排查 @50 万窗口 | 40 | 63% → 8% | 17.5 万 → 35.9 万 | 每轮只释放 4 万 |
| PR review @16 万窗口 | 60 | 87% → 22% | 1.2 万 → 8.7 万 | 每约 14 条消息就压一次 |
| SIGSEGV @16 万窗口 | 11 | 52% → 0% | 8.5 万 → 15.1 万 | 卡死(地板已经顶到阈值) |
看这张表的第二列和第三列:释放比例一路衰减,因为对话文本是不被删的,而它只增不减。于是每一轮能腾出来的空间上限是「阈值 − 文本地板」,而地板在涨。在一个 20 万窗口(16 万阈值)的机器上,SIGSEGV 那份会话跑到第 11 轮就再也挤不出空间了——此时它才消耗了 42 万 token 的工作量。50 万阈值那份跑到第 40 轮时,每新增 4 万 token 就要压一次,每一轮对话都要按约 46 万输入 token 计费。
还有一份 541 次工具调用的会话,因为这类方案的状态上限只有 2.5 万 token,连第一次压缩都塞不进去,直接退回摘要。
结论是「不改」,但有几件事你可以做
评测给出的建议是保持现状:出厂路径(摘要 + 恢复指针 + 精简尾部)在回忆率和保留成本上都更划算,专门为了「少删工具结果」而增加每轮上下文,是笔亏本买卖。这些都是评测事实,不是我们可以自己调的旋钮——但它对你的用法有三点直接启示。
第一,把关键标识写进对话文本。 评测注意到摘要丢失的东西很有规律:委派出去的会话 id、根因、配置键名、报错的原文——它们都躺在助手的回复文本里。工具输出会被卷走,对话文本不会。下次让 agent 汇报时,顺手要一句「把那个 id 和原文贴出来」,比回头去翻工具有效得多。
第二,会话检索是免费的安全网,要用。 那 35 分的差距就是它带来的。压缩之后你问「之前那个超时怎么修的」,只要真的发生过,全文检索就还能翻出来——这条在会话边界那篇里也提过。相关命令在会话管理命令参考里。
第三,长任务该分段就分段。 表里的「卡死」和「每 14 条消息压一次」,都是同一份会话里堆了太多工作导致的。做完一个阶段就换新会话、把结论带过去,比让一份会话扛完整个项目稳得多。
如果你在意的是压缩怎么触发,那两个旋钮是 compression.threshold(默认 0.50;窗口小于 51.2 万的模型被抬到 0.75 起步)和 compression.tail_mode(默认 lean,即精简尾部)。它们的行为我们分别在精简尾部那篇和一条命令压缩那篇里拆过。这次的评测没有改默认值——它只是第一次拿数字告诉你,默认值为什么长这样。