Qué le hacen 40 rondas de compactación a una sesión de tres días
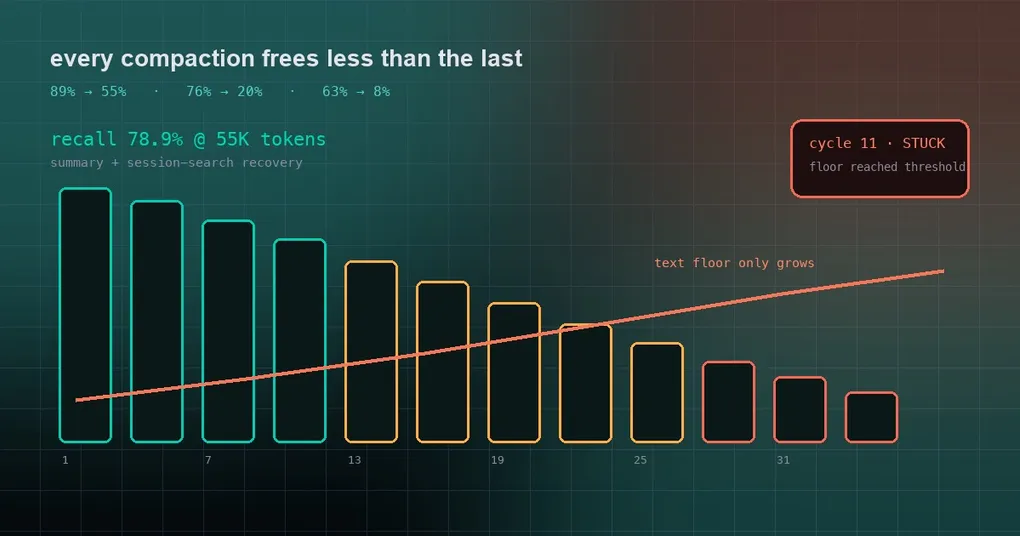
¿Recuerdas esa sesión que estuvo abierta tres días? El nombre de la API que discutisteis, la cadena de error exacta que pegaste, el motivo por el que descartaste un enfoque: todo eso estaba ahí el primer día. El tercer día preguntas “¿cómo arreglamos aquel timeout?” y recibes una respuesta nueva y muy segura. No cambiaste de modelo. No cambiaste el prompt. Lo que cambió es el contexto: se compactó muchas veces mientras no mirabas.
La pregunta real es qué va moliendo la compactación, y en qué punto eso empieza a doler. Las sensaciones son un mal instrumento para esto. El 19 de septiembre el repositorio incorporó una eval controlada completa (evals/compaction/) que lo responde con números de sesiones reales.
Cómo funciona la eval
El material son tres linajes de sesión reales de 500K tokens, reconstruidos a partir de un state.db local: una campaña de revisión de PRs, un análisis de tokens de system prompt y una investigación de un SIGSEGV. La compactación convierte el historial en un resumen, así que la eval primero escribe 15 preguntas de recuerdo factual sobre la región que está a punto de resumirse, luego entrega solo el contexto posterior a la compactación a un modelo que las responde, y a un segundo modelo que puntúa contra el gold. Dos puntos por acierto, uno por parcial, cero por error.
Eso produce dos ejes a la vez: la precisión de recuerdo y cuántos tokens se retuvieron para conseguirla. Conservar más contexto y puntuar más alto no demuestra nada por sí solo; solo el par te dice si la compresión mereció la pena.
Resultados: la ruta de producción puntúa 78.9% y cuesta menos por turno
| Política | Recuerdo medio | Tokens retenidos | Tiempo / coste por compactación |
|---|---|---|---|
| Solo resumen (sin puntero de recuperación) | 43.3% | 55K | 37 s / $0.061 |
| Resumen + recuperación por búsqueda de sesión (producción) | 78.9% | 55K | 37 s / $0.061 |
| Cola lean, solo recencia | 41.1% | 55K | 33 s / $0.062 |
| Rama Jev de terceros (umbral por defecto) | 75.5% | 115K | 1.4 s / $0.007 |
| Jev con un presupuesto de herramientas de 60K | 77.8% | 176K | 1.5 s / $0.007 |
| Recencia simple con el mismo presupuesto de 60K | 77.8% | 177K | 0 s / $0 |
Primero, la “recuperación por búsqueda de sesión”. Cuando Hermes compacta, no recibes únicamente un resumen: el resumen lleva un puntero, porque la región archivada sigue en el store y el mismo índice full-text puede traerla de vuelta. La eval le da al modelo que responde exactamente una ida y vuelta de búsqueda: esa es la segunda fila. El mismo resumen sin recuperación puntúa 43.3%. Esos 35 puntos son la diferencia entre “el archivo todavía existe” y “el archivo no existe”.
Ahora la política de terceros, que nace de una idea de la comunidad: no escribir ningún resumen, usar un modelo de decisión pequeño para puntuar cada llamada y cada resultado de herramienta, descartar los obsoletos y conservar los textos del usuario y del asistente verbatim. La propuesta es potente: a libro cerrado supera al resumen por 32 puntos (75.5% frente a 43.3%) con una novena parte del coste de compactación y una veinticincoava parte del tiempo de reloj.
Pon los tokens retenidos al lado y la contabilidad cambia. Carga 2.1x el contexto, y ese contexto se vuelve a facturar en cada turno posterior. Más interesante aún: la eval descubrió que el juicio del modelo no hacía realmente el trabajo. Con el umbral por defecto descartó el 100% de 851 candidatos, lo que hace que la rama por defecto sea funcionalmente idéntica a una regla burda: “borra todos los resultados de herramientas antiguos y conserva todo el diálogo verbatim”. Lo que salvó la puntuación fue el texto verbatim, no el scoring. Amplía el presupuesto de herramientas para igualar la rama de recencia y las dos empatan exactamente (77.8 frente a 77.8): el juicio rankeado cae dentro del ruido.
El verdadero modo de fallo no es una compactación, es la número cien
Una puntuación puntual no puede ver el modo de fallo a largo plazo, así que la eval añadió un simulador de compactación repetida: alimenta un linaje en orden cronológico, compacta cada vez que la estimación cruza el umbral y registra cuánto liberó cada ronda y cuánto creció el suelo.
| Ejecución | Ciclos | Liberado por ciclo | Suelo de texto | Estado final |
|---|---|---|---|---|
| Revisión de PR @ ventana de 500K | 32 | 89% → 55% | 43K → 139K | sigue funcionando |
| Análisis de system prompt @ 500K | 40 | 76% → 20% | 91K → 240K | degradándose |
| Investigación de SIGSEGV @ 500K | 40 | 63% → 8% | 175K → 359K | 40K liberados por ciclo |
| Revisión de PR @ ventana de 160K | 60 | 87% → 22% | 12K → 87K | compacta cada ~14 filas |
| SIGSEGV @ ventana de 160K | 11 | 52% → 0% | 85K → 151K | ATASCADO (el suelo alcanzó el umbral) |
Mira la tercera columna. El espacio liberado decae porque el texto de diálogo nunca se elimina, y solo crece. Así que cada ciclo puede liberar como máximo “umbral menos suelo de texto”, mientras el suelo sube. En un host con ventana de 200K, el linaje de SIGSEGV llegó al tope duro tras 11 ciclos, habiendo consumido solo 0.42M tokens de trabajo. La ejecución con ventana de 500K llegó al ciclo 40 compactando cada ~40K tokens de trabajo nuevo, con cada turno facturado a unos 460K tokens de entrada.
Y una transcripción con 541 llamadas a herramientas nunca cupo en el techo de 25K tokens de estado del plugin, ni una sola vez, así que cayó al resumen en el primer intento.
El veredicto es “no cambiar nada”, pero de ahí se derivan tres cosas para ti
La recomendación de la eval es mantener el diseño actual: la ruta de producción (resumen más puntero de recuperación más una cola lean) gana tanto en recuerdo como en coste retenido, y cargar más contexto por turno solo para borrar menos resultados de herramientas es un mal negocio. Nada de eso es una palanca que configures tú, pero tres consecuencias prácticas sí lo son.
Uno: mantén los identificadores en el texto del diálogo. Los datos que el resumen perdía eran llamativamente regulares: ids de sesión de delegación, causas raíz, nombres de claves de config, cadenas de error verbatim. Estuvieron en el texto del asistente todo el tiempo; lo que se arrincona es la salida de las herramientas. La próxima vez que le pidas un informe al agente, pídele que pegue el id y el error en crudo, y deja de rebuscar después en la salida de herramientas.
Dos: la búsqueda de sesión es una red de seguridad gratuita, así que úsala. De ahí salieron esos 35 puntos. Después de una compactación, “¿cómo arreglamos aquel timeout?” sigue siendo respondible por el índice full-text, siempre que realmente ocurriera, algo que también señala el artículo sobre los límites de sesión. Los comandos están en la referencia de gestión de sesiones.
Tres: parte los trabajos largos en fases. Tanto el tope duro como eso de “compactar cada 14 filas” vienen de apilar un proyecto entero en una sola sesión. Termina una fase, empieza una sesión nueva, arrastra las conclusiones: eso es mucho más estable que hacer que una sola sesión lo cargue todo.
Si lo que te importa es cuándo se dispara la compactación, las dos palancas son compression.threshold (por defecto 0.50; los modelos por debajo de una ventana de 512K tienen un suelo de 0.75) y compression.tail_mode (por defecto lean). Desglosamos su comportamiento en el artículo sobre la cola lean y el artículo sobre la compactación en una sola llamada. Esta eval no cambió ningún valor por defecto: es la primera vez que alguien muestra, con números, por qué los valores por defecto son como son.