Ce que 40 cycles de compaction font à une session de trois jours
Vous connaissez cette session restée ouverte pendant trois jours ? Le nommage d’API sur lequel vous avez bataillé, la chaîne d’erreur exacte que vous avez collée, la raison pour laquelle vous avez rejeté une approche — tout cela était là dès le premier jour. Le troisième jour, vous demandez « comment on avait déjà corrigé ce timeout ? » et vous obtenez une réponse confiante et toute neuve. Vous n’avez pas changé de modèle. Vous n’avez pas changé le prompt. Ce qui a changé, c’est le contexte : il a été compacté de nombreuses fois pendant que vous ne regardiez pas.
La vraie question, c’est ce que la compaction broie, et à partir de quel moment cela commence à faire mal. Les impressions sont un mauvais instrument pour ça. Le 19 septembre, le dépôt s’est doté d’une évaluation contrôlée complète (evals/compaction/) qui répond à la question avec des chiffres issus de sessions réelles.
Comment fonctionne l’évaluation
Le matériau de départ, ce sont trois lignées de sessions réelles de 500K tokens, reconstruites à partir d’un state.db local : une campagne de revue de PR, une analyse de tokens de prompt système et une investigation de SIGSEGV. La compaction fond l’historique dans un résumé, donc l’évaluation rédige d’abord 15 questions de rappel factuel sur la région qui est sur le point d’être résumée, puis ne confie que le contexte post-compaction à un modèle qui y répond, et à un second modèle qui note par rapport à la référence. Deux points pour une réponse correcte, un pour une partielle, zéro pour une fausse.
Cela produit deux axes en même temps : la précision du rappel et combien de tokens ont été conservés pour l’obtenir. Conserver plus de contexte et marquer plus de points ne prouve rien en soi ; seule la paire vous dit si la compression valait le coup.
Résultats : le chemin de production marque 78.9% et coûte moins cher par tour
| Politique | Rappel moyen | Tokens conservés | Temps / coût par compaction |
|---|---|---|---|
| Résumé seul (sans pointeur de récupération) | 43.3% | 55K | 37 s / $0.061 |
| Résumé + récupération par recherche de session (en production) | 78.9% | 55K | 37 s / $0.061 |
| Queue allégée, récence seule | 41.1% | 55K | 33 s / $0.062 |
| Bras Jev tiers (seuil par défaut) | 75.5% | 115K | 1.4 s / $0.007 |
| Jev avec un budget d’outils de 60K | 77.8% | 176K | 1.5 s / $0.007 |
| Récence simple avec le même budget de 60K | 77.8% | 177K | 0 s / $0 |
D’abord, la « récupération par recherche de session ». Quand Hermes compacte, vous n’obtenez pas seulement un résumé : le résumé porte un pointeur, parce que la région archivée est toujours dans le store et que le même index plein texte peut la ramener. L’évaluation n’accorde au modèle qui répond qu’un seul aller-retour de recherche — c’est la deuxième ligne. Le résumé identique sans récupération marque 43.3%. Ces 35 points séparent « l’archive existe encore » de « l’archive n’existe plus ».
Venons-en à la politique tierce, qui vient d’une idée de la communauté : ne rédiger aucun résumé, utiliser un petit modèle de décision pour noter chaque appel d’outil et chaque résultat, écarter ceux qui sont périmés, et conserver verbatim le texte utilisateur et assistant. L’argument est solide — à livre fermé, elle bat le résumé de 32 points (75.5% contre 43.3%), pour un coût de compaction divisé par neuf et un temps réel divisé par vingt-cinq.
Mettez les tokens conservés en regard, et la comptabilité change. Cette politique transporte 2.1x le contexte, et ce contexte est refacturé à chaque tour suivant. Plus intéressant encore : l’évaluation a constaté que le jugement du modèle n’a pas vraiment fait le travail. Au seuil par défaut, il a écarté 100% des 851 candidats, ce qui rend le bras par défaut identique en comportement à une seule règle grossière : « supprimer tous les anciens résultats d’outils, garder verbatim tout le texte de dialogue ». Ce qui a sauvé le score, c’est le texte verbatim, pas la notation. Élargissez le budget d’outils pour égaler le bras de récence et les deux font exactement match nul (77.8 vs 77.8) — le jugement classé retombe dans le plancher de bruit.
Le vrai mode de défaillance n’est pas une compaction, c’est la centième
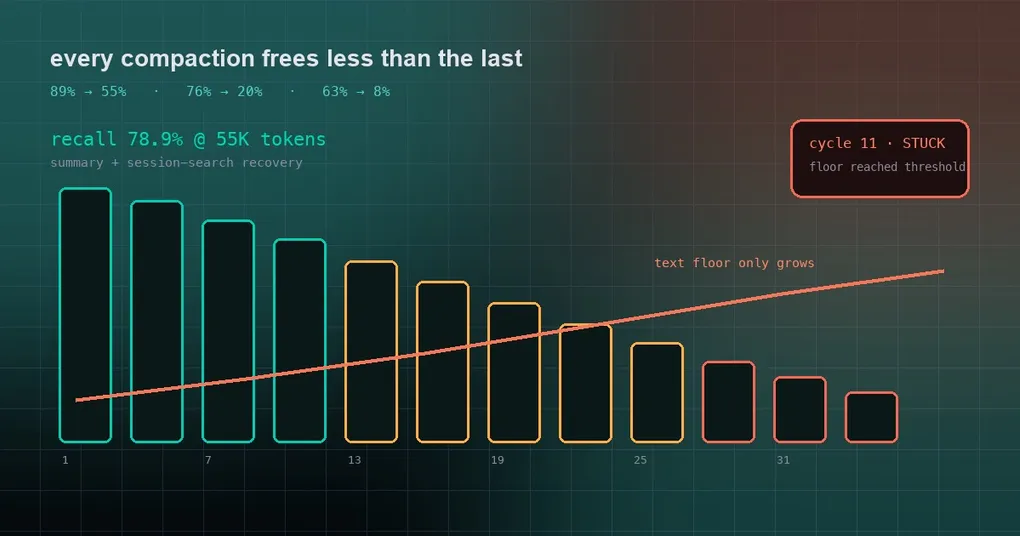
Un score obtenu en un seul coup ne peut pas voir le mode de défaillance de long terme, alors l’évaluation a ajouté un simulateur de compactions répétées : on déroule une lignée chronologiquement, on compacte chaque fois que l’estimation franchit le seuil, et on enregistre combien chaque cycle a libéré et de combien le plancher a monté.
| Exécution | Cycles | Libéré par cycle | Plancher texte | État final |
|---|---|---|---|---|
| Revue de PR @ fenêtre 500K | 32 | 89% → 55% | 43K → 139K | fonctionne encore |
| Analyse de prompt système @ 500K | 40 | 76% → 20% | 91K → 240K | se dégrade |
| Investigation SIGSEGV @ 500K | 40 | 63% → 8% | 175K → 359K | 40K libérés par cycle |
| Revue de PR @ fenêtre 160K | 60 | 87% → 22% | 12K → 87K | compaction tous les ~14 lignes |
| SIGSEGV @ fenêtre 160K | 11 | 52% → 0% | 85K → 151K | BLOQUÉ (le plancher a atteint le seuil) |
Regardez la troisième colonne. L’espace libéré décroît parce que le texte de dialogue n’est jamais retiré, et il ne fait que grossir. Chaque cycle ne peut donc libérer au maximum que « seuil moins plancher de texte », pendant que le plancher grimpe. Sur une machine à fenêtre de 200K, la lignée SIGSEGV a atteint l’arrêt dur au bout de 11 cycles — après n’avoir consommé que 0.42M tokens de travail. L’exécution à fenêtre 500K a atteint le cycle 40 en compactant tous les ~40K tokens de nouveau travail, chaque tour étant facturé à environ 460K tokens en entrée.
Et un transcript de 541 appels d’outils n’a jamais tenu dans le plafond d’état de 25K tokens du plugin, pas même une fois : il est retombé sur un résumé dès la toute première tentative.
Le verdict est « ne rien changer » — mais trois conséquences vous concernent
La recommandation de l’évaluation est de garder la conception actuelle : le chemin de production (résumé plus pointeur de récupération plus une queue allégée) gagne à la fois sur le rappel et sur le coût des tokens conservés, et transporter plus de contexte par tour juste pour supprimer moins de résultats d’outils est un mauvais échange. Aucun de ces éléments n’est un réglage que vous configurez, mais trois conséquences pratiques, si.
Un : gardez les identifiants dans le texte de dialogue. Les faits que le résumé avait perdus étaient étonnamment réguliers — identifiants de session de délégation, causes racines, noms de clés de config, chaînes d’erreur verbatim. Ils se trouvaient dans le texte assistant depuis le début ; c’est la sortie d’outil qui est emportée. La prochaine fois que vous demandez un rapport à l’agent, demandez-lui de coller l’identifiant et l’erreur brute, et cessez de fouiller ensuite dans les sorties d’outils.
Deux : la recherche de session est un filet de sécurité gratuit, alors servez-vous-en. C’est de là que venaient les 35 points. Après une compaction, « comment on avait corrigé ce timeout » reste accessible à l’index plein texte, à condition que ce soit vraiment arrivé — un point que l’article sur les frontières de session soulève lui aussi. Les commandes se trouvent dans la référence de gestion des sessions.
Trois : découpez les longs travaux en phases. L’arrêt dur comme la « compaction toutes les 14 lignes » viennent du fait d’entasser un projet entier dans une seule session. Terminez une phase, démarrez une nouvelle session, transportez les conclusions — c’est bien plus stable que de faire porter tout le projet à une seule session.
Si ce qui vous intéresse, c’est quand la compaction se déclenche, les deux réglages sont compression.threshold (défaut 0.50 ; les modèles sous une fenêtre de 512K sont plancherés à 0.75) et compression.tail_mode (défaut lean). Nous avons détaillé leur comportement dans l’article sur la queue allégée et l’article sur la compaction en un appel. Cette évaluation n’a modifié aucun défaut — c’est la première fois que quelqu’un montre, chiffres à l’appui, pourquoi les défauts sont ce qu’ils sont.