O que 40 rodadas de compactação fazem com uma sessão de três dias
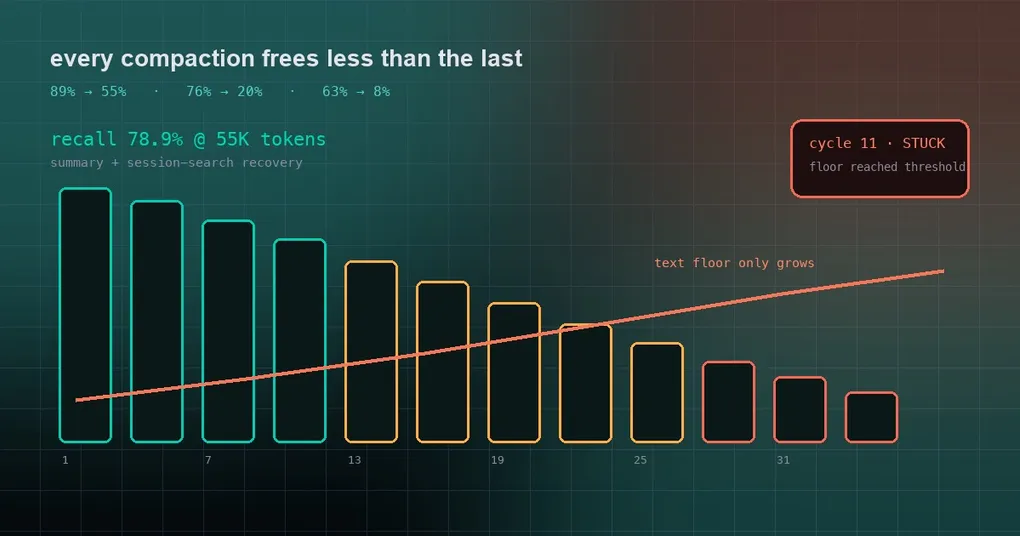
Você lembra daquela sessão que ficou aberta por três dias? A nomenclatura de API que vocês discutiram, a string de erro exata que você colou, o motivo pelo qual você rejeitou uma abordagem — tudo isso estava lá no primeiro dia. No terceiro dia você pergunta “como a gente corrigiu aquele timeout mesmo?” e recebe uma resposta confiante, novinha em folha. Você não trocou de modelo. Não mudou o prompt. O que mudou foi o contexto: ele foi compactado muitas vezes enquanto você não estava olhando.
A pergunta de verdade é o que a compactação tritura, e em que ponto isso começa a doer. Sentimento é um instrumento ruim para isso. Em 19 de setembro o repositório ganhou um eval controlado completo (evals/compaction/) que responde a essa pergunta com números vindos de sessões reais.
Como o eval funciona
O material são três linhagens reais de sessão de 500K tokens, reconstruídas a partir de um state.db local: uma campanha de revisão de PR, uma análise de tokens de system prompt e uma investigação de SIGSEGV. A compactação transforma o histórico em um resumo, então o eval primeiro escreve 15 perguntas factuais de recall sobre a região prestes a ser resumida, depois entrega apenas o contexto pós-compactação a um modelo que responde a elas, e a um segundo modelo que corrige com base no gabarito. Dois pontos para acerto, um para parcial, zero para erro.
Isso produz dois eixos em conjunto: acurácia de recall e quantos tokens foram retidos para chegar lá. Reter mais contexto e pontuar mais alto não prova nada sozinho; só o par indica se a compressão valeu a pena.
Resultados: o caminho em produção marca 78.9% e custa menos por turno
| Política | Recall médio | Tokens retidos | Tempo / custo por compactação |
|---|---|---|---|
| Apenas resumo (sem ponteiro de recuperação) | 43.3% | 55K | 37 s / $0.061 |
| Resumo + recuperação por busca de sessão (em produção) | 78.9% | 55K | 37 s / $0.061 |
| Cauda enxuta, só recência | 41.1% | 55K | 33 s / $0.062 |
| Braço do Jev de terceiros (limiar padrão) | 75.5% | 115K | 1.4 s / $0.007 |
| Jev com orçamento de ferramentas de 60K | 77.8% | 176K | 1.5 s / $0.007 |
| Recência pura com o mesmo orçamento de 60K | 77.8% | 177K | 0 s / $0 |
Primeiro, “recuperação por busca de sessão”. Quando o Hermes compacta, você não recebe só um resumo: o resumo carrega um ponteiro, porque a região arquivada continua no store e o mesmo índice de texto completo consegue trazê-la de volta. O eval dá ao modelo que responde exatamente uma ida e volta de busca — essa é a segunda linha. O resumo idêntico, sem recuperação, marca 43.3%. Esses 35 pontos são a diferença entre “o arquivo ainda existe” e “o arquivo não existe”.
Agora a política de terceiros, que vem de uma ideia da comunidade: não escrever resumo nenhum, usar um modelo pequeno de decisão para pontuar cada chamada de ferramenta e cada resultado, descartar os obsoletos e manter o texto do usuário e do assistente palavra por palavra. O argumento é forte — de livro fechado ela supera o resumo em 32 pontos (75.5% vs 43.3%), com um nono do custo de compactação e um vinte e cinco avos do tempo de parede.
Coloque os tokens retidos ao lado disso e a contabilidade muda. Ela carrega 2.1x o contexto, e esse contexto é cobrado de novo a cada turno seguinte. Mais interessante ainda: o eval descobriu que o julgamento do modelo não fazia de fato o trabalho. No limiar padrão ele descartou 100% de 851 candidatos, o que torna o comportamento do braço padrão idêntico ao de uma regra grosseira: “apague todo resultado de ferramenta antigo, mantenha todo o texto de diálogo na íntegra”. O que salvou a pontuação foi o texto literal, não a pontuação. Amplie o orçamento de ferramentas para igualar o braço de recência e os dois empatam exatamente (77.8 vs 77.8) — o julgamento ranqueado cai dentro do piso de ruído.
O verdadeiro modo de falha não é uma compactação, é a centésima
Uma pontuação de disparo único não consegue enxergar o modo de falha de longo prazo, então o eval adicionou um simulador de compactação repetida: alimente uma linhagem em ordem cronológica, compacte toda vez que a estimativa cruzar o limiar, e registre quanto cada rodada liberou e quanto o piso cresceu.
| Execução | Ciclos | Liberado por ciclo | Piso de texto | Estado final |
|---|---|---|---|---|
| Revisão de PR @ janela de 500K | 32 | 89% → 55% | 43K → 139K | ainda funcionando |
| Análise de system prompt @ 500K | 40 | 76% → 20% | 91K → 240K | degradando |
| Investigação de SIGSEGV @ 500K | 40 | 63% → 8% | 175K → 359K | 40K liberados por ciclo |
| Revisão de PR @ janela de 160K | 60 | 87% → 22% | 12K → 87K | compactando a cada ~14 linhas |
| SIGSEGV @ janela de 160K | 11 | 52% → 0% | 85K → 151K | TRAVADO (o piso alcançou o limiar) |
Olhe a terceira coluna. O espaço liberado decai porque o texto do diálogo nunca é removido, e ele só cresce. Então cada ciclo consegue liberar no máximo “limiar menos piso de texto”, enquanto o piso sobe. Em um host com janela de 200K, a linhagem do SIGSEGV bateu no travamento total depois de 11 ciclos — tendo consumido apenas 0.42M tokens de trabalho. A execução com janela de 500K chegou ao ciclo 40 compactando a cada ~40K tokens de trabalho novo, com cada turno cobrado em cerca de 460K tokens de entrada.
E um transcript com 541 chamadas de ferramenta nunca coube no teto de 25K tokens de estado do plugin nem uma única vez, caindo para um resumo já na primeira tentativa.
O veredito é “não mude nada” — mas três coisas decorrem para você
A recomendação do eval é manter o desenho atual: o caminho em produção (resumo mais ponteiro de recuperação mais cauda enxuta) ganha tanto em recall quanto em custo retido, e carregar mais contexto por turno só para apagar menos resultados de ferramenta é uma troca ruim. Nada disso é um botão que você configura, mas três consequências práticas são.
Um: mantenha os identificadores no texto do diálogo. Os fatos que o resumo perdia eram impressionantemente regulares — ids de sessão de delegação, causas-raiz, nomes de chaves de configuração, strings de erro literais. Eles ficaram no texto do assistente o tempo todo; o que é enrolado e jogado fora é a saída de ferramenta. Na próxima vez que pedir um relatório ao agente, peça que ele cole o id e o erro cru, e pare de caçar isso depois no meio da saída de ferramenta.
Dois: a busca de sessão é uma rede de segurança gratuita, então use. Foi daí que vieram os 35 pontos. Depois de uma compactação, “como a gente corrigiu aquele timeout” continua respondível pelo índice de texto completo, desde que realmente tenha acontecido — um ponto que o post sobre limites de sessão também faz. Os comandos estão na referência de gerenciamento de sessões.
Três: divida trabalhos longos em fases. Tanto o travamento total quanto o “compactando a cada 14 linhas” vêm de empilhar um projeto inteiro em uma única sessão. Termine uma fase, comece uma sessão nova e leve as conclusões adiante — isso é bem mais estável do que fazer uma sessão carregar tudo.
Se o que te interessa é quando a compactação dispara, os dois botões são compression.threshold (padrão 0.50; modelos abaixo de uma janela de 512K têm piso em 0.75) e compression.tail_mode (padrão lean). Destrinchamos o comportamento deles em o post da cauda enxuta e o post da compactação em uma chamada. Este eval não mudou nenhum padrão — é a primeira vez que alguém mostra, com números, por que os padrões são do jeito que são.