Was 40 Runden Compaction mit einer drei Tage alten Session machen
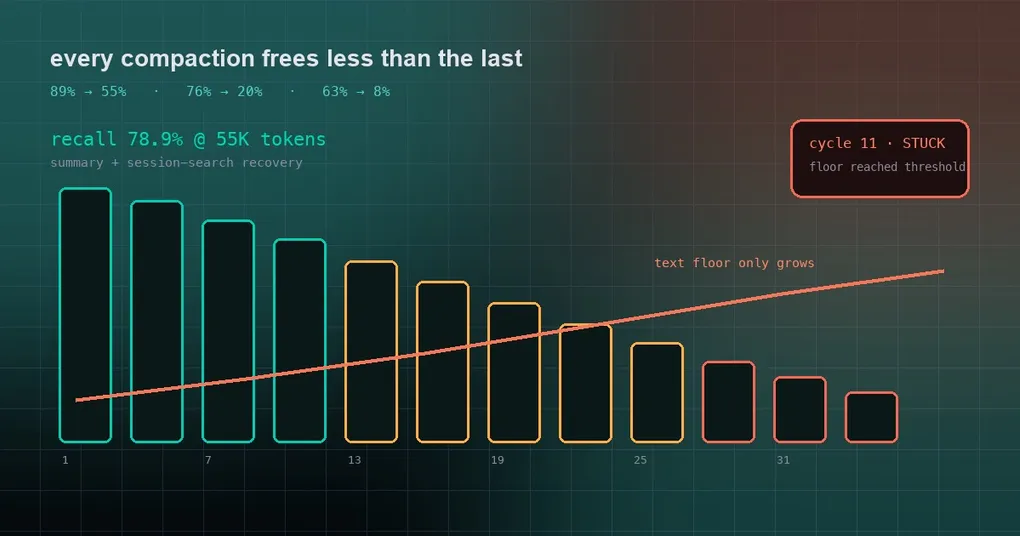
Du kennst die Session, die drei Tage lang offen blieb? Das API-Naming, über das du gestritten hast, der exakte Fehler-String, den du eingefügt hast, der Grund, aus dem du einen Ansatz verworfen hast — all das war am ersten Tag da. Am dritten Tag fragst du „wie haben wir diesen Timeout nochmal gefixt?“ und bekommst eine selbstsichere, brandneue Antwort. Du hast das Modell nicht gewechselt. Du hast den Prompt nicht gewechselt. Was sich geändert hat, ist der Kontext: Er wurde viele Male compactiert, während du nicht hingesehen hast.
Die eigentliche Frage ist, was die Compaction wegschleift und ab wann das weh tut. Gefühle sind dafür ein schlechtes Instrument. Am 19. September bekam das Repository ein vollständiges kontrolliertes Eval (evals/compaction/), das diese Frage mit Zahlen aus echten Sessions beantwortet.
Wie das Eval funktioniert
Das Material sind drei echte Session-Lineages mit 500K Tokens, rekonstruiert aus einer lokalen state.db: eine PR-Review-Kampagne, eine Analyse des System-Prompt-Token-Verbrauchs und eine SIGSEGV-Untersuchung. Compaction rollt Verlauf in eine Zusammenfassung, also schreibt das Eval zuerst 15 faktische Recall-Fragen über den Bereich, der gleich zusammengefasst wird, und übergibt dann nur den Kontext nach der Compaction an ein Modell, das sie beantwortet, plus ein zweites Modell, das gegen Gold bewertet. Zwei Punkte für richtig, einer für teilweise, null für falsch.
Das ergibt zusammen zwei Achsen: Recall-Genauigkeit und wie viele Tokens dafür behalten wurden. Mehr Kontext behalten und höher punkten beweist für sich genommen nichts; erst das Paar sagt dir, ob sich die Kompression gelohnt hat.
Ergebnis: Der Auslieferungspfad erreicht 78.9% und kostet weniger pro Turn
| Policy | Mittlerer Recall | Behaltene Tokens | Zeit / Kosten pro Compaction |
|---|---|---|---|
| Nur Zusammenfassung (kein Recovery-Zeiger) | 43.3% | 55K | 37 s / $0.061 |
| Zusammenfassung + Session-Suche-Recovery (Auslieferung) | 78.9% | 55K | 37 s / $0.061 |
| Lean-Tail, nur Aktualität | 41.1% | 55K | 33 s / $0.062 |
| Jev-Arm von Drittanbietern (Standard-Schwelle) | 75.5% | 115K | 1.4 s / $0.007 |
| Jev mit einem 60K Tool-Budget | 77.8% | 176K | 1.5 s / $0.007 |
| Einfache Aktualitätsregel mit demselben 60K-Budget | 77.8% | 177K | 0 s / $0 |
Zuerst einmal „session-search recovery“. Wenn Hermes compactiert, bekommst du nicht nur eine Zusammenfassung: Die Zusammenfassung trägt einen Zeiger, denn der archivierte Bereich liegt weiterhin im Store, und derselbe Volltextindex kann ihn zurückholen. Das Eval gibt dem antwortenden Modell genau einen Such-Roundtrip — das ist die zweite Zeile. Dieselbe Zusammenfassung ohne Retrieval erreicht 43.3%. Diese 35 Punkte sind der Unterschied zwischen „das Archiv existiert noch“ und „das Archiv existiert nicht“.
Jetzt die Dritt-Policy, die aus einer Community-Idee stammt: überhaupt keine Zusammenfassung schreiben, stattdessen mit einem kleinen Entscheidungsmodell jeden Tool-Call und jedes Ergebnis bewerten, die veralteten verwerfen und User- und Assistant-Text wortgetreu behalten. Das Versprechen ist stark — closed-book schlägt sie die Zusammenfassung um 32 Punkte (75.5% vs 43.3%) bei einem Neuntel der Compaction-Kosten und einem Fünfundzwanzigstel der Wall-Time.
Setz die behaltenen Tokens daneben, und die Rechnung ändert sich. Sie trägt 2.1x den Kontext, und dieser Kontext wird bei jedem folgenden Turn erneut abgerechnet. Interessanter noch: Das Eval fand heraus, dass die Urteilskraft des Modells die Arbeit gar nicht geleistet hat. Bei der Standard-Schwelle verwarf sie 100% von 851 Kandidaten, was die Standard-Variante verhaltensidentisch mit einer einzigen groben Regel macht: „jedes alte Tool-Ergebnis löschen, allen Dialogtext wortgetreu behalten“. Was den Score gerettet hat, war der wortgetreue Text, nicht das Scoring. Weite das Tool-Budget so, dass es zum Aktualitäts-Arm passt, und die beiden liegen exakt gleichauf (77.8 vs 77.8) — das rangbasierte Urteil landet innerhalb des Rauschens.
Der echte Fehlermodus ist nicht eine Compaction, sondern die hundertste
Ein Einmal-Score kann den langfristigen Fehlermodus nicht sehen, also ergänzte das Eval einen Simulator für wiederholte Compaction: eine Lineage chronologisch einspeisen, jedes Mal compactieren, wenn die Schätzung die Schwelle überschreitet, und festhalten, wie viel jede Runde freigegeben hat und wie stark der Boden gewachsen ist.
| Lauf | Zyklen | Freigegeben pro Zyklus | Text-Boden | Endzustand |
|---|---|---|---|---|
| PR-Review @ 500K-Fenster | 32 | 89% → 55% | 43K → 139K | arbeitet noch |
| System-Prompt-Analyse @ 500K | 40 | 76% → 20% | 91K → 240K | verschlechtert sich |
| SIGSEGV-Untersuchung @ 500K | 40 | 63% → 8% | 175K → 359K | 40K pro Zyklus freigegeben |
| PR-Review @ 160K-Fenster | 60 | 87% → 22% | 12K → 87K | Compaction alle ~14 Zeilen |
| SIGSEGV @ 160K-Fenster | 11 | 52% → 0% | 85K → 151K | STUCK (Boden hat die Schwelle erreicht) |
Schau dir die dritte Spalte an. Der freigewordene Platz schrumpft, weil Dialogtext nie entfernt wird und nur wächst. Jeder Zyklus kann also höchstens „Schwelle minus Text-Boden“ freigeben, während der Boden steigt. Auf einem Host mit 200K-Fenster erreichte die SIGSEGV-Lineage den harten Stopp nach 11 Zyklen — nach nur 0.42M Tokens verbrauchter Arbeit. Der Lauf mit 500K-Fenster kam bis Zyklus 40, indem er alle ~40K Tokens neuer Arbeit eine Compaction auslöste, wobei jeder Turn mit rund 460K Input-Tokens abgerechnet wurde.
Und ein Transcript mit 541 Tool-Calls passte auch nicht ein einziges Mal unter die 25K-Token-Obergrenze für den State des Plugins und fiel schon beim allerersten Versuch auf eine Zusammenfassung zurück.
Das Fazit lautet „nichts ändern“ — aber drei Konsequenzen betreffen dich
Die Empfehlung des Evals ist, das aktuelle Design beizubehalten: Der Auslieferungspfad (Zusammenfassung plus Recovery-Zeiger plus Lean-Tail) gewinnt sowohl bei Recall als auch bei den behaltenen Kosten, und mehr Kontext pro Turn mitzuschleppen, nur um weniger Tool-Ergebnisse zu löschen, ist ein schlechter Deal. Nichts davon ist ein Regler, den du konfigurierst — aber drei praktische Konsequenzen sind es.
Erstens: Behalte Identifikatoren im Dialogtext. Die Fakten, die die Zusammenfassung verlor, waren auffällig regelmäßig: Delegation-Session-IDs, Root Causes, Namen von Config-Keys, wortgetreue Fehler-Strings. Sie standen die ganze Zeit im Assistant-Text; weggerollt wird der Tool-Output. Wenn du den Agenten das nächste Mal um einen Report bittest, bitte ihn, die ID und den rohen Fehler einzufügen, und hör auf, später durch Tool-Output zu suchen.
Zweitens: Session-Suche ist ein kostenloses Sicherheitsnetz — also nutze es. Von hier kamen die 35 Punkte. Nach einer Compaction bleibt „wie haben wir diesen Timeout nochmal gefixt“ über den Volltextindex beantwortbar, solange es wirklich passiert ist — ein Punkt, den der Beitrag zu Session-Grenzen ebenfalls macht. Die Befehle stehen in der Referenz zur Session-Verwaltung.
Drittens: Teile lange Jobs in Phasen auf. Sowohl der harte Stopp als auch „Compaction alle 14 Zeilen“ entstehen daraus, dass man ein ganzes Projekt in eine einzige Session kippt. Schließe eine Phase ab, starte eine neue Session, nimm die Schlussfolgerungen mit — das ist deutlich stabiler, als eine Session alles tragen zu lassen.
Wenn dich interessiert, wann die Compaction auslöst, sind die beiden Regler compression.threshold (Standard 0.50; Modelle unter einem 512K-Fenster werden auf 0.75 geklemmt) und compression.tail_mode (Standard lean). Ihr Verhalten haben wir in dem Lean-Tail-Beitrag und dem Beitrag zur Compaction in einem einzigen Call auseinandergenommen. Dieses Eval hat keinen einzigen Standard geändert — es ist das erste Mal, dass jemand mit Zahlen zeigt, warum die Standards so aussehen, wie sie aussehen.