MCP 服务器发来一张截图,你的模型却只看到一行文件路径
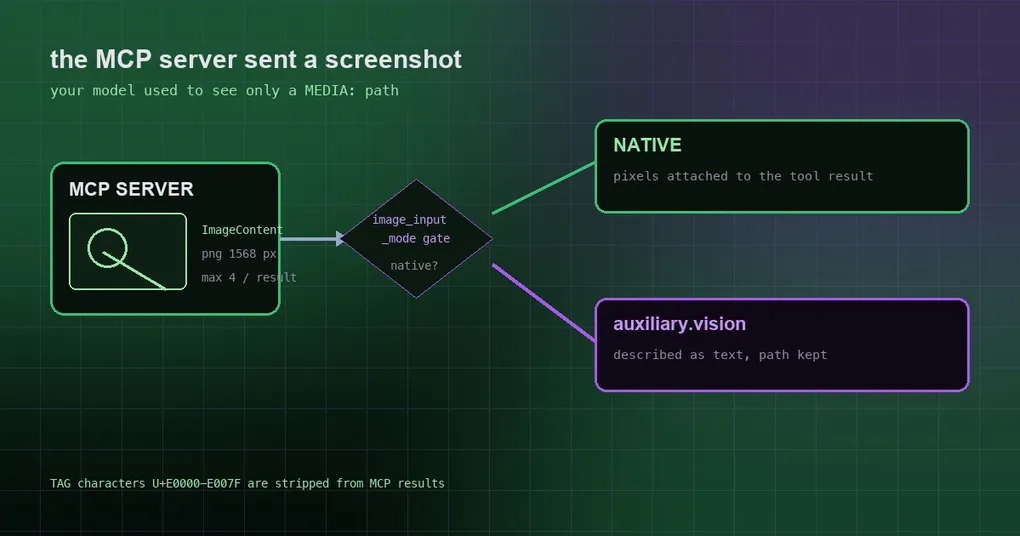
你给 Hermes 接了一个能做屏幕捕获的 MCP 服务器——那种自己截屏、把图作为结果返回的。你让它“看看现在屏幕上是什么”,它很配合地开始工作,然后告诉你:我这边只看到一个文件路径。于是你开始怀疑服务器没配好、缓存目录权限不对、模型不支持视觉……排查一圈才发现,图一直都在,只是被拦在工具结果这一层,从没真正交到模型手上。这个坑在 10 月 6 日合并的两个改动里被填掉了,而且改法不是“给 MCP 单独开个后门”,而是把四条路径合并成同一个判断。
之前发生了什么
MCP 工具的 ImageContent 会被写进 Hermes 的图片缓存,然后在结果里以一行 MEDIA:/path/to/image.png 的形式返回。这本身是有用的(任何支持附件的界面都能让你把这文件取出来),但它从来没把图片本身附加到工具结果上。于是出现一种很别扭的状态:
- 你用一个能看图的模型当主力(比如
supports_vision=True的模型); - MCP 服务器返回了截图;
- 模型只拿到路径字符串,于是它诚实地告诉你它看不到图像。
最尴尬的例子是原生的 cua-driver MCP 服务器:它本来做的就是“截屏给你看”,结果整个屏幕它都看不到。同类问题还出现在 computer_use 的截屏上:那条路径只检查“provider 是否携带工具结果媒体”,从不看 agent.image_input_mode,也不看目录里是否标注了这个模型看不见图。后果是:在一个只有文本能力的模型上(代码里举的例子是 OpenRouter 上的 deepseek-v3.2),截屏会被判成“走原生”,然后 agent 的兜底逻辑把图片换成一句“请换成支持视觉的模型”,而你明明配好的辅助视觉模型压根没被调用。你设的 image_input_mode: text 也照样被无视。
现在:唯一一道门禁
改动把判断收敛到一个函数:tools.vision_tools._native_tool_result_images(provider, model, cfg)。它的含义是:这张图能不能真的把像素交给模型? 条件是两个同时成立——图像路由解析为 native(由 agent.image_input_mode、显式配置的 auxiliary.vision 后端、模型目录三方共同决定)并且这条线路接受“工具结果里带图片”。
函数上一句注释写得很直白:同一道谓词,所以这条通道不再取决于图片是哪个工具产生的。现在走同一道门禁的有四个来源:
| 来源 | 之前 | 现在 |
|---|---|---|
vision_analyze |
本来就正确 | 不变 |
| 浏览器截图 | 本来就正确 | 不变 |
computer_use 截屏 |
忽略 image_input_mode,对纯文本模型也走原生 |
与门禁一致,纯文本模型交给辅助视觉模型描述 |
MCP ImageContent |
只给 MEDIA: 路径 |
能原生看图时把像素一并附加 |
MCP 这一路的具体处理是:从本次调用自己写的缓存文件里取图(绝不从服务器返回的文本里解析路径),重新编码成 provider 接受的格式,按 vision.embed_target_bytes(默认 256 KiB,夹在 64 KiB–4 MiB 之间)和 1568 px 上限规整,每个结果最多 4 张——因为图片会被之后每一轮请求重新发送。缩放跑在工具线程上,不占 MCP 共用的循环。文本那一半保留 MEDIA: 路径,所以“取文件”这条路仍然通。插件通过 ctx.call_mcp 拿到的仍然是字符串,契约没变。
三种模式,行为各不相同
看这个门禁之前,先弄清 agent.image_input_mode 的三个取值——它决定了“像素到底要不要进对话历史”:
agent:
image_input_mode: auto # auto(默认)| native | textauto(默认):模型报告supports_vision=True且你没有显式指定auxiliary.vision.provider,就走原生;否则走文本描述。native:总是把图附到工具结果里。代价是纯文本模型要么在 provider 那一步报错,要么吃到一次“最后一搏”的文本回退——所以别对看不见图的模型开这个。text:总是先用vision_analyze预先分析,把描述前置。这条路的意义是像素永远不进历史——对那些不想把截图交给主力模型、或者按图计费的场景,这是你想要的档位。
顺手记住一条老规则:代理别名(catalog 不认识的模型名)在 auto 下会被送去辅助视觉模型,想让它走原生就得显式写 native。
一个实际结论:如果你接了截图类 MCP 服务器、主力模型本身能看图,那么默认的 auto 就能工作;如果你之前为了绕开“模型看不到图”把 image_input_mode 改成了 text,现在可以改回 auto 让它真正拿到像素——代价是每次请求都带着那张图。
两个容易忽略的安全处理
MCP 结果是不受信任的输入,这两个细节值得知道:
- 不可见的 TAG 字符会被剥掉。 U+E0000–U+E007F 这一段字符在终端和聊天界面里完全不显示,但模型看得见——这是恶意或被攻陷的服务器夹带提示注入的经典通道。Hermes 会把它们从工具结果、资源内容和工具描述里剥除;合法的 emoji 标签序列(比如 🏴 这类区域旗帜)会被保留。
- 厂商
_meta会透传,协议保留键不会。 服务器挂在工具结果上的_meta映射(例如com.example/handoff这种厂商命名空间)会连同结果一起给模型;但modelcontextprotocol、mcp这类协议保留前缀下的键会被丢掉。如果剥完没有面向模型的内容,_meta字段整个不出现。
自查清单
- 模型看不到 MCP 图片 → 先确认这一路是否走了原生:看
agent.image_input_mode是不是text,以及是否显式设了auxiliary.vision.provider(设了就一定走辅助描述)。 - 说明“图太大看不清” → 抬高
vision.embed_target_bytes(上限 4 MiB),不过要注意它会被每一轮重发,长对话里会持续占上下文。 - 一个结果里有很多张图 → 最多附加 4 张;其余仍以
MEDIA:路径形式留在文本里,需要哪张就明确让 agent 用vision_analyze处理。 - 只想知道屏幕上有什么、又不想把截图留在历史里 → 显式设
image_input_mode: text。
小结
- MCP 的
ImageContent以前只给路径,所以能看图的模型也读不到像素。 - 现在
tools.vision_tools._native_tool_result_images是唯一门禁,vision_analyze、浏览器截图、computer_use截屏、MCP 图片四路共用。 image_input_mode三档语义:auto看模型能力、native总是附加、text只走辅助描述(像素不进历史)。- MCP 结果会被剥离不可见 TAG 字符,协议保留的
_meta键不会传给模型。
关于 MCP 这条链,站内还有两份可以直接配合着读:MCP 配置里的上下文变量讲怎么用变量把配置和上下文对齐,MCP 目录的安全边界讲第三方服务器进来之后该怎么设防线。