Ein MCP-Server schickte einen Screenshot, und dein Modell sah nur einen Dateipfad
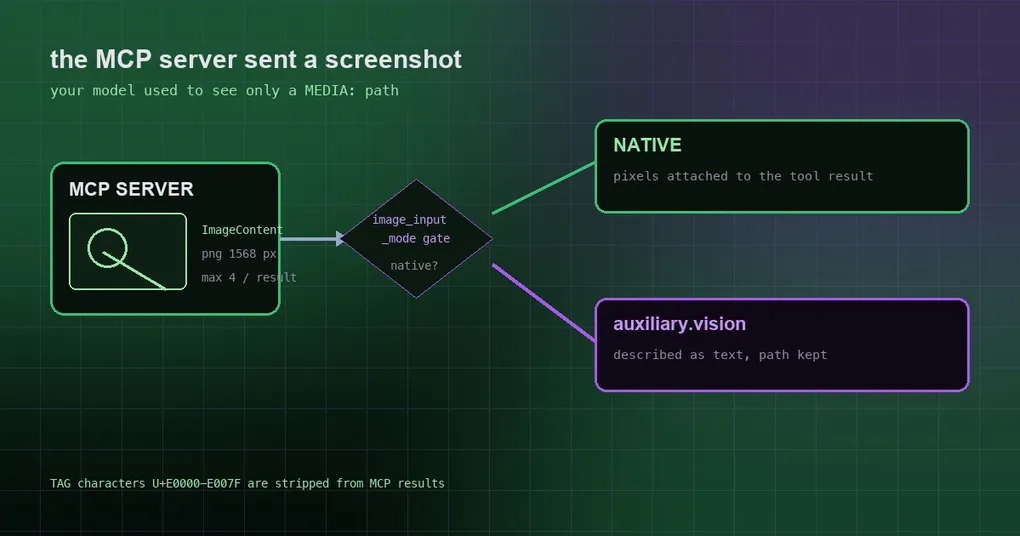
Du verbindest einen MCP-Server, der den Bildschirm erfassen kann — die Sorte, die den Shot selbst macht und ihn als Ergebnis zurückgibt. Du bittest Hermes, sich anzusehen, was gerade auf dem Bildschirm ist. Er macht sich pflichtbewusst an die Arbeit und meldet dann zurück: Ich kann nur einen Dateipfad sehen. Also fängst du an, die Server-Config zu verdächtigen, dann die Rechte des Cache-Verzeichnisses, dann, ob das Modell überhaupt Vision unterstützt. Schließlich findest du heraus, dass das Bild die ganze Zeit da war — es hat es nur nie an der Tool-Result-Ebene vorbei in die Hände des Modells geschafft. Zwei am 6. Oktober gemergte Änderungen haben dieses Loch geschlossen, und der Fix ist nicht „eine Hintertür für MCP öffnen“: Es ist das Zusammenfalten von vier Pfaden zu einer Entscheidung.
Was früher passierte
Das ImageContent eines MCP-Tools wird in den Image-Cache von Hermes geschrieben und im Ergebnis als MEDIA:/path/to/image.png-Zeile zurückgegeben. Das ist für sich genommen wirklich nützlich — jede anhangfähige Oberfläche lässt dich die Datei herausziehen —, aber das Bild selbst wurde dem Tool-Result nie angehängt. Das erzeugte einen unangenehmen Zustand:
- dein Hauptmodell kann Bilder sehen (
supports_vision=True); - der MCP-Server gab einen Screenshot zurück;
- das Modell bekam einen Pfad-String und sagte dir wahrheitsgemäß, dass es das Bild nicht sehen kann.
Der peinlichste Fall ist ein roher cua-driver-MCP-Server: Seine ganze Aufgabe ist es, den Bildschirm für dich zu erfassen, und er konnte den Bildschirm überhaupt nicht sehen. Dasselbe Problem steckte in computer_use-Captures, deren Route nur prüfte, „trägt der Provider Tool-Result-Media“ — sie schaute nie auf agent.image_input_mode, noch auf ein Katalog-Urteil, dass das Modell keine Bilder sehen kann. Also ging bei einem Text-only-Modell (der Commit nennt deepseek-v3.2 auf OpenRouter) die Capture den nativen Weg, der Backstop des Agenten tauschte den Screenshot gegen eine Nachricht „wechsle zu einem vision-fähigen Modell“ aus, und das Aux-Vision-Modell, das du konfiguriert hattest, lief nie. image_input_mode: text wurde auch für Screenshots ignoriert.
Jetzt: ein Gate für all das
Der Fix faltet die Entscheidung in eine Funktion: tools.vision_tools._native_tool_result_images(provider, model, cfg). Sie beantwortet eine einzige Frage — kann dieses Bild dem Modell wirklich Pixel übergeben? — und zwei Dinge müssen gelten: Das Image-Routing löst zu native auf (entschieden durch agent.image_input_mode, ein explizit konfiguriertes auxiliary.vision-Backend und den Modellkatalog zusammen) und die Route akzeptiert Bilder in Tool-Results.
Sein Docstring sagt es klar: „Ein Prädikat, damit die Spur nie davon abhängt, welches Tool das Bild erzeugt hat.“ Vier Quellen gehen jetzt durch dasselbe Gate:
| Quelle | Vorher | Jetzt |
|---|---|---|
vision_analyze |
bereits korrekt | unverändert |
| Browser-Screenshots | bereits korrekt | unverändert |
computer_use-Captures |
ignorierte image_input_mode, ging auch auf Text-only-Modellen nativ |
folgt dem Gate; Text-only-Modelle bekommen die Aux-Vision-Beschreibung |
MCP ImageContent |
nur Pfad | Pixel werden angehängt, wann immer die Route sie nativ annehmen kann |
Für den MCP-Pfad speziell: Das Bild stammt aus dem Cache-Schreibvorgang dieses Aufrufs selbst (Pfade werden nie aus Server-Text geparst), wird in ein vom Provider akzeptiertes Format neu kodiert und auf vision.embed_target_bytes (standardmäßig 256 KiB, geklemmt zwischen 64 KiB und 4 MiB) und eine Obergrenze von 1.568 px skaliert, höchstens 4 pro Ergebnis — weil das Bild bei jeder späteren Anfrage erneut gesendet wird. Die Größenänderung läuft auf dem Tool-Thread, abseits der geteilten MCP-Schleife. Die Text-Hälfte behält ihre MEDIA:-Pfade, also funktioniert „gib mir die Datei“ weiterhin, und Plugins, die ctx.call_mcp aufrufen, erhalten weiterhin einen String.
Drei Modi, drei Verhalten
Bevor du über das Gate nachdenkst, kenne die drei Werte von agent.image_input_mode, die entscheiden, ob Pixel überhaupt in die Konversations-History gelangen:
agent:
image_input_mode: auto # auto (default) | native | textauto(Default): nativ, wenn das Modellsupports_vision=Truemeldet und duauxiliary.vision.providernicht explizit gesetzt hast; andernfalls die Text-Route.native: das Bild wird immer an das Tool-Result angehängt. Ein Text-only-Modell bekommt dann entweder einen Fehler beim Provider oder einen Text-Fallback als letzte Chance — also schalte das nicht für Modelle ein, die nicht sehen können.text: immer vorab pervision_analyzeanalysieren und die Beschreibung voranstellen. Der Sinn dieser Spur ist, dass Pixel nie in die History gelangen — die richtige Einstellung, wenn du nicht willst, dass Screenshots zu deinem Hauptmodell gehen, oder wenn dein Provider pro Bild abrechnet.
Eine ältere Regel ist es wert, in Erinnerung zu bleiben: Proxy-Aliasse, die der Katalog nicht kennt, gehen unter auto zum Aux-Vision-Modell. Um die nativ zu halten, setze native explizit.
Eine praktische Schlussfolgerung: Wenn du einen Screenshot-artigen MCP-Server fährst und dein Hauptmodell Bilder schon sehen kann, funktioniert das Standard-auto jetzt einfach. Und wenn du image_input_mode zuvor auf text gesetzt hast, um „das Modell kann das Bild nicht sehen“ zu umgehen, kannst du es auf auto zurücksetzen, damit es die Pixel bekommt — zum Preis, dass dieses Bild bei jeder Anfrage mitgeführt wird.
Zwei Sicherheitsdetails, die leicht zu übersehen sind
MCP-Ergebnisse sind nicht vertrauenswürdige Eingaben, also zählen diese beiden:
- Unsichtbare TAG-Zeichen werden entfernt. Der Bereich U+E0000–U+E007F rendert in Terminals und Chat-UIs als nichts, ist aber für das Modell voll sichtbar — der klassische Schmuggelkanal für Prompt-Injection von einem bösartigen oder kompromittierten Server. Hermes entfernt sie aus Tool-Results, Ressourcen-Inhalten und Tool-Beschreibungen, während legitime Emoji-Tag-Sequenzen (Regionalflaggen wie 🏴) erhalten bleiben.
- Vendor-
_metawird sichtbar gemacht; protokollreservierte Keys nicht. Wenn ein Server ein_meta-Mapping anhängt (Vendor-Namespaces wiecom.example/handoff), wird es dem Modell zusammen mit dem Ergebnis übergeben. Keys unter protokollreservierten Präfixen wiemodelcontextprotocolodermcpwerden verworfen, und wenn nichts modellgerichtetes übrig bleibt, wird das_meta-Feld ganz weggelassen.
Eine kurze Selbstcheck-Liste
- Das Modell kann MCP-Bilder nicht sehen → bestätige, welche Spur diese Route nimmt: Ist
agent.image_input_modeauftextgesetzt, und istauxiliary.vision.providerexplizit gesetzt (was die Aux-Beschreibung erzwingt)? - Es sagt, das Bild sei zu klein zum Lesen → erhöhe
vision.embed_target_bytes(bis zu 4 MiB), und bedenke, dass es jeden Turn erneut gesendet wird und in langen Konversationen Kontext frisst. - Ein Ergebnis trägt viele Bilder → höchstens 4 werden angehängt; der Rest bleibt als
MEDIA:-Pfade im Text, also erbitte das benötigte pervision_analyze. - Du willst wissen, was auf dem Bildschirm ist, ohne den Screenshot in der History zu lassen → setze
image_input_mode: text.
Die Kurzfassung
- MCP
ImageContentmeldete früher nur einen Pfad, also las selbst ein vision-fähiges Modell keine Pixel. tools.vision_tools._native_tool_result_imagesist jetzt das einzige Gate, geteilt vonvision_analyze, Browser-Screenshots,computer_use-Captures und MCP-Bildern.- Die drei
image_input_mode-Werte:autofolgt der Fähigkeit des Modells,nativehängt immer an,texthält Pixel über den Aux-Beschreiber aus der History. - MCP-Ergebnisse haben unsichtbare TAG-Zeichen entfernt und protokollreservierte
_meta-Keys zurückgehalten.
Zwei andere Stücke passen gut zu diesem: Kontext-Variablen in der MCP-Config zum Abstimmen der Config auf den Kontext und die Sicherheitsgrenzen des MCP-Katalogs zum Härten, sobald Drittserver im Spiel sind.