Un servidor MCP envió una captura y tu modelo solo vio una ruta de archivo
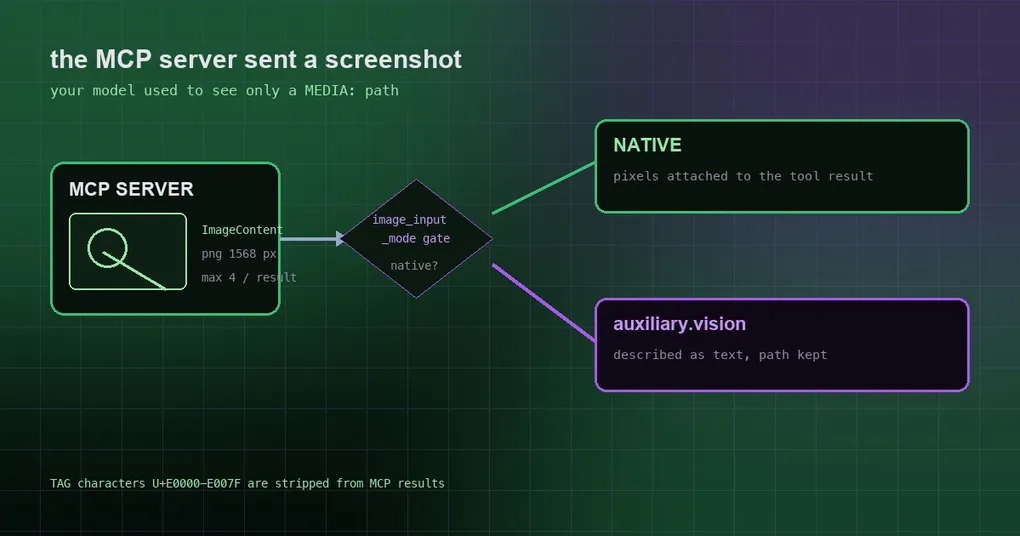
Conectas un servidor MCP capaz de capturar la pantalla — de esos que toman la captura ellos mismos y la devuelven como resultado. Le pides a Hermes que mire lo que hay ahora mismo en pantalla. Se pone a trabajar con diligencia y luego responde: todo lo que veo es una ruta de archivo. Así que empiezas a sospechar de la configuración del servidor, luego de los permisos del directorio de caché, y después de si el modelo admite visión siquiera. Al final descubres que la imagen había estado ahí todo el tiempo — simplemente nunca llegó más allá de la capa de resultados de la herramienta hasta las manos del modelo. Dos cambios fusionados el 6 de octubre cerraron este agujero, y el arreglo no es «abrir una puerta lateral para MCP»: es unir cuatro rutas en una sola decisión.
Qué pasaba antes
El ImageContent de una herramienta MCP se escribe en la caché de imágenes de Hermes y se devuelve en el resultado como una línea MEDIA:/path/to/image.png. Eso es realmente útil por sí solo — cualquier superficie que admita adjuntos te deja sacar el archivo —, pero la imagen en sí nunca se adjuntaba al resultado de la herramienta. Eso generaba una situación incómoda:
- tu modelo principal puede ver imágenes (
supports_vision=True); - el servidor MCP devolvía una captura de pantalla;
- el modelo recibía una cadena de ruta y te decía, con razón, que no puede ver la imagen.
El caso más bochornoso es un servidor MCP cua-driver en crudo: su único trabajo es capturar la pantalla para ti, y no podía ver la pantalla en absoluto. El mismo problema estaba en las capturas de computer_use, cuya ruta solo comprobaba «¿lleva el provider media de resultados de herramienta?» — nunca miraba agent.image_input_mode, ni un veredicto del catálogo de que el modelo no puede ver imágenes. Así que en un modelo solo de texto (el commit nombra deepseek-v3.2 en OpenRouter) la captura se enviaba en nativo, el mecanismo de respaldo del agent cambiaba la captura por un mensaje de «cambia a un modelo compatible con visión», y el modelo de visión auxiliar que habías configurado nunca se ejecutaba. image_input_mode: text también se ignoraba para las capturas.
Ahora: una sola puerta para todo
El arreglo reduce la decisión a una sola función: tools.vision_tools._native_tool_result_images(provider, model, cfg). Responde a una única pregunta — ¿puede esta imagen entregar de verdad los píxeles al modelo? — y se tienen que cumplir dos cosas: el enrutado de imágenes se resuelve a native (decidido por agent.image_input_mode, un backend auxiliary.vision configurado explícitamente y el catálogo de modelos en conjunto) y la ruta acepta imágenes dentro de los resultados de herramienta.
Su docstring lo dice claro: «Un único predicado, para que la vía nunca dependa de qué herramienta produjo la imagen.» Cuatro fuentes pasan ahora por esa misma puerta:
| Fuente | Antes | Ahora |
|---|---|---|
vision_analyze |
ya era correcto | sin cambios |
| Capturas del navegador | ya era correcto | sin cambios |
Capturas de computer_use |
ignoraba image_input_mode, se enviaba en nativo incluso en modelos solo de texto |
sigue la puerta; los modelos solo de texto reciben la descripción del modelo de visión auxiliar |
ImageContent de MCP |
solo la ruta | los píxeles se adjuntan siempre que la ruta pueda tomarlos en nativo |
Concretamente para la ruta MCP: la imagen se toma de la propia escritura en caché de esta llamada (las rutas nunca se extraen del texto del servidor), se recodifica a un formato aceptado por el provider y se ajusta a vision.embed_target_bytes (256 KiB por defecto, acotado entre 64 KiB y 4 MiB) y a un techo de 1.568 px, como máximo 4 por resultado — porque la imagen se reenvía en cada petición posterior. El cambio de tamaño se ejecuta en el hilo de la herramienta, fuera del bucle MCP compartido. La mitad de texto conserva sus rutas MEDIA:, así que «dame el archivo» sigue funcionando, y los plugins que llaman a ctx.call_mcp siguen recibiendo una cadena.
Tres modos, tres comportamientos
Antes de razonar sobre la puerta, conoce los tres valores de agent.image_input_mode, que deciden si los píxeles entran siquiera en el historial de la conversación:
agent:
image_input_mode: auto # auto (por defecto) | native | textauto(por defecto): nativo cuando el modelo informasupports_vision=Truey no has definido explícitamenteauxiliary.vision.provider; en caso contrario, la ruta de texto.native: adjunta la imagen al resultado de la herramienta siempre. Entonces un modelo solo de texto o bien da error en el provider, o bien recurre a un último fallback de texto — así que no lo actives para modelos que no pueden ver.text: preanaliza siempre convision_analyzey antepone la descripción. El sentido de esta vía es que los píxeles nunca entran en el historial — el ajuste correcto cuando no quieres que las capturas vayan a tu modelo principal, o cuando tu provider cobra por imagen.
Merece la pena recordar una regla más antigua: bajo auto, los alias de proxy que el catálogo no conoce van al modelo de visión auxiliar. Para mantenerlos en nativo, define native explícitamente.
Una conclusión práctica: si ejecutas un servidor MCP de capturas y tu modelo principal ya puede ver imágenes, el auto por defecto ahora funcionará sin más. Y si antes cambiaste image_input_mode a text para sortear «el modelo no puede ver la imagen», puedes volverlo a poner en auto para que reciba los píxeles — a costa de cargar con esa imagen en cada petición.
Dos detalles de seguridad fáciles de pasar por alto
Los resultados MCP son entrada no fiable, así que estos dos importan:
- Los caracteres TAG invisibles se eliminan. El rango U+E0000–U+E007F no se ve en terminales ni en interfaces de chat, pero es totalmente visible para el modelo — el canal clásico de contrabando para inyección de prompt desde un servidor malicioso o comprometido. Hermes los elimina de los resultados de herramienta, del contenido de recursos y de las descripciones de herramienta, mientras que las secuencias de tag de emoji legítimas (banderas regionales como 🏴) se conservan.
- El
_metadel fabricante se muestra; las claves reservadas del protocolo, no. Cuando un servidor adjunta un mapeo_meta(namespaces de fabricante comocom.example/handoff), se pasa al modelo junto con el resultado. Las claves bajo prefijos reservados del protocolo, comomodelcontextprotocolomcp, se descartan, y si no queda nada de cara al modelo, el campo_metase omite por completo.
Una breve lista de autocomprobación
- El modelo no ve las imágenes MCP → confirma qué vía toma esta ruta: ¿está
agent.image_input_modeentext, y estáauxiliary.vision.providerdefinido explícitamente (lo que fuerza la descripción auxiliar)? - Dice que la imagen es demasiado pequeña para leerla → sube
vision.embed_target_bytes(hasta 4 MiB), recordando que se reenvía en cada turno y se come contexto en conversaciones largas. - Un resultado lleva muchas imágenes → se adjuntan como máximo 4; el resto se quedan como rutas
MEDIA:en el texto, así que pide la que necesites convision_analyze. - Quieres saber qué hay en pantalla sin dejar la captura en el historial → define
image_input_mode: text.
Para terminar
- El
ImageContentde MCP solo informaba de una ruta, así que incluso un modelo capaz de visión no leía ningún píxel. tools.vision_tools._native_tool_result_imageses ahora la única puerta, compartida porvision_analyze, las capturas del navegador, las capturas decomputer_usey las imágenes de MCP.- Los tres valores de
image_input_mode:autosigue la capacidad del modelo,nativeadjunta siempre,textmantiene los píxeles fuera del historial mediante el descriptor auxiliar. - A los resultados MCP se les eliminan los caracteres TAG invisibles y se les retienen las claves
_metareservadas del protocolo.
Otras dos piezas encajan bien con esta: variables de contexto en la configuración MCP para alinear la configuración con el contexto, y los límites de seguridad del catálogo MCP para endurecer el entorno una vez que hay servidores de terceros en juego.