Um servidor MCP enviou uma captura de tela e o seu modelo viu apenas um caminho de arquivo
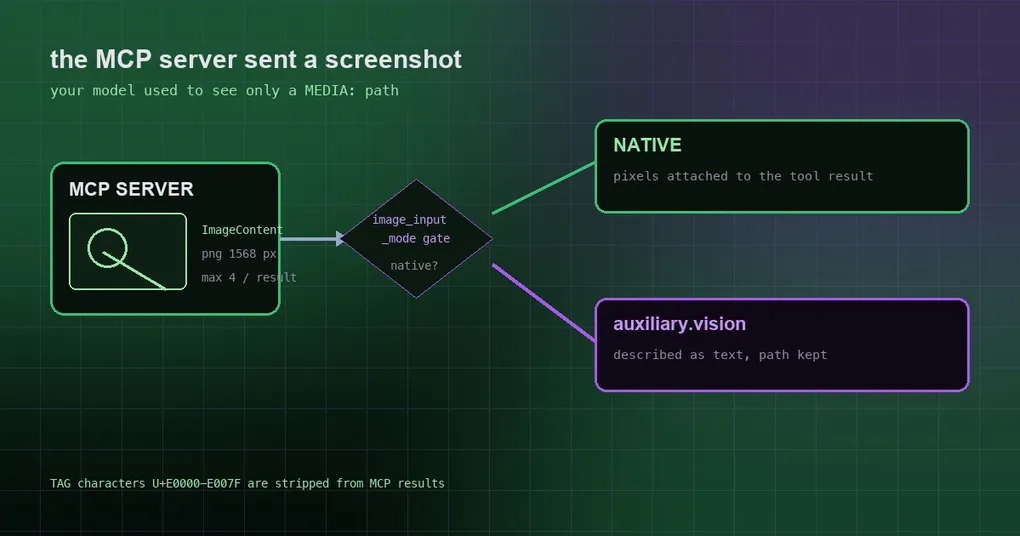
Você conecta um servidor MCP que consegue capturar a tela — do tipo que tira a foto sozinho e a devolve como resultado. Você pede ao Hermes para olhar o que está na tela agora. Ele obedientemente começa a trabalhar e então relata: tudo o que consigo ver é um caminho de arquivo. Aí você começa a suspeitar da config do servidor, depois das permissões do diretório de cache, e depois de o modelo suportar vision. No fim você descobre que a imagem estava lá o tempo todo — ela só nunca passou da camada de resultado da tool para as mãos do modelo. Duas mudanças mescladas em 6 de outubro fecharam esse buraco, e a correção não é “abrir uma porta lateral para o MCP”: é juntar quatro caminhos em uma única decisão.
O que acontecia antes
O ImageContent de uma tool MCP é gravado no cache de imagens do Hermes e devolvido no resultado como uma linha MEDIA:/path/to/image.png. Isso é genuinamente útil por si só — qualquer superfície que aceite anexos permite puxar o arquivo — mas a imagem em si nunca era anexada ao resultado da tool. Isso produzia um estado esquisito:
- o seu modelo principal consegue ver imagens (
supports_vision=True); - o servidor MCP devolveu uma captura de tela;
- o modelo recebeu uma string de caminho e, sinceramente, te disse que não consegue ver a imagem.
O caso mais embaraçoso é um servidor MCP cua-driver cru: o trabalho inteiro dele é capturar a tela para você, e ele não conseguia ver a tela de jeito nenhum. O mesmo problema estava nas capturas do computer_use, cujo caminho só checava “o provider carrega mídia de resultado de tool” — ele nunca olhava o agent.image_input_mode, nem um veredito do catálogo de que o modelo não consegue ver imagens. Então, num modelo somente texto (o commit cita deepseek-v3.2 no OpenRouter), a captura ia pelo caminho nativo, o backstop do agent trocava a captura por uma mensagem de “troque para um modelo com visão”, e o modelo de visão auxiliar que você tinha configurado nunca rodava. O image_input_mode: text também era ignorado para capturas de tela.
Agora: um único portão para tudo
A correção funde a decisão em uma única função: tools.vision_tools._native_tool_result_images(provider, model, cfg). Ela responde a uma só pergunta — esta imagem consegue realmente entregar pixels ao modelo? — e duas coisas precisam valer: o roteamento de imagem resolve para native (decidido em conjunto pelo agent.image_input_mode, por um backend auxiliary.vision configurado explicitamente e pelo catálogo de modelos) e a rota aceita imagens dentro de resultados de tool.
A docstring dela diz de forma direta: “Um único predicado, para que a via nunca dependa de qual tool produziu a imagem.” Quatro fontes agora passam por esse mesmo portão:
| Fonte | Antes | Agora |
|---|---|---|
vision_analyze |
já correto | inalterado |
| Capturas de tela do navegador | já correto | inalterado |
Capturas do computer_use |
ignorava image_input_mode, ia pelo caminho nativo até em modelos somente texto |
segue o portão; modelos somente texto recebem a descrição da visão auxiliar |
MCP ImageContent |
só caminho | pixels anexados sempre que a rota consegue recebê-los nativamente |
Para o caminho MCP especificamente: a imagem é tirada da própria gravação de cache desta chamada (caminhos nunca são extraídos do texto do servidor), recodificada num formato aceito pelo provider e dimensionada para vision.embed_target_bytes (256 KiB por padrão, limitado entre 64 KiB e 4 MiB) e um teto de 1568 px, no máximo 4 por resultado — porque a imagem é reenviada em cada requisição seguinte. O redimensionamento roda na thread da tool, fora do loop MCP compartilhado. A metade texto mantém os seus caminhos MEDIA:, então “me dê o arquivo” ainda funciona, e plugins que chamam ctx.call_mcp ainda recebem uma string.
Três modos, três comportamentos
Antes de raciocinar sobre o portão, conheça os três valores de agent.image_input_mode, que decidem se os pixels entram ou não no histórico da conversa:
agent:
image_input_mode: auto # auto (padrão) | native | textauto(padrão): nativo quando o modelo reportasupports_vision=Truee você não definiuauxiliary.vision.providerexplicitamente; caso contrário, a rota de texto.native: sempre anexa a imagem ao resultado da tool. Um modelo somente texto então ou dá erro no provider ou usa um fallback de texto de última hora — então não ligue isso para modelos que não enxergam.text: sempre pré-analisa comvision_analyzee prepõe a descrição. O ponto desta via é que os pixels nunca entram no histórico — a configuração certa quando você não quer capturas de tela indo para o seu modelo principal, ou quando o seu provider cobra por imagem.
Uma regra mais antiga vale lembrar: aliases de proxy que o catálogo não conhece vão para o modelo de visão auxiliar sob auto. Para mantê-los nativos, defina native explicitamente.
Uma conclusão prática: se você roda um servidor MCP no estilo de captura de tela e o seu modelo principal já consegue ver imagens, o auto padrão agora simplesmente funciona. E se você antes trocou o image_input_mode para text para contornar “o modelo não consegue ver a imagem”, pode voltar para auto para que ele receba os pixels — ao custo de carregar essa imagem em cada requisição.
Dois detalhes de segurança fáceis de passar batido
Resultados MCP são entrada não confiável, então estes dois importam:
- Caracteres TAG invisíveis são removidos. A faixa U+E0000–U+E007F não aparece em terminais e UIs de chat mas é totalmente visível para o modelo — o canal clássico de contrabando para prompt injection vindo de um servidor malicioso ou comprometido. O Hermes os remove dos resultados de tool, do conteúdo de recursos e das descrições de tools, enquanto sequências legítimas de emoji tag (bandeiras regionais como 🏴) são preservadas.
- O
_metado fornecedor é exposto; chaves reservadas do protocolo não. Quando um servidor anexa um mapeamento_meta(namespaces de fornecedor comocom.example/handoff), ele é passado ao modelo junto com o resultado. Chaves sob prefixos reservados do protocolo, comomodelcontextprotocoloumcp, são descartadas, e se nada voltado ao modelo sobrar, o campo_metaé omitido por completo.
Uma breve lista de autoverificação
- O modelo não consegue ver imagens de MCP → confirme qual via esta rota toma: o
agent.image_input_modeestá emtext, e oauxiliary.vision.providerestá definido explicitamente (o que força a descrição auxiliar)? - Ele diz que a imagem é pequena demais para ler → aumente
vision.embed_target_bytes(até 4 MiB), lembrando que ela é reenviada a cada turno e come contexto em conversas longas. - Um resultado carrega muitas imagens → no máximo 4 são anexadas; o resto fica como caminhos
MEDIA:no texto, então peça a que você precisa viavision_analyze. - Você quer saber o que está na tela sem deixar a captura no histórico → defina
image_input_mode: text.
Para fechar
- O
ImageContentdo MCP antes só reportava um caminho, então até um modelo com visão não lia nenhum pixel. tools.vision_tools._native_tool_result_imagesagora é o único portão, compartilhado porvision_analyze, capturas de tela do navegador, capturas docomputer_usee imagens MCP.- Os três valores de
image_input_mode:autosegue a capacidade do modelo,nativesempre anexa,textmantém os pixels fora do histórico via o descritor auxiliar. - Resultados MCP têm caracteres TAG invisíveis removidos e chaves
_metareservadas do protocolo retidas.
Duas outras peças combinam bem com esta: variáveis de contexto na config do MCP para alinhar config com contexto, e as fronteiras de segurança do catálogo MCP para endurecer quando servidores de terceiros entram em jogo.