主模型的配额早就恢复了,Hermes 却还挂在替补上
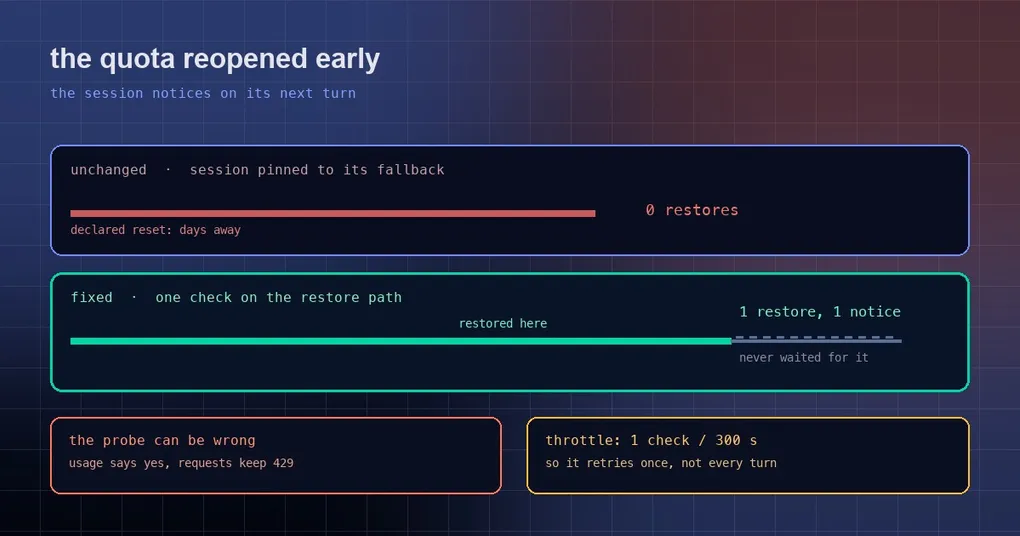
周五下午你的 Codex 用量打满了,Hermes 按设计切到备用模型,任务继续跑——这很对。周一早上你查了一下,配额明明早就恢复了,可那个一直开着的会话还在替补模型上打转,直到你重启它。这不是「保守」,是有一整条判断路径从来没被执行过。
这篇文章讲清楚切换与恢复各自在哪一步发生、为什么长驻会话会卡住、以及刚修好的那个反向问题:什么情况下宁可不恢复。
先理解 fallback 的时间尺度
Hermes 的 fallback 是按轮(turn-scoped)生效的:每一轮对话开始时,它都会尝试回到主模型;回得去就用主模型,回不去就留在替补上。这个设计的好处很明显——配额一恢复,下一轮就能自动回到主模型,不需要重启,也不需要手动切换。
挡住恢复的通常不是代码,而是时间。一次 429 会把主模型冷却到一个具体时间点,取的是提供方给出的 resets_at。对于按周计的窗口,这个时间点可能在好几天之后。如果实情反过来——配额因为充值、兑换重置或者套餐变更提前开了——那份冷却时间就变成了一个过于悲观的估计。
为什么长驻会话回不去
凭据池里其实早就有「提前恢复」的探测能力:一个被节流的 /usage 查询,专门用来发现配额提前打开的情况,这个能力已经迭代过不止一轮。
问题在于它挂在哪条路径上。这个探测只在 select() 里跑,也就是「从池子里挑一个可用凭据」的时候。而一个已经被 pin 在替补模型上的会话,永远不会走到 select()——它压根不去挑主模型的凭据,因为它当前根本不用主模型。
于是形成了一个安静的闭环:探针知道配额回来了,但没有人在问它;会话在等一个由提供方声明的、可能好几天后的时间点,或者干脆等你重启。
修法:把「尝试回主模型」当成探测点
PR #130716 的做法是把这次探测接到恢复路径上:
CredentialPool新增lift_reopened_cooldowns():做select()会做的那件「清掉已经过期、或者已经提前恢复的冷却」的事,但不租借任何凭据——纯粹是问一句「现在有可用的吗」。restore_primary_runtime在发现主模型池被 bench 住时调用它。如果有条目重新可用,就清掉冷却,让正常的恢复流程继续往下走。- 失败时保留两边的冷却。 任何异常都当作「还不确定」,而不是「回主模型试试」;这条路径只对主模型是 Codex 的情况生效。
这一步之后,上面那个闭环就断了:会话每次尝试回主模型时都会顺带问一句探针,配额一恢复,下一轮就回得去。
反面:探针说谎的时候,别每轮都试一遍
同一份 PR 里还有一半故事更值得读——它解释了「为什么不能无脑恢复」。
探针的判定是缓存的,有效期 300 秒,而一个新的 429 不会把这个缓存清掉。于是存在一种很尴尬的状态:/usage 说还有额度,但真实请求继续 429。
如果不加节流,恢复流程会变成一台没有刹车的机器:恢复主模型 → 请求失败 → 回退到替补 → 下一轮再来一遍。PR 里给了一张三轮对比表,数字很直观:
| 场景 | 修复前 | 第一版修复 | 现在 |
|---|---|---|---|
| 真的提前恢复 | 一直留在替补 | 恢复 | 恢复 |
| 探针说谎、主模型继续 429、连续 6 轮 | 0 次恢复 | 6 次恢复、6 次失败调用、6 条提示 | 1 次恢复、1 次失败调用、1 条提示 |
现在的做法是:每个 agent 每 300 秒最多检查一次(节流常量是 300 秒),而且节流的时间戳在加载凭据池之前就打上。夹在中间的那些轮次连池子都不会去碰——反正它们只能读到同一份缓存判定。
你的机器上该看什么
- 这条路径是 Codex 主模型专属的。 其他提供方的 fallback 行为没有变化,如果你用的不是 Codex,这次改动不会影响你。
- 别用重启来「恢复」。 长驻的 gateway 和 CLI 会话现在会自己回来;如果它没回来,先确认是「探针说没有额度」还是「探针说有额度但请求一直失败」,这两种情况的处理方式完全不同。
- 手动控制和观察。 查询与切换的入口在 hermes fallback 命令参考;三层 fallback 的设计(凭据轮换、模型回退、链式回退)见 fallback 的三层结构。
- 版本状态。 修复在 2026-10-01 合并进
main,最新标签 v0.21.5 的日期是 9-24,所以标签里还没有它;跟进main的 git 安装已经在修复里。
小结
这次的形状是「两条正确的逻辑,但接错了位置」:提前恢复的探测早就存在,恢复主模型的流程也早就存在,只是它们谁也没调用谁,于是长驻会话一直停在一个过于悲观的等值上。修法也很朴素——把探测挂到恢复路径上,而不是新造一套机制。
而另一半更有意思:加一条恢复路径,就必须同时加一道节流。 一个会撒谎的探针配上一个每轮都执行的恢复动作,带来的不是更快的恢复,而是每一轮都白试一次。修复最后交付的是两个数字——真恢复了就恢复,探针撒谎时最多试一次——而不是「更积极」。