Votre quota Codex a rouvert depuis des jours, mais Hermes reste sur le fallback
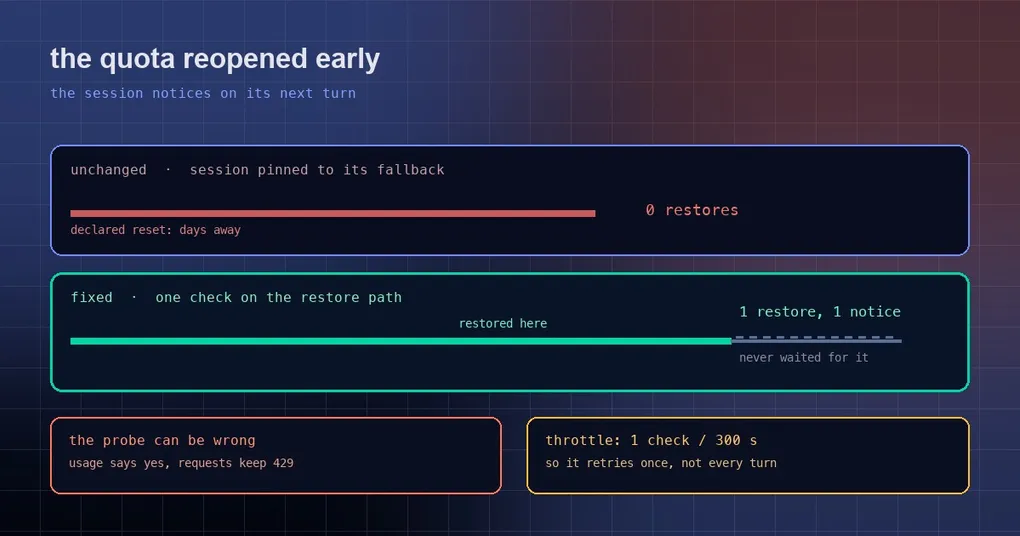
Votre quota Codex s’épuise un vendredi après-midi. Hermes bascule sur un modèle de fallback et le travail continue — exactement comme prévu. Le lundi matin, vous vérifiez : le quota est ouvert depuis un moment, et pourtant cette session de longue durée répond toujours depuis le fallback jusqu’à ce que vous la redémarriez. Ce n’est pas de la prudence. C’est tout un chemin de décision qui n’a jamais été appelé.
Voici où se produisent respectivement la bascule et la restauration, pourquoi une session de longue durée se bloque, et le problème inverse que le même correctif devait résoudre : quand il vaut mieux ne pas restaurer du tout.
L’échelle de temps sur laquelle le fallback fonctionne réellement
Le fallback de Hermes s’applique tour par tour (turn-scoped) : au début de chaque tour, il tente de revenir au modèle principal. S’il y parvient, il le fait ; sinon, il reste sur le fallback. C’est une bonne conception — dès qu’un quota rouvre, le tour suivant rentre à la maison, sans redémarrage ni bascule manuelle.
Ce qui bloque la restauration n’est en général pas le code, mais le temps. Un 429 met le modèle principal en cooldown jusqu’à un instant précis, tiré du resets_at du provider. Pour une fenêtre hebdomadaire, cet instant peut être à plusieurs jours de distance. Et quand la réalité s’avère inverse — le quota a rouvert plus tôt à cause d’une recharge, d’un reset racheté ou d’un changement de formule — ce cooldown n’est plus qu’une estimation pessimiste.
Pourquoi une session de longue durée ne revient jamais
Le pool de credentials savait déjà détecter une réouverture anticipée : une sonde /usage throttlée, retravaillée plus d’une fois. Le problème, c’est le chemin sur lequel elle est accrochée. La sonde ne tourne qu’à l’intérieur de select() — le code qui choisit un credential utilisable dans le pool. Une session déjà pin sur son fallback n’atteint jamais select(), parce qu’elle ne demande pas de credential principal du tout.
Il en résulte une boucle silencieuse : la sonde sait que le quota est revenu, mais personne ne l’interroge ; la session attend un instant déclaré par le provider, qui peut être à plusieurs jours de là, ou un redémarrage.
Le correctif : faire de « tenter de rentrer à la maison » le point de sonde
La PR #130716 accroche cette vérification sur le chemin de restauration :
CredentialPool.lift_reopened_cooldowns()exécute la partie deselect()qui efface les cooldowns expirés ou rouverts par anticipation, mais sans réserver de credential — elle demande seulement « y a-t-il quelque chose de disponible maintenant ? ».restore_primary_runtimel’appelle quand le pool principal est écarté. Si une entrée redevient utilisable, le cooldown est effacé et la restauration normale se poursuit.- En cas d’erreur, les deux cooldowns restent en place. Le doute se résout en « pas encore », jamais en « essaie le principal quand même », et le chemin ne s’applique que lorsque le principal est un provider Codex.
Une fois cela en place, la boucle est brisée : chaque tentative de retour au principal interroge aussi la sonde, si bien qu’un quota rouvert est détecté au tour suivant.
L’autre moitié : ne pas réessayer à chaque tour quand la sonde ment
La moitié la plus intéressante de la même PR explique pourquoi une restauration naïve serait pire que pas de restauration du tout.
Le verdict de la sonde est mis en cache pendant 300 secondes, et un nouveau 429 n’efface pas ce cache. Il existe donc un état gênant où /usage annonce qu’il reste du quota alors que les vraies requêtes continuent de renvoyer 429. Sans throttle, le chemin de restauration devient une machine sans freins : restaurer le principal, échouer, retomber sur le fallback, et refaire toute la danse au tour suivant. Le tableau de validation de la PR le montre concrètement :
| Scénario | Avant | Première version du correctif | Maintenant |
|---|---|---|---|
| Une vraie réouverture anticipée | reste sur le fallback | restaure | restaure |
| La sonde ment, le principal renvoie 429, 6 tours | 0 restauration | 6 restaurations, 6 appels échoués, 6 notifications | 1 restauration, 1 appel échoué, 1 notification |
La règle est désormais au plus une vérification par intervalle de sonde de 300 secondes et par agent, et le throttle est horodaté avant le chargement du pool. Les tours intermédiaires ne touchent même pas le pool — de toute façon, ils ne pourraient que rejouer le même verdict mis en cache.
Ce qu’il faut regarder sur votre machine
- Ce chemin est spécifique à un principal Codex. Le comportement de fallback des autres providers est inchangé ; si votre principal n’est pas Codex, ce correctif ne change rien pour vous.
- Ne prenez pas un redémarrage pour le correctif. Les sessions gateway et CLI de longue durée reviennent maintenant d’elles-mêmes. Si la vôtre ne revient pas, déterminez d’abord si la sonde dit « pas de quota » ou « quota oui, mais les requêtes échouent encore » — les deux exigent un traitement complètement différent.
- Contrôle et inspection manuels. Les points d’entrée pour interroger et basculer se trouvent dans la référence hermes fallback ; les trois couches du mécanisme (rotation des credentials, fallback de modèle, fallback chaîné) sont traitées dans les trois couches du fallback.
- Quel build l’a. Le correctif a été fusionné dans
mainle 2026-10-01, et le tag le plus récent (v0.21.5) date du 24/09, donc il n’est pas encore dans le tag. Les installations Git qui suiventmainl’ont déjà.
À retenir
La forme, ici, ce sont deux morceaux de logique corrects reliés à rien : la sonde de réouverture anticipée existait déjà, le flux de restauration existait déjà, et aucun n’appelait l’autre — si bien que les sessions de longue durée restaient campées sur une estimation pessimiste. Le correctif n’a rien de glamour : accrocher la sonde sur le chemin de restauration au lieu d’inventer un nouveau mécanisme.
L’autre moitié est la partie à retenir. Chaque chemin de restauration a besoin d’un throttle assorti. Une sonde qui peut se tromper, combinée à une restauration qui s’exécute à chaque tour, ne vous achète pas une reprise plus rapide — elle vous achète une tentative ratée par tour. Ce qui a été livré, ce sont deux nombres — restaurer quand c’est réel, essayer une fois quand la sonde ment — et non « plus agressif ».