Dein Codex-Kontingent ist seit Tagen wieder offen – Hermes hängt trotzdem am Fallback
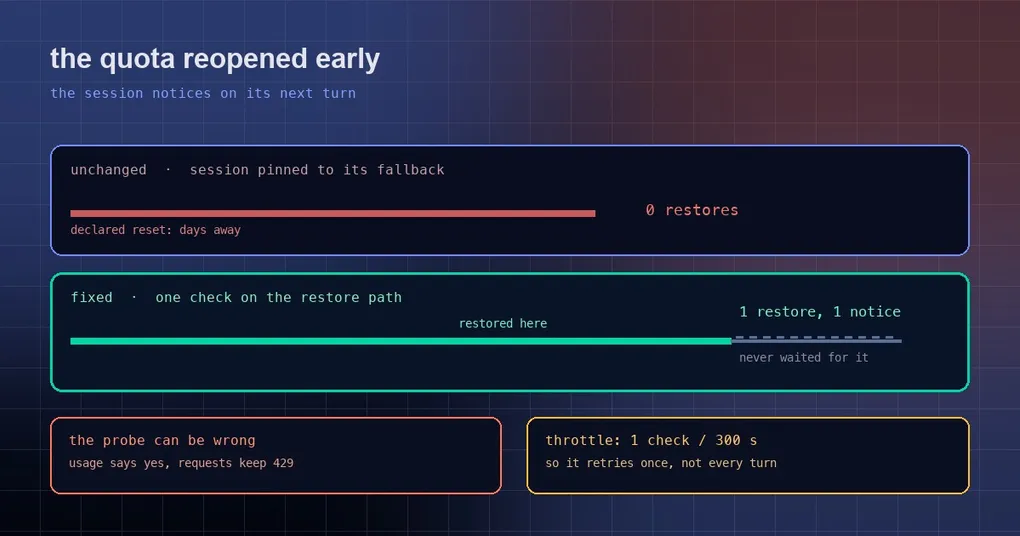
Dein Codex-Kontingent läuft an einem Freitagnachmittag aus. Hermes wechselt auf ein Fallback-Modell, und die Arbeit läuft weiter – genau wie vorgesehen. Am Montagmorgen schaust du nach, und das Kontingent ist schon seit einer Weile wieder offen, doch diese dauerhaft laufende Sitzung antwortet noch immer über das Fallback, bis du sie neu startest. Das ist keine Vorsicht. Es ist ein ganzer Entscheidungspfad, der nie aufgerufen wurde.
Hier steht, wo der Wechsel und wo die Wiederherstellung jeweils stattfinden, warum eine langlebige Sitzung hängen bleibt, und das umgekehrte Problem, das derselbe Fix lösen musste: wann es besser ist, überhaupt nicht wiederherzustellen.
Die Zeitskala, auf der das Fallback tatsächlich arbeitet
Hermes’ Fallback gilt pro Turn (turn-scoped): Zu Beginn jedes Turns versucht es, zum Primärmodell zurückzukehren. Wenn es kann, tut es das; wenn nicht, bleibt es beim Fallback. Das ist ein gutes Design – sobald ein Kontingent wieder offen ist, kehrt der nächste Turn von selbst zurück, ohne Neustart und ohne manuelles Umschalten.
Was die Wiederherstellung blockiert, ist meistens nicht der Code, sondern die Zeit. Ein 429 versetzt das Primärmodell in eine Abkühlphase bis zu einem bestimmten Zeitpunkt, der aus dem resets_at des Providers stammt. Bei einem wöchentlichen Fenster kann dieser Zeitpunkt Tage entfernt liegen. Und wenn sich die Wahrheit als das Gegenteil herausstellt – das Kontingent ist wegen einer Aufladung, eines eingelösten Resets oder eines Tarifwechsels vorzeitig wieder offen – dann ist diese Abkühlphase schlicht eine pessimistische Schätzung.
Warum eine langlebige Sitzung nie zurückkommt
Der Credential-Pool besaß bereits die Fähigkeit, ein frühes Wiederöffnen zu bemerken: eine gedrosselte /usage-Prüfung, an der mehr als einmal nachgebessert wurde. Das Problem ist, an welchem Pfad sie hängt. Die Prüfung läuft nur innerhalb von select() – dem Code, der ein nutzbares Credential aus dem Pool auswählt. Eine Sitzung, die bereits an ihr Fallback gepinnt ist, erreicht select() nie, weil sie überhaupt kein Primär-Credential anfragt.
Das erzeugt eine stille Schleife: Die Prüfung weiß, dass das Kontingent zurück ist, aber niemand fragt sie; die Sitzung wartet auf einen vom Provider erklärten Zeitpunkt, der Tage entfernt sein kann, oder auf einen Neustart.
Der Fix: „versuch, nach Hause zu kommen“ zum Prüfpunkt machen
PR #130716 hängt diese Prüfung an den Wiederherstellungspfad:
CredentialPool.lift_reopened_cooldowns()erledigt den Teil vonselect(), der abgelaufene oder früh wieder geöffnete Abkühlphasen aufhebt, aber ohne ein Credential zu leasen – er fragt nur „ist jetzt etwas verfügbar?“.restore_primary_runtimeruft ihn auf, wenn der Primär-Pool gebenched ist. Ist ein Eintrag wieder nutzbar, wird die Abkühlphase aufgehoben, und die normale Wiederherstellung läuft weiter.- Bei jedem Fehler bleiben beide Abkühlphasen erhalten. Zweifel lösen sich zu „noch nicht“ auf, nie zu „versuch es trotzdem mit dem Primärmodell“, und der Pfad greift nur, wenn das Primärmodell ein Codex-Provider ist.
Damit ist die Schleife durchbrochen: Jeder Versuch, zum Primärmodell zurückzukehren, fragt zugleich die Prüfung, sodass ein wieder geöffnetes Kontingent im nächsten Turn bemerkt wird.
Die andere Hälfte: bei einer lügenden Prüfung nicht jeden Turn neu versuchen
Die interessantere Hälfte desselben PR erklärt, warum eine naive Wiederherstellung schlechter wäre als gar keine.
Das Urteil der Prüfung wird 300 Sekunden lang zwischengespeichert, und ein frisches 429 löscht diesen Cache nicht. So entsteht ein unangenehmer Zustand: /usage meldet Restkontingent, aber echte Anfragen liefern weiter 429. Ohne Drosselung würde der Wiederherstellungspfad zu einer Maschine ohne Bremsen: Primärmodell wiederherstellen, scheitern, zurückfallen und im nächsten Turn das ganze Spiel erneut. Die Validierungstabelle des PR macht es konkret:
| Szenario | Vorher | Erste Version des Fixes | Jetzt |
|---|---|---|---|
| Ein echtes frühes Wiederöffnen | bleibt am Fallback | stellt wieder her | stellt wieder her |
| Prüfung lügt, Primärmodell liefert weiter 429, 6 Turns | 0 Wiederherstellungen | 6 Wiederherstellungen, 6 fehlgeschlagene Aufrufe, 6 Hinweise | 1 Wiederherstellung, 1 fehlgeschlagener Aufruf, 1 Hinweis |
Die Regel lautet jetzt höchstens eine Prüfung pro 300-Sekunden-Intervall je Agent, und der Throttle wird gestempelt, bevor der Pool geladen wird. Die dazwischenliegenden Turns berühren den Pool nicht einmal – sie könnten ohnehin nur dasselbe zwischengespeicherte Urteil wiederholen.
Worauf du auf deiner Maschine achten solltest
- Dieser Pfad ist Codex-Primär-spezifisch. Das Fallback-Verhalten aller anderen Provider ist unverändert; wenn du kein Codex als Primärmodell hast, ändert dieser Fix nichts für dich.
- Betrachte einen Neustart nicht als den Fix. Langlebige gateway- und CLI-Sitzungen kommen jetzt von selbst zurück. Wenn deine nicht zurückkommt, finde zuerst heraus, ob die Prüfung „kein Kontingent“ sagt oder „Kontingent ja, Anfragen scheitern weiterhin“ – die beiden brauchen völlig unterschiedliche Behandlung.
- Manuelle Steuerung und Inspektion. Die Einstiegspunkte zum Abfragen und Umschalten stehen in der hermes fallback-Referenz; die drei Ebenen des Mechanismus (Credential-Rotation, Modell-Fallback, verkettetes Fallback) sind in die drei Ebenen des Fallback behandelt.
- Welcher Build es enthält. Der Fix wurde am 2026-10-01 in
maingemergt, und das neueste Tag (v0.21.5) ist vom 9-24, also ist er noch nicht im Tag. Git-Installationen, diemainfolgen, haben ihn bereits.
Das Fazit
Die Form hier ist: zwei Stücke korrekter Logik, an nichts verdrahtet. Die Prüfung auf früh wieder geöffnete Kontingente existierte schon, der Wiederherstellungsablauf existierte schon, und keiner rief den anderen auf – deshalb saßen langlebige Sitzungen auf einer pessimistischen Schätzung fest. Der Fix ist unspektakulär: die Prüfung an den Wiederherstellungspfad hängen, statt einen neuen Mechanismus zu erfinden.
Die andere Hälfte ist der Teil, den man sich merken sollte. Jeder Wiederherstellungspfad braucht eine passende Drosselung. Eine Prüfung, die falsch liegen kann, kombiniert mit einer Wiederherstellung, die jeden Turn läuft, bringt dir keine schnellere Erholung – sie bringt dir einen fehlgeschlagenen Versuch pro Turn. Ausgeliefert wurden zwei Zahlen – wiederherstellen, wenn es echt ist, einmal versuchen, wenn die Prüfung lügt – nicht „aggressiver“.