Sua cota do Codex reabriu há dias, mas o Hermes continua no fallback
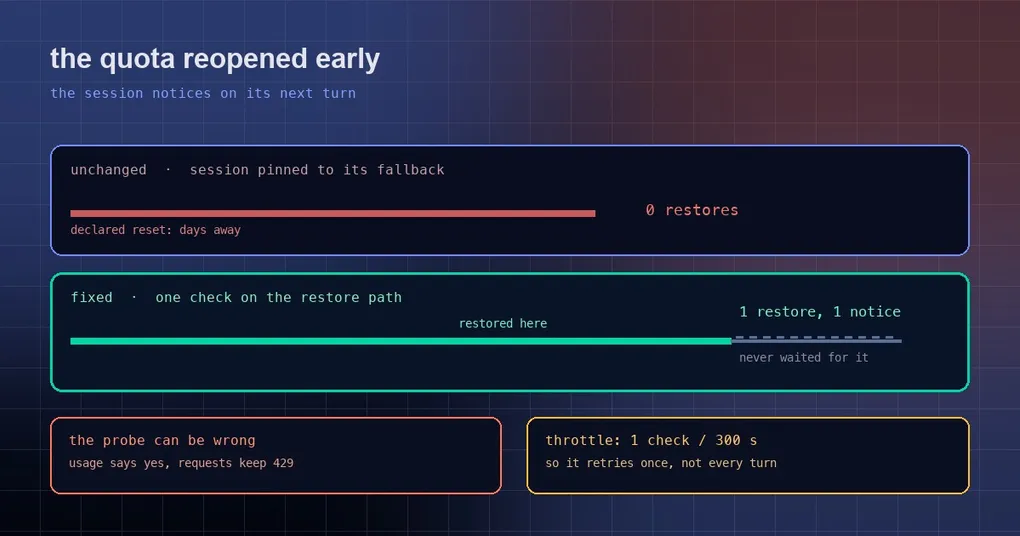
Sua cota do Codex acaba numa sexta-feira à tarde. O Hermes troca para um modelo de fallback e o trabalho continua — exatamente como projetado. Na manhã de segunda você verifica e a cota já está aberta há um tempo, mas aquela sessão de longa duração continua respondendo pelo fallback até você reiniciá-la. Isso não é cautela. É um caminho de decisão inteiro que nunca foi chamado.
Aqui está onde a troca e a restauração acontecem, por que uma sessão de longa duração fica presa, e o problema inverso que a mesma correção teve de resolver: quando é melhor não restaurar de modo algum.
A escala de tempo em que o fallback realmente opera
O fallback do Hermes é por turno (turn-scoped): no início de cada turno ele tenta voltar ao modelo primário. Se conseguir, volta; se não conseguir, permanece no fallback. Esse é um bom design — no momento em que uma cota reabre, o próximo turno volta para casa, sem reinício e sem troca manual.
O que bloqueia a restauração geralmente não é o código, mas o tempo. Um 429 coloca o primário em cooldown até um momento específico, obtido do resets_at do provider. Para uma janela semanal, esse momento pode estar a dias de distância. E quando a verdade acaba sendo o oposto — a cota reabriu cedo por causa de uma recarga, um reset resgatado ou uma mudança de plano — esse cooldown é simplesmente uma estimativa pessimista.
Por que uma sessão de longa duração nunca volta
O pool de credenciais já tinha a capacidade de perceber uma reabertura antecipada: uma sonda /usage com throttle, iterada mais de uma vez. O problema é em qual caminho ela está pendurada. A sonda só roda dentro de select() — o código que escolhe uma credencial utilizável do pool. Uma sessão já fixada no fallback nunca chega ao select(), porque não está pedindo uma credencial primária de modo algum.
Isso cria um loop silencioso: a sonda sabe que a cota voltou, mas ninguém pergunta a ela; a sessão espera por um momento declarado pelo provider que pode estar a dias de distância, ou por um reinício.
A correção: transformar “tentar voltar para casa” no ponto de sondagem
O PR #130716 pendura essa verificação no caminho de restauração:
CredentialPool.lift_reopened_cooldowns()executa a parte doselect()que limpa cooldowns vencidos ou reabertos antecipadamente, mas sem locar uma credencial — ela apenas pergunta “há algo disponível agora?”.restore_primary_runtimea chama quando o pool primário está benchado. Se uma entrada estiver utilizável de novo, o cooldown é limpo e a restauração normal prossegue.- Em qualquer erro, os dois cooldowns permanecem. A dúvida resolve para “ainda não”, nunca para “tente o primário de qualquer forma”, e o caminho só se aplica quando o primário é um provider Codex.
Com isso no lugar, o loop se rompe: toda tentativa de voltar ao primário também pergunta à sonda, então uma cota reaberta é percebida no turno seguinte.
A outra metade: não tentar de novo a cada turno quando a sonda mente
A metade mais interessante do mesmo PR explica por que uma restauração ingênua seria pior do que nenhuma.
O veredito da sonda é cacheado por 300 segundos, e um 429 novo não limpa esse cache. Então existe um estado incômodo em que /usage informa cota restante mas as requisições reais continuam retornando 429. Sem throttle, o caminho de restauração vira uma máquina sem freios: restaura o primário, falha, volta ao fallback e faz a dança toda de novo no turno seguinte. A tabela de validação do PR deixa isso concreto:
| Cenário | Antes | Primeira versão da correção | Agora |
|---|---|---|---|
| Uma reabertura antecipada genuína | permanece no fallback | restaura | restaura |
| Sonda mente, primário continua dando 429, 6 turnos | 0 restaurações | 6 restaurações, 6 chamadas falhas, 6 avisos | 1 restauração, 1 chamada falha, 1 aviso |
A regra agora é no máximo uma verificação por intervalo de sonda de 300 segundos por agent, e o throttle é marcado antes de o pool ser carregado. Os turnos intermediários nem tocam o pool — eles só poderiam repetir o mesmo veredito cacheado de qualquer forma.
O que observar na sua máquina
- Este caminho é específico para primário Codex. O comportamento de fallback para todos os outros providers não mudou; se você não está em um primário Codex, esta correção não altera nada para você.
- Não trate um reinício como a correção. Sessões de gateway e CLI de longa duração agora voltam sozinhas. Se a sua não voltar, primeiro descubra se a sonda diz “sem cota” ou “cota sim, requisições ainda falhando” — as duas precisam de tratamento completamente diferente.
- Controle manual e inspeção. Os pontos de entrada para consultar e trocar ficam na referência do hermes fallback; as três camadas do mecanismo (rotação de credenciais, fallback de modelo, fallback encadeado) são cobertas em as três camadas do fallback.
- Qual build tem isso. A correção foi mesclada no
mainem 2026-10-01, e a tag mais recente (v0.21.5) é de 9-24, então ainda não está na tag. Instalações via git que acompanham omainjá a têm.
A conclusão
A forma aqui é duas peças de lógica correta ligadas a nada: a sonda de reabertura antecipada já existia, o fluxo de restauração já existia, e nenhum chamava o outro — então sessões de longa duração ficavam sobre uma estimativa pessimista. A correção é sem glamour: pendurar a sonda no caminho de restauração em vez de inventar um mecanismo novo.
A outra metade é a parte que vale lembrar. Todo caminho de restauração precisa de um throttle correspondente. Uma sonda que pode errar, combinada com uma restauração que roda a cada turno, não te dá recuperação mais rápida — te dá uma tentativa falha por turno. O que foi entregue são dois números — restaure quando for real, tente uma vez quando a sonda mente — e não “mais agressivo”.