Tu cuota de Codex se reabrió hace días, pero Hermes sigue en el fallback
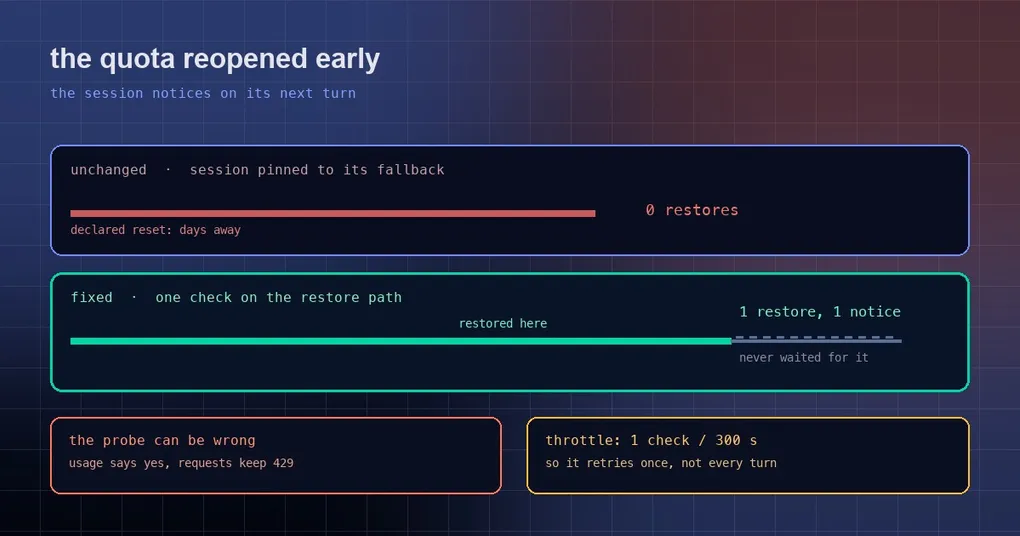
Tu cuota de Codex se agota un viernes por la tarde. Hermes cambia a un modelo de fallback y el trabajo sigue avanzando — exactamente como está diseñado. El lunes por la mañana lo compruebas y la cuota lleva un buen rato abierta, pero esa sesión de larga duración sigue respondiendo con el fallback hasta que la reinicias. Eso no es prudencia. Es toda una ruta de decisión que nunca llegó a ejecutarse.
Aquí veremos dónde ocurren el cambio y la restauración, por qué una sesión de larga duración se queda atascada, y el problema inverso que la misma solución tuvo que resolver: cuándo es mejor no restaurar en absoluto.
La escala temporal en la que el fallback realmente opera
El fallback de Hermes está acotado por turno (turn-scoped): al comienzo de cada turno intenta volver al modelo principal. Si puede, lo hace; si no, se queda en el fallback. Es un buen diseño — en el momento en que se reabre la cuota, el siguiente turno vuelve a casa, sin reinicio y sin cambio manual.
Lo que bloquea la restauración normalmente no es el código, sino el tiempo. Un 429 pone el principal en cooldown hasta un momento concreto, tomado del resets_at del provider. Para una ventana semanal ese momento puede estar a días de distancia. Y cuando la realidad resulta ser lo contrario — la cuota se reabrió antes de tiempo por una recarga, un reset canjeado o un cambio de plan —, ese cooldown no es más que una estimación demasiado pesimista.
Por qué una sesión de larga duración nunca regresa
El pool de credenciales ya tenía la capacidad de detectar una reapertura temprana: un probe /usage con throttle, iterado más de una vez. El problema es de qué ruta cuelga. El probe solo se ejecuta dentro de select() — el código que elige una credencial utilizable del pool. Una sesión ya pinned a su fallback nunca llega a select(), porque no está pidiendo ninguna credencial principal.
Eso crea un bucle silencioso: el probe sabe que la cuota ha vuelto, pero nadie se lo pregunta; la sesión espera un momento declarado por el provider que puede estar a días de distancia, o un reinicio.
La solución: convertir «intentar volver a casa» en el punto de sondeo
El PR #130716 cuelga esa comprobación de la ruta de restauración:
CredentialPool.lift_reopened_cooldowns()realiza la parte deselect()que limpia los cooldowns transcurridos o reabiertos antes de tiempo, pero sin arrendar una credencial — solo pregunta «¿hay algo disponible ahora?».restore_primary_runtimelo llama cuando el pool principal está en el banquillo. Si una entrada vuelve a ser utilizable, se limpia el cooldown y la restauración normal continúa.- Ante cualquier error, ambos cooldowns se mantienen. La duda se resuelve como «todavía no», nunca como «probemos el principal de todos modos», y la ruta solo se aplica cuando el principal es un provider Codex.
Con eso en su sitio, el bucle se rompe: cada intento de volver al principal también pregunta al probe, así que una cuota reabierta se detecta en el siguiente turno.
La otra mitad: no reintentar cada turno cuando el probe miente
La mitad más interesante del mismo PR explica por qué una restauración ingenua sería peor que ninguna.
El veredicto del probe se cachea durante 300 segundos, y un 429 nuevo no borra esa caché. Así que existe un estado incómodo en el que /usage dice que queda cuota pero las peticiones reales siguen devolviendo 429. Sin throttle, la ruta de restauración se convierte en una máquina sin frenos: restaura el principal, falla, vuelve al fallback, y repite toda la danza al siguiente turno. La tabla de validación del PR lo deja claro:
| Escenario | Antes | Primera versión de la solución | Ahora |
|---|---|---|---|
| Una reapertura temprana real | se queda en el fallback | restaura | restaura |
| El probe miente, el principal sigue devolviendo 429, 6 turnos | 0 restauraciones | 6 restauraciones, 6 llamadas fallidas, 6 avisos | 1 restauración, 1 llamada fallida, 1 aviso |
La regla ahora es como máximo una comprobación por intervalo de sondeo de 300 segundos y por agente, y el throttle se marca antes de cargar el pool. Los turnos intermedios ni siquiera tocan el pool: de todos modos solo podrían repetir el mismo veredicto cacheado.
Qué mirar en tu máquina
- Esta ruta es específica del principal Codex. El comportamiento del fallback para todos los demás providers no cambia; si no usas un principal Codex, esta solución no altera nada para ti.
- No tomes un reinicio como la solución. Las sesiones de gateway y CLI de larga duración ahora vuelven por sí solas. Si la tuya no lo hace, primero averigua si el probe dice «no hay cuota» o «sí hay cuota, pero las peticiones siguen fallando» — los dos casos necesitan un tratamiento completamente distinto.
- Control e inspección manual. Los puntos de entrada para consultar y cambiar viven en la referencia de hermes fallback; las tres capas del mecanismo (rotación de credenciales, fallback de modelo, fallback encadenado) se cubren en las tres capas del fallback.
- Qué build lo incluye. La solución se fusionó en
mainel 2026-10-01, y el tag más reciente (v0.21.5) tiene fecha del 9-24, así que todavía no está en el tag. Las instalaciones de git que siguenmainya lo tienen.
La conclusión
La forma que tiene esto son dos piezas de lógica correcta conectadas a nada: el probe de reapertura temprana ya existía, el flujo de restauración ya existía, y ninguno llamaba al otro — así que las sesiones de larga duración se quedaban sobre una estimación pesimista. La solución no tiene nada de glamuroso: colgar el probe de la ruta de restauración en lugar de inventar un mecanismo nuevo.
La otra mitad es la que merece recordarse. Toda ruta de restauración necesita un throttle a juego. Un probe que puede equivocarse, combinado con una restauración que se ejecuta cada turno, no te compra una recuperación más rápida: te compra un intento fallido por turno. Lo que se ha publicado son dos números — restaurar cuando es real, intentarlo una vez cuando el probe miente —, no «más agresivo».