备用模型全都挂了?一条命令给 fallback 链做体检
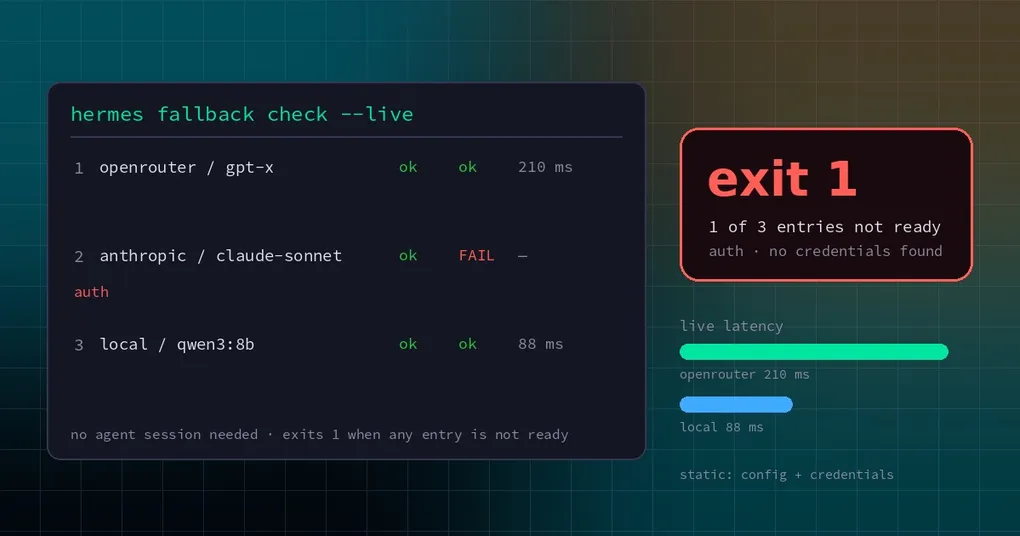
凌晨两点,主模型开始返回 429。你并不慌——早就配好了备用链:先换一家,再换本地的小模型。结果 Hermes 连着试了两条,两条都失败,任务直接中断。第二天你打开配置才发现:第一家的 key 上个月就轮换了,第二家的模型名在半年前的版本里改过一次,配置里那行从来没动过。备用链一直在,只是从来没被真正验证过。
这不是某个人粗心,而是“备用”这类东西的通病:平时不用,所以坏了也没人知道,直到最需要它的那一分钟。
一条命令,把“应该能用”变成“确实能用”
Hermes 新增了 hermes fallback check。它不启动 agent 会话、不消耗对话上下文,只做一件事:把你配置里的备用链逐条拿出来,检查它到底能不能用。
hermes fallback check          # 只看配置和凭据
hermes fallback check --live   # 每条真的发一次最小请求
hermes fallback check --json   # 给脚本读的结构化输出
任何一条不通,命令就以退出码 1 结束。这意味着你可以把它塞进 cron、塞进 CI、塞进部署前的检查清单——而不是等它在半夜替你失败。
先看看你现在的链长什么样:
hermes fallback # 等价于 hermes fallback list备用链保存在 config.yaml 的 fallback_providers 里,是一串 {provider, model, base_url?, api_mode?} 条目,按顺序尝试。老的 fallback_model 写法会自动并入,不会出现两份真相。要加一条,用 hermes fallback add,挑选器和 hermes model 是同一个。
静态检查:它问的是“切换那一刻会遇到什么”
不带 --live 时,命令做的是静态解析:用真正切换 fallback 时那套参数去解析每一条,看三件事。
第一,provider 认不认识。写错名字是配置错误,不是凭据问题,两者在报告里分得很清楚。
第二,凭据在不在。这一步查的是“真正的切换器会不会跳过这条”——因为切换逻辑本身就是按凭据决定跳过还是尝试,体检用同一套判断,才不会出现“体检说好、切过去还是失败”。
第三,解析出来的地址和协议对不对。base_url、api_mode 都会显示出来,方便你一眼看出某条还指着早已迁移的旧端点。
输出是一张表:
  #  Provider / model                            Config  Auth    Live    Latency   Status
  1  openrouter / gpt-x                         ok      ok      ok      210 ms    ready
  2  anthropic / claude-sonnet                  ok      FAIL    —       —         auth
3 local / qwen3:8b ok ok ok 88 ms readyConfig、Auth、Live 三列各自独立:Config 失败说明这条写的 provider 根本不存在,Auth 失败说明 provider 认识但没有可用凭据。静态模式下 Live 一列是横线,因为一次推理请求都没发。
--live:真的发一句话
静态检查能发现“没配好”,但发现不了“配好了却不能用”——额度耗尽、账号被封、模型下线、端点 502,这些只有真的发一次请求才知道。
--live 就是对每条静态通过(ready)的条目发一次最小请求:一句 Reply with exactly: OK,最多 512 token,超时取该 provider 自己的设置(没有就用 30 秒),并且关掉 SDK 的自动重试。多条并行探测,所以整体耗时接近最慢的那一条。
这里有个设计细节值得知道:这次探测故意不走 call_llm。因为 call_llm 自带恢复阶梯——它会重试,甚至会换一家给你答案——那正好会把你真正想验证的“这一条已经死了”这件事藏起来。体检要的是坏消息,不是被兜住的假好消息。
判定结果有这么几类:
ready:静态和实测都过了。auth:没有可用凭据,切换器也会跳过它。live_*:请求失败,后缀是错误分类(限流、超时、鉴权、模型不存在等)。live_response:对方返回了 200,但里面没有可用的回复——比如状态是 failed,或者只有半截文本。model_mismatch:对方回答了,但回答的不是你要的模型。
最后这条比听起来常见。很多聚合网关会在你请求的模型不可用时“帮你换一个”,日志里一切正常,实际质量已经变了。体检会把请求的模型和对方自报的模型对上:带日期的快照(gpt-4o → gpt-4o-2024-08-06)算匹配,-latest 指针算匹配,:tag 必须一致。至于那些自报模型本来就不可信的通道——本地端点、Azure 的部署名、openrouter/auto 这类路由元模型——命令不会拿它当证据,避免误报。
读 JSON,把体检接进流水线
人看表格,脚本看 JSON:
hermes fallback check --live --json > fallback-report.json结构大致是这样(字段按条目给出):
{
  "profile": "default",
  "live": true,
  "ready": false,
  "checked_at": "2026-11-17T03:12:44+00:00",
  "results": [
    {
      "provider": "openrouter",
      "model": "gpt-x",
      "base_url": "https://openrouter.ai/api/v1",
      "api_mode": "chat_completions",
      "auth_source": "env",
      "configured": true,
      "auth_ready": true,
      "inference_ready": true,
      "latency_ms": 210,
      "model_returned": "gpt-x-2026-09-01",
      "error_class": "",
      "error": "",
      "ready": true,
      "status": "ready"
    }
  ]
}
要注意的是,报错文本里的密钥是脱敏过的:已知的凭据值先按字面替换掉,再过一遍日志脱敏器。所以这份 JSON 可以直接贴进 issue 或者工单,不用担心顺手把 key 发出去。
接进自动化就很直接:
# 每天 8 点检查一遍,失败就告警
hermes fallback check --live || hermes send --to ops "fallback chain is not ready"
或者放进部署脚本的检查清单,链不通就不发布——总比上线后第一个限流才发现强。
几个需要知道的边界
auto 和 moa 只做静态检查。 auto 每次调用自己挑后端,还可能自己走一遍链;moa 是多个模型投票的预设,只有 agent 才能装配。对这两类发一次请求证明不了什么,所以它们永远停在 ready (static)。
--live 是要花钱的。 每条一次最小请求,token 极少但不是零。链很长、跑得很频繁时,考虑只在关键时段用 --live。
体检通过不等于永远通过。 它检查的是“此刻能不能用”:额度、限流窗口、模型上下架都会变。把它当成体检,不是当成保险。
没有配置备用链时,命令会直接告诉你 No fallback providers configured. Add one with: hermes fallback add,而不是打印一张空表。
如果你还没配过链,先看三层 fallback 的设计思路,再用 hermes fallback 命令参考 把链搭起来,最后跑一次 hermes fallback check --live。这套动作加起来不到五分钟,换来的是“半夜限流时它真的会切过去”这件事。
小结
备用链最容易坏的阶段不是配置的时候,而是配置完之后那段没人看的时间里。hermes fallback check 把这段盲区补上了:静态检查看配置和凭据,--live 看真实可用性,退出码让自动化能接住。建议把它和升级流程绑在一起——每次 hermes update 之后跑一次,比任何“应该没问题”的心理安慰都便宜。
完整发布说明见 v0.23.2 版本页。