Deine Backup-Modelle sind vielleicht alle tot — und nichts sagt es dir vor dem Ausfall
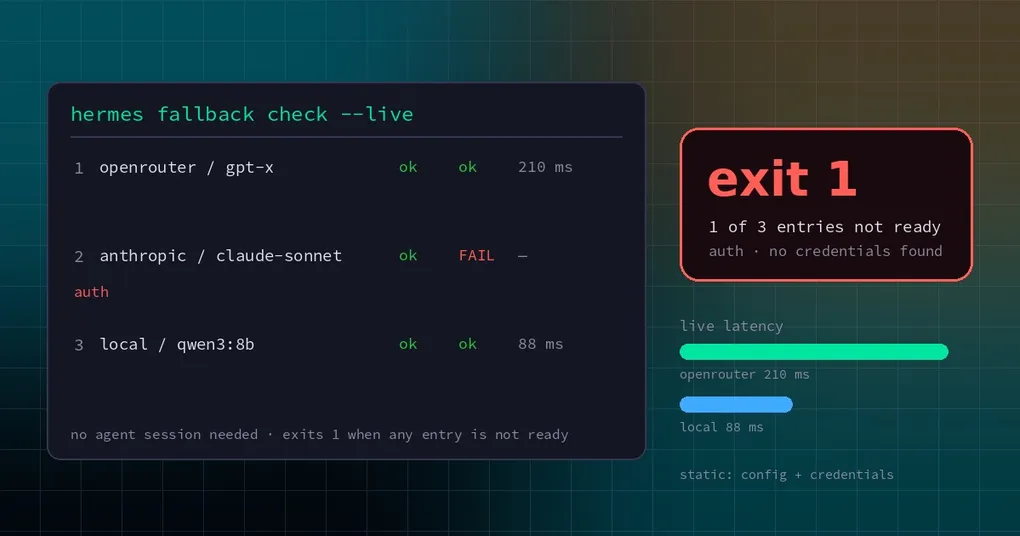
Es ist 2 Uhr nachts, und das Primärmodell fängt an, mit 429 zu antworten. Du machst dir keine Sorgen — die Fallback-Kette steht seit Monaten: erst ein anderer Provider, danach ein lokales Modell. Hermes probiert beide, beide scheitern, und die Aufgabe stirbt mittendrin. Am Morgen öffnest du die Config und siehst es: Der Key des ersten Providers wurde letzten Monat rotiert, und der zweite Provider hat sein Modell vor zwei Releases umbenannt. Die Kette war noch da. Geprüft hatte sie nur nie jemand.
Das ist keine Nachlässigkeit. Genau so verhält sich jedes Backup: Niemand fasst es an, also merkt auch niemand, wenn es verrottet — bis zu der einen Minute, in der du es brauchst.
Von „sollte funktionieren“ zu „funktioniert“
hermes fallback check ist ein neues Subkommando, das genau eine Frage beantwortet: Lässt sich jeder Eintrag deiner Kette gerade wirklich benutzen? Es startet keine Agent-Session und verbraucht keinen Gesprächskontext.
hermes fallback check          # nur Config und Credentials
hermes fallback check --live   # eine minimale Anfrage pro Eintrag
hermes fallback check --json   # strukturierte Ausgabe für Skripte
Ist auch nur ein Eintrag nicht bereit, endet der Befehl mit Status 1. Darum geht es im Kern: Du kannst ihn in cron hängen, in CI, in eine Checkliste vor dem Deploy — statt es um 2 Uhr nachts zu erfahren.
Fang damit an, dir anzusehen, was du überhaupt hast:
hermes fallback # identisch mit hermes fallback listDie Kette steht in config.yaml unter fallback_providers, einer geordneten Liste von {provider, model, base_url?, api_mode?}-Einträgen. Der ältere Key fallback_model wird automatisch hineingemischt, es gibt also nur eine Quelle der Wahrheit. hermes fallback add benutzt denselben Picker wie hermes model.
Der statische Check: was der Switch selbst sieht
Ohne --live löst der Befehl jeden Eintrag mit genau den kwargs auf, die auch der Fallback-Switch beim Failover verwendet. Dabei kommen drei Dinge heraus.
Existiert der Provider? Ein falsch geschriebener Provider ist ein Config-Fehler und kein Credential-Problem — der Report hält beides auseinander, weil auch die Reparatur unterschiedlich aussieht.
Gibt es brauchbare Credentials? Hier wird dieselbe Frage gestellt, die auch der Switch stellt: Würde er diesen Eintrag wegen fehlender Auth überspringen? Weil dasselbe Prädikat läuft, kann der Check nicht „bereit“ über einen Eintrag sagen, den das echte Failover überspringen würde.
Sehen der aufgelöste Endpoint und das Wire-Protokoll richtig aus? base_url und api_mode werden mit ausgegeben, ein Eintrag, der noch auf einen abgekündigten Endpoint zeigt, fällt dir also sofort ins Auge.
Die Ausgabe ist eine Tabelle:
  #  Provider / model                            Config  Auth    Live    Latency   Status
  1  openrouter / gpt-x                         ok      ok      ok      210 ms    ready
  2  anthropic / claude-sonnet                  ok      FAIL    —       —         auth
  3  local / qwen3:8b                           ok      ok      ok      88 ms     ready
Die drei Spalten sind unabhängig voneinander. Ein Fehlschlag bei Config heißt: Provider unbekannt. Ein Fehlschlag bei Auth heißt: Provider ist in Ordnung, aber es gibt keine Credentials dafür. Im statischen Modus steht in der Spalte Live ein Strich, weil keine Inferenz-Anfrage rausgegangen ist.
--live: wirklich etwas sagen
Ein statischer Check findet „nicht konfiguriert“. Er findet nicht „konfiguriert und kaputt“ — erschöpfte Quota, ein gesperrtes Konto, ein ausgemusterter Modellname, ein 502 hinter dem Endpoint. Das sagt dir nur eine echte Anfrage.
--live schickt eine minimale Completion an jeden Eintrag, der den statischen Check bestanden hat: den Prompt Reply with exactly: OK, höchstens 512 Token, das Request-Timeout des Providers selbst (30 Sekunden, wenn keins bekannt ist), mit abgeschalteten SDK-Retries. Die Einträge werden parallel geprüft, die Laufzeit entspricht also ungefähr der des langsamsten.
Eine Design-Entscheidung solltest du kennen: Die Probe geht bewusst nicht durch call_llm. call_llm hat eine Recovery-Leiter — es wiederholt und kann von einem anderen Provider antworten — und würde damit genau das verstecken, was du herausfinden willst. Ein Health-Check will die schlechte Nachricht, keine gerettete.
Die Urteile fallen in ein paar Klassen:
ready— beide Stufen bestanden.auth— keine brauchbaren Credentials; der Switch würde den Eintrag ebenfalls überspringen.live_*— die Anfrage ist gescheitert, mit dem Grund des Classifiers als Suffix (Rate-Limit, Timeout, Auth, Modell nicht gefunden und so weiter).live_response— HTTP 200, aber keine brauchbare Completion darin: ein Fehlerstatus oder Teiltext ohne Substanz.model_mismatch— irgendetwas hat geantwortet, aber nicht das Modell, das du angefragt hast.
Der letzte Fall ist häufiger, als er klingt. Viele Aggregator-Gateways tauschen still ein anderes Modell ein, wenn das angefragte nicht verfügbar ist; die Anfrage geht durch und die Qualität fällt unbemerkt. Der Check vergleicht, was du angefragt hast, mit dem, was der Provider als antwortend meldet: Ein datierter Snapshot (gpt-4o → gpt-4o-2024-08-06) gilt als Treffer, ein -latest-Pointer gilt, ein :tag muss passen. Und wo das gemeldete Modell gar kein Beweis ist — lokale Endpoints, Azures Benennung von Deployment vs. Basismodell, Router-Metamodelle wie openrouter/auto — tut er nicht so, als wüsste er es.
Das JSON lesen, eine Pipeline daran aufhängen
Menschen lesen die Tabelle, Skripte lesen das JSON:
hermes fallback check --live --json > fallback-report.jsonDie Struktur, pro Eintrag:
{
  "profile": "default",
  "live": true,
  "ready": false,
  "checked_at": "2026-11-17T03:12:44+00:00",
  "results": [
    {
      "provider": "openrouter",
      "model": "gpt-x",
      "base_url": "https://openrouter.ai/api/v1",
      "api_mode": "chat_completions",
      "auth_source": "env",
      "configured": true,
      "auth_ready": true,
      "inference_ready": true,
      "latency_ms": 210,
      "model_returned": "gpt-x-2026-09-01",
      "error_class": "",
      "error": "",
      "ready": true,
      "status": "ready"
    }
  ]
}
Fehlertexte werden redigiert: bekannte Credential-Werte werden zuerst wörtlich ersetzt, danach greift der Support-Redactor. Die Datei kannst du also in ein Ticket hängen, ohne versehentlich einen Key zu leaken.
Der Anschluss ist dann unspektakulär:
# jeden Morgen um 8: laut scheitern statt leise zu versagen
hermes fallback check --live || hermes send --to ops "fallback chain is not ready"
Oder du hängst ein Release daran auf. Eine Kette, die unten ist, sollte den Deploy stoppen und nicht als erster Incident danach auftauchen.
Kanten, die du kennen solltest
auto und moa bleiben statisch. auto wählt sein Backend pro Aufruf und kann die Kette selbst ablaufen; moa ist ein Fan-out-Preset, das nur ein Agent binden kann. Eine einzelne Anfrage aus einem Health-Check beweist für beide nichts, deshalb melden sie ready (static) und werden nie geprobt.
--live kostet Geld. Eine minimale Anfrage pro Eintrag — winzig, aber nicht null. Bei einer langen Kette, die sehr oft geprüft wird, solltest du die Live-Probe nur laufen lassen, wenn es darauf ankommt.
Bestanden heißt „jetzt gerade“. Quotas, Rate-Limit-Fenster und Modellverfügbarkeit bewegen sich. Behandle den Check wie eine Momentaufnahme und nicht wie eine Versicherung.
Ohne konfigurierte Kette bekommst du No fallback providers configured. Add one with: hermes fallback add statt einer leeren Tabelle.
Wenn du noch keine Kette gebaut hast, fang mit wie Hermes Fallbacks schichtet an, füge dann über die hermes fallback-Referenz Einträge hinzu und lass hermes fallback check --live laufen. Fünf Minuten Arbeit kaufen dir genau das eine, wofür ein Backup da ist.
Die Kurzfassung
Eine Fallback-Kette bricht selten dann, wenn du sie konfigurierst. Sie bricht in den Monaten, in denen niemand hinschaut. hermes fallback check schließt diese Lücke: statische Prüfung von Config und Credentials, --live für echte Verfügbarkeit, ein Exit-Code, auf den Automatisierung reagieren kann. Führ ihn nach jedem hermes update aus — billiger als jede Menge „passt schon“.
Vollständige Release-Notes: v0.23.2.