Seus modelos de fallback podem estar todos mortos — e nada avisa até a queda
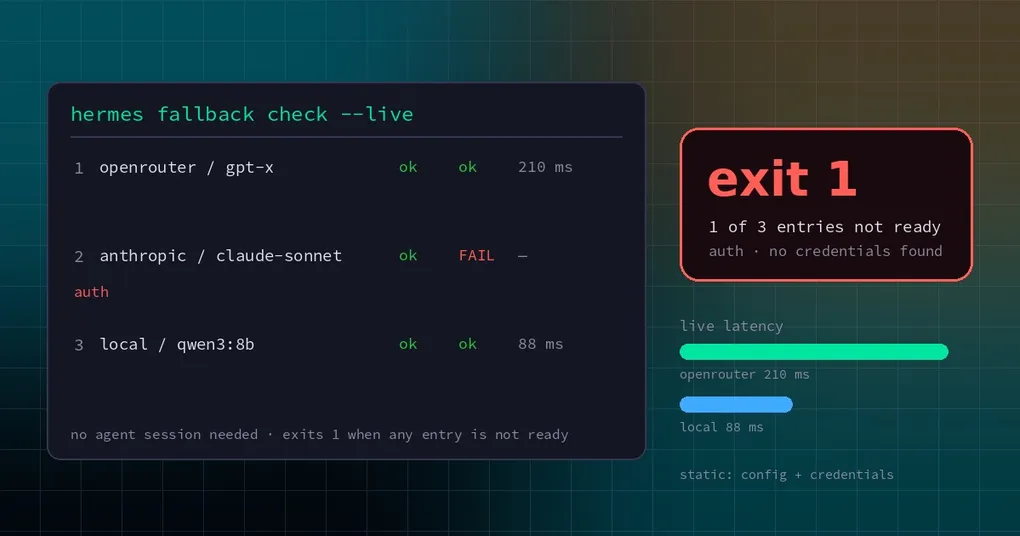
São duas da manhã e o modelo primário começa a responder 429. Você não se preocupa — montou uma cadeia de fallback meses atrás: outro provider primeiro, um modelo local depois. O Hermes tenta os dois, os dois falham, e a tarefa morre no meio. De manhã você abre a configuração e vê: a chave do primeiro provider foi rotacionada no mês passado, e o segundo provider renomeou o modelo duas releases atrás. A cadeia continuava lá. Só nunca tinha sido testada.
Isso não é descuido. É o que todo “backup” faz: nada o exercita, então nada percebe quando ele apodrece — até o minuto em que você precisa dele.
De “deveria funcionar” para “funciona”
hermes fallback check é um novo subcomando que responde a uma única pergunta: cada entrada da sua cadeia pode realmente ser usada agora? Ele não abre sessão de agente e não consome contexto da conversa.
hermes fallback check          # apenas configuração e credenciais
hermes fallback check --live   # envia uma requisição mínima por entrada
hermes fallback check --json   # saída estruturada para scripts
Se qualquer entrada não estiver pronta, o comando sai com status 1. É exatamente esse o ponto: você consegue pendurá-lo no cron, no CI, numa checklist antes do deploy — em vez de descobrir às duas da manhã.
Comece olhando o que você tem:
hermes fallback # o mesmo que hermes fallback listA cadeia fica em config.yaml, na chave fallback_providers, uma lista ordenada de entradas {provider, model, base_url?, api_mode?}. A chave antiga fallback_model é mesclada automaticamente, então existe uma única fonte de verdade. hermes fallback add usa o mesmo seletor de hermes model.
A checagem estática: o que o próprio switch vai enxergar
Sem --live, o comando resolve cada entrada com os mesmos kwargs que o switch de fallback usa quando faz o failover. Três coisas saem disso.
O provider existe? Um provider escrito errado é erro de configuração, não problema de credencial — o relatório separa os dois, porque o conserto é diferente.
Existem credenciais utilizáveis? Aqui a pergunta é a mesma que o switch faz: essa entrada seria pulada por falta de autenticação? Usar o mesmo predicado significa que a checagem não consegue dizer “pronta” sobre uma entrada que o failover real pularia.
O endpoint e o protocolo resolvidos fazem sentido? base_url e api_mode são impressos, então uma entrada que ainda aponta para um endpoint do qual você migrou aparece na hora.
A saída é uma tabela:
  #  Provider / model                            Config  Auth    Live    Latency   Status
  1  openrouter / gpt-x                         ok      ok      ok      210 ms    ready
  2  anthropic / claude-sonnet                  ok      FAIL    —       —         auth
  3  local / qwen3:8b                           ok      ok      ok      88 ms     ready
As três colunas são independentes. Config falhando significa provider desconhecido. Auth falhando significa que o provider está certo, mas não há credencial para ele. No modo estático a coluna Live vem como travessão, porque nenhuma requisição de inferência foi enviada.
--live: dizer algo de verdade
Uma checagem estática pega o “não configurado”. Ela não pega o “configurado e quebrado” — cota esgotada, conta suspensa, nome de modelo aposentado, um 502 atrás do endpoint. Só uma requisição real revela isso.
--live envia uma completion mínima para cada entrada que passou na checagem estática: o prompt Reply with exactly: OK, no máximo 512 tokens, o timeout de requisição do próprio provider (30 segundos se nenhum for conhecido) e retries do SDK desligados. As entradas são sondadas em paralelo, então o custo em tempo de parede é mais ou menos o da mais lenta.
Uma decisão de projeto vale a pena conhecer: a sonda não passa de propósito pelo call_llm. O call_llm tem uma escada de recuperação — ele tenta de novo e pode responder a partir de outro provider — e isso esconderia justamente o que você quer descobrir. Uma checagem de saúde quer a má notícia, não a notícia salva.
Os veredictos caem em poucas classes:
ready— as duas etapas passaram.auth— nenhuma credencial utilizável; o switch também pularia essa entrada.live_*— a requisição falhou, com o motivo do classificador como sufixo (rate limit, timeout, auth, model not found, e assim por diante).live_response— HTTP 200 sem completion utilizável dentro: um status de falha, ou texto parcial sem nada atrás.model_mismatch— algo respondeu, mas não foi o modelo que você pediu.
Esse último é mais comum do que parece. Muitos gateways agregadores substituem silenciosamente o modelo quando o solicitado está indisponível; a requisição tem sucesso e a qualidade cai sem aviso. A checagem compara o que você pediu com o que o provider diz ter respondido: um snapshot datado (gpt-4o → gpt-4o-2024-08-06) conta como compatível, um ponteiro -latest conta, uma :tag precisa bater. E onde o modelo informado não é evidência nenhuma — endpoints locais, a nomenclatura deployment-versus-base-model do Azure, meta-modelos de roteador como openrouter/auto — ele não finge saber.
Lendo o JSON, travando um pipeline
Humanos leem a tabela; scripts leem o JSON:
hermes fallback check --live --json > fallback-report.jsonO formato, por entrada:
{
  "profile": "default",
  "live": true,
  "ready": false,
  "checked_at": "2026-11-17T03:12:44+00:00",
  "results": [
    {
      "provider": "openrouter",
      "model": "gpt-x",
      "base_url": "https://openrouter.ai/api/v1",
      "api_mode": "chat_completions",
      "auth_source": "env",
      "configured": true,
      "auth_ready": true,
      "inference_ready": true,
      "latency_ms": 210,
      "model_returned": "gpt-x-2026-09-01",
      "error_class": "",
      "error": "",
      "ready": true,
      "status": "ready"
    }
  ]
}
O texto de erro passa por redação: valores de credencial conhecidos são substituídos literalmente primeiro, e depois o redator de suporte roda. Então o arquivo pode ser colado num ticket sem vazar uma chave por acidente.
Pendurar isso é trivial:
# toda manhã às 8: falhe alto em vez de falhar em silêncio
hermes fallback check --live || hermes send --to ops "a cadeia de fallback não está pronta"
Ou use como portão de release. Uma cadeia fora do ar deve parar o deploy, não aparecer como o primeiro incidente depois dele.
Detalhes que valem conhecer
auto e moa ficam estáticos. O auto escolhe o backend a cada chamada e pode percorrer a cadeia sozinho; o moa é um preset de fan-out que só um agente consegue amarrar. Uma requisição de checagem de saúde não prova nada sobre nenhum dos dois, então eles reportam ready (static) e nunca são sondados.
--live custa dinheiro. Uma requisição mínima por entrada — pouca coisa, mas não zero. Numa cadeia longa checada com muita frequência, considere rodar a sonda ao vivo só quando importa.
Passar significa “agora”. Cotas, janelas de rate limit e disponibilidade de modelos mudam. Trate a checagem como um exame físico, não como um seguro.
Sem cadeia configurada, você recebe No fallback providers configured. Add one with: hermes fallback add em vez de uma tabela vazia.
Se você ainda não montou uma cadeia, comece por como o Hermes organiza fallbacks em camadas, use a referência de hermes fallback para adicionar entradas e depois rode hermes fallback check --live. Cinco minutos de trabalho compram a única coisa para a qual um backup serve.
A versão curta
Uma cadeia de fallback normalmente não quebra quando você a configura. Ela quebra nos meses em que ninguém olha para ela. hermes fallback check fecha essa lacuna: checagens estáticas de configuração e credenciais, --live para disponibilidade real, e um código de saída sobre o qual a automação consegue agir. Rode depois de cada hermes update — mais barato do que qualquer quantidade de “deve estar tudo bem”.
Notas completas da release: v0.23.2.