Vos modèles de secours sont peut-être tous morts — et rien ne vous le dit avant la panne
Il est 2 h du matin et le modèle principal commence à répondre 429. Vous ne vous inquiétez pas — vous avez monté une chaîne de fallback il y a des mois : un autre provider d’abord, un modèle local ensuite. Hermes essaie les deux, les deux échouent, et la tâche meurt en cours de route. Au matin, vous ouvrez la config et vous voyez : la clé du premier provider a été tournée le mois dernier, et le second provider a renommé son modèle deux releases plus tôt. La chaîne était toujours là. Elle n’avait simplement jamais été contrôlée.
Ce n’est pas de la négligence. C’est ce que fait toujours un « backup » : rien ne l’exerce, donc rien ne remarque qu’il pourrit, jusqu’à la minute où vous en avez besoin.
Du « ça devrait marcher » au « ça marche »
hermes fallback check est une nouvelle sous-commande qui répond à une seule question : chaque entrée de votre chaîne est-elle réellement utilisable maintenant ? Elle ne démarre pas de session d’agent et ne consomme pas de contexte de conversation.
hermes fallback check          # config et identifiants uniquement
hermes fallback check --live   # envoie une requête minimale par entrée
hermes fallback check --json   # sortie structurée pour les scripts
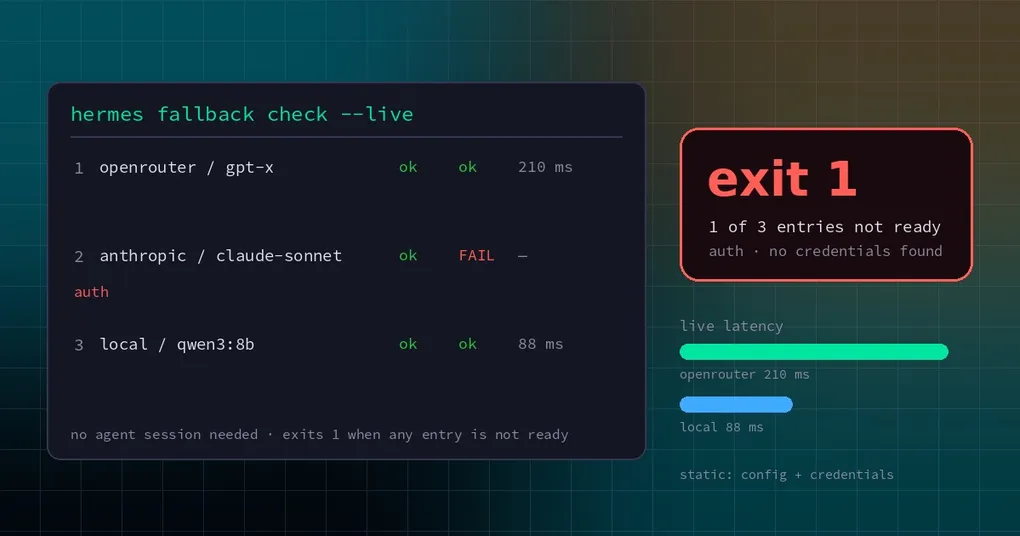
Si une entrée n’est pas prête, la commande sort avec le statut 1. C’est tout l’intérêt : vous pouvez la brancher dans un cron, dans une CI, dans une checklist de pré-déploiement — au lieu de le découvrir à 2 h du matin.
Commencez par regarder ce que vous avez :
hermes fallback # identique à hermes fallback listLa chaîne vit dans config.yaml, sous fallback_providers, une liste ordonnée d’entrées {provider, model, base_url?, api_mode?}. L’ancienne clé fallback_model est fusionnée automatiquement, il n’y a donc qu’une seule source de vérité. hermes fallback add utilise le même sélecteur que hermes model.
Le contrôle statique : ce que le switch lui-même verra
Sans --live, la commande résout chaque entrée avec exactement les mêmes kwargs que le switch de fallback emploie lors d’un basculement. Trois choses en ressortent.
Le provider existe-t-il ? Un provider mal orthographié est une erreur de config, pas un problème d’identifiants — le rapport garde les deux séparés, parce que le correctif n’est pas le même.
Y a-t-il des identifiants utilisables ? La question posée est celle du switch : sauterait-il cette entrée faute d’auth ? Utiliser le même prédicat garantit que le contrôle ne peut pas déclarer ready une entrée que le vrai basculement sauterait.
L’endpoint et le protocole résolus sont-ils cohérents ? base_url et api_mode sont affichés, donc une entrée qui pointe encore vers un endpoint que vous avez quitté se repère d’un coup d’œil.
La sortie est un tableau :
  #  Provider / model                            Config  Auth    Live    Latency   Status
  1  openrouter / gpt-x                         ok      ok      ok      210 ms    ready
  2  anthropic / claude-sonnet                  ok      FAIL    —       —         auth
  3  local / qwen3:8b                           ok      ok      ok      88 ms     ready
Les trois colonnes sont indépendantes. Un échec de Config signifie que le provider est inconnu. Un échec de Auth signifie que le provider est bon mais qu’aucun identifiant n’existe pour lui. En mode statique, la colonne Live affiche un tiret, parce qu’aucune requête d’inférence n’a été envoyée.
--live : dire réellement quelque chose
Un contrôle statique attrape « pas configuré ». Il n’attrape pas « configuré et cassé » — quota épuisé, compte suspendu, nom de modèle retiré, un 502 derrière l’endpoint. Seule une vraie requête vous le dit.
--live envoie un completion minimal à chaque entrée qui a passé le contrôle statique : le prompt Reply with exactly: OK, 512 tokens au maximum, le timeout de requête propre au provider (30 secondes si aucun n’est connu), les retries au niveau SDK désactivés. Les entrées sont sondées en parallèle, donc le coût en temps réel est à peu près celui de la plus lente.
Une décision de conception mérite d’être connue : la sonde ne passe délibérément pas par call_llm. call_llm embarque une échelle de récupération — il retente, et il peut répondre depuis un autre provider — ce qui masquerait exactement ce que vous cherchez à savoir. Un health check veut la mauvaise nouvelle, pas une nouvelle sauvée.
Les verdicts tombent dans quelques classes :
ready— les deux étapes sont passées.auth— aucun identifiant utilisable ; le switch la sauterait aussi.live_*— la requête a échoué, avec la raison du classificateur en suffixe (rate limit, timeout, auth, modèle introuvable, etc.).live_response— HTTP 200 sans completion utilisable dedans : un statut d’échec, ou du texte partiel sans rien derrière.model_mismatch— quelque chose a répondu, mais pas le modèle demandé.
Cette dernière est plus fréquente qu’elle n’en a l’air. Beaucoup de gateway d’agrégation substituent discrètement un autre modèle quand celui demandé n’est pas disponible ; la requête réussit et la qualité chute en silence. Le contrôle compare ce que vous avez demandé avec ce que le provider affirme avoir répondu : un snapshot daté (gpt-4o → gpt-4o-2024-08-06) compte comme une correspondance, un pointeur -latest compte, un :tag doit correspondre. Et là où le modèle rapporté ne prouve rien — endpoints locaux, nommage déploiement-contre-modèle-de-base chez Azure, méta-modèles de routeur comme openrouter/auto — il ne prétend pas savoir.
Lire le JSON, verrouiller un pipeline
Les humains lisent le tableau ; les scripts lisent le JSON :
hermes fallback check --live --json > fallback-report.jsonLa forme, par entrée :
{
  "profile": "default",
  "live": true,
  "ready": false,
  "checked_at": "2026-11-17T03:12:44+00:00",
  "results": [
    {
      "provider": "openrouter",
      "model": "gpt-x",
      "base_url": "https://openrouter.ai/api/v1",
      "api_mode": "chat_completions",
      "auth_source": "env",
      "configured": true,
      "auth_ready": true,
      "inference_ready": true,
      "latency_ms": 210,
      "model_returned": "gpt-x-2026-09-01",
      "error_class": "",
      "error": "",
      "ready": true,
      "status": "ready"
    }
  ]
}
Les textes d’erreur sont expurgés : les valeurs d’identifiants connues sont d’abord remplacées littéralement, puis le redacteur du support entre en jeu. Le fichier peut donc être collé dans un ticket sans faire fuiter une clé par accident.
Le brancher devient alors trivial :
# chaque matin à 8 h : tomber bruyamment au lieu d'échouer en silence
hermes fallback check --live || hermes send --to ops "fallback chain is not ready"
Ou conditionnez une release dessus. Une chaîne à terre devrait arrêter le déploiement, pas ressurgir comme premier incident le lendemain.
Des cas limites à connaître
auto et moa restent statiques. auto choisit son backend à chaque appel et peut parcourir la chaîne lui-même ; moa est un preset en éventail qu’un agent seul peut lier. Une requête de health check ne prouve rien ni pour l’un ni pour l’autre : ils rapportent ready (static) et ne sont jamais sondés.
--live coûte de l’argent. Une requête minimale par entrée — minuscule, mais pas nulle. Sur une longue chaîne contrôlée très souvent, envisagez de ne lancer la sonde live que lorsque cela compte.
Passer signifie « maintenant ». Les quotas, les fenêtres de rate limit et la disponibilité des modèles bougent. Traitez ce contrôle comme un état physique, pas comme une assurance.
Sans chaîne configurée, vous obtenez No fallback providers configured. Add one with: hermes fallback add plutôt qu’un tableau vide.
Si vous n’avez pas encore de chaîne, commencez par comment Hermes empile les fallbacks, puis utilisez la référence hermes fallback pour ajouter des entrées, et lancez hermes fallback check --live. Cinq minutes de travail vous achètent la seule chose pour laquelle un backup existe.
La version courte
Une chaîne de fallback ne casse généralement pas au moment où vous la configurez. Elle casse pendant les mois où personne ne la regarde. hermes fallback check ferme ce trou : contrôle statique pour la config et les identifiants, --live pour la disponibilité réelle, un code de sortie sur lequel une automatisation peut agir. Lancez-le après chaque hermes update — moins cher que n’importe quelle quantité de « ça devrait aller ».
Notes de version complètes : v0.23.2.