Tus modelos de respaldo pueden estar todos muertos y nada te avisa hasta que hay una caída
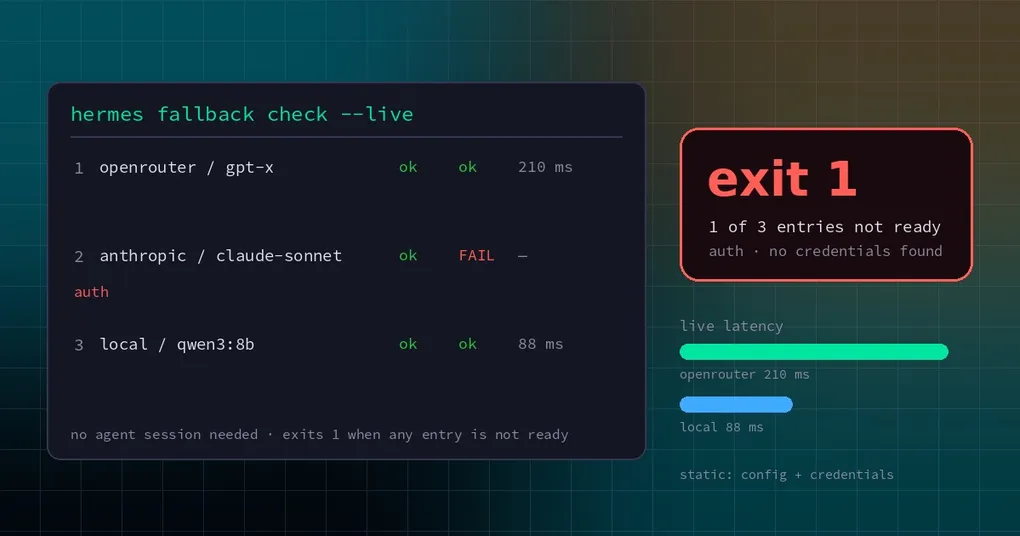
Son las dos de la mañana y el modelo principal empieza a responder con 429. No te preocupa: hace meses montaste una cadena de fallback, primero otro proveedor y después un modelo local. Hermes prueba los dos, los dos fallan y la tarea muere a mitad de camino. Por la mañana abres la config y lo ves: la clave del primer proveedor se rotó el mes pasado y el segundo renombró su modelo dos releases atrás. La cadena seguía ahí. Simplemente nadie la había comprobado nunca.
No es descuido. Es lo que hace siempre un plan B: nadie lo ejercita, así que nadie se da cuenta de que se ha podrido, hasta el minuto exacto en que lo necesitas.
De «debería funcionar» a «funciona»
hermes fallback check es un subcomando nuevo que responde a una sola pregunta: ¿cada entrada de tu cadena se puede usar realmente ahora mismo? No abre una sesión de agente ni consume contexto de conversación.
hermes fallback check          # solo configuración y credenciales
hermes fallback check --live   # envía una petición mínima por entrada
hermes fallback check --json   # salida estructurada para scripts
Si alguna entrada no está lista, el comando sale con estado 1. Ahí está toda la gracia: puedes engancharlo a cron, a CI, a un checklist previo al despliegue, en vez de enterarte a las dos de la mañana.
Empieza por ver qué tienes:
hermes fallback # igual que hermes fallback listLa cadena vive en config.yaml, bajo fallback_providers: una lista ordenada de entradas {provider, model, base_url?, api_mode?}. La clave antigua fallback_model se fusiona automáticamente, así que hay una sola fuente de verdad. hermes fallback add usa el mismo selector que hermes model.
La comprobación estática: lo que verá el propio switch
Sin --live, el comando resuelve cada entrada con los mismos kwargs que usa el switch de fallback cuando hace failover. De ahí salen tres cosas.
¿Existe el proveedor? Un proveedor mal escrito es un error de configuración, no un problema de credenciales. El informe los mantiene separados porque el arreglo es distinto.
¿Hay credenciales utilizables? Plantea la misma pregunta que se hace el switch: ¿saltaría esta entrada por falta de auth? Al usar el mismo predicado, la comprobación no puede declarar «lista» una entrada que el failover real saltaría.
¿Tienen buena pinta el endpoint y el protocolo de wire resueltos? Se imprimen base_url y api_mode, así que una entrada que sigue apuntando a un endpoint del que ya te mudaste se ve de un vistazo.
La salida es una tabla:
  #  Provider / model                            Config  Auth    Live    Latency   Status
  1  openrouter / gpt-x                         ok      ok      ok      210 ms    ready
  2  anthropic / claude-sonnet                  ok      FAIL    —       —         auth
  3  local / qwen3:8b                           ok      ok      ok      88 ms     ready
Las tres columnas son independientes. Que falle Config significa que el proveedor es desconocido. Que falle Auth significa que el proveedor está bien pero no hay credencial para él. En modo estático la columna Live aparece con un guion, porque no se envió ninguna petición de inferencia.
--live: decir algo de verdad
Una comprobación estática pilla lo «no configurado». No puede pillar lo «configurado y roto»: cuota agotada, cuenta suspendida, un nombre de modelo retirado, un 502 detrás del endpoint. Solo una petición real te lo dice.
--live envía una completion mínima a cada entrada que pasó la comprobación estática: el prompt Reply with exactly: OK, como máximo 512 tokens, con el timeout propio del proveedor (30 segundos si no se conoce ninguno) y los reintentos a nivel de SDK desactivados. Las entradas se prueban en paralelo, así que el coste en tiempo real es más o menos el de la más lenta.
Hay una decisión de diseño que conviene conocer: la prueba no pasa por call_llm a propósito. call_llm tiene una escalera de recuperación (reintenta y puede responder desde otro proveedor) que escondería justo lo que intentas averiguar. Un health check quiere las malas noticias, no una buena noticia rescatada.
Los veredictos caen en unas pocas clases:
ready: pasaron las dos etapas.auth: no hay credencial utilizable; el switch también la saltaría.live_*: la petición falló, con el motivo del clasificador como sufijo (rate limit, timeout, auth, modelo no encontrado, etc.).live_response: HTTP 200 sin ninguna completion utilizable dentro, ya sea por un estado fallido o por texto parcial sin nada detrás.model_mismatch: algo respondió, pero no el modelo que pediste.
El último es más habitual de lo que parece. Muchos gateways agregadores sustituyen en silencio el modelo por otro cuando el solicitado no está disponible; la petición sale bien y la calidad se hunde sin hacer ruido. La comprobación compara lo que pediste con lo que el proveedor dice haber respondido: un snapshot con fecha (gpt-4o → gpt-4o-2024-08-06) cuenta como coincidencia, un puntero -latest también, y un :tag tiene que coincidir exactamente. Y cuando el modelo reportado no prueba nada (endpoints locales, el naming de deployment frente a base model en Azure, meta-modelos de router como openrouter/auto), no finge saberlo.
Leer el JSON y poner una condición en el pipeline
Los humanos leen la tabla; los scripts leen el JSON:
hermes fallback check --live --json > fallback-report.jsonLa forma, por entrada:
{
  "profile": "default",
  "live": true,
  "ready": false,
  "checked_at": "2026-11-17T03:12:44+00:00",
  "results": [
    {
      "provider": "openrouter",
      "model": "gpt-x",
      "base_url": "https://openrouter.ai/api/v1",
      "api_mode": "chat_completions",
      "auth_source": "env",
      "configured": true,
      "auth_ready": true,
      "inference_ready": true,
      "latency_ms": 210,
      "model_returned": "gpt-x-2026-09-01",
      "error_class": "",
      "error": "",
      "ready": true,
      "status": "ready"
    }
  ]
}
El texto de error va censurado: primero se sustituyen literalmente los valores de credencial conocidos y luego se ejecuta el redactor de soporte. El archivo se puede pegar en un ticket sin filtrar una clave por accidente.
Conectarlo es trivial:
# cada mañana a las 8: falla en voz alta en lugar de fallar en silencio
hermes fallback check --live || hermes send --to ops "fallback chain is not ready"
O ponlo como condición de un release. Una cadena caída debería parar el despliegue, no aparecer como el primer incidente después.
Detalles que conviene conocer
auto y moa se quedan en estático. auto elige su backend en cada llamada y puede recorrer la cadena él mismo; moa es un preset de fan-out que solo puede enlazar un agente. Una petición de un health check no demuestra nada de ninguno de los dos, así que informan ready (static) y nunca se prueban.
--live cuesta dinero. Una petición mínima por entrada: es poco, pero no cero. En una cadena larga que compruebas muy a menudo, plantéate lanzar la prueba live solo cuando importe.
Pasar significa «ahora mismo». Las cuotas, las ventanas de rate limit y la disponibilidad de modelos se mueven. Trata la comprobación como un reconocimiento médico, no como un seguro.
Sin ninguna cadena configurada recibes No fallback providers configured. Add one with: hermes fallback add en lugar de una tabla vacía.
Si aún no tienes una cadena montada, empieza por cómo escalona Hermes los fallbacks, luego usa la referencia de hermes fallback para añadir entradas y después ejecuta hermes fallback check --live. Cinco minutos de trabajo te compran exactamente aquello para lo que sirve un plan B.
En resumen
Una cadena de fallback no suele romperse cuando la configuras. Se rompe en los meses en los que nadie la mira. hermes fallback check tapa ese hueco: comprobación estática de configuración y credenciales, --live para disponibilidad real y un código de salida sobre el que la automatización puede actuar. Lánzalo después de cada hermes update; sale más barato que cualquier cantidad de «debería ir bien».
Notas completas del release: v0.23.2.