定时任务提前一小时跑了:Hermes 刚修掉的夏令时坑
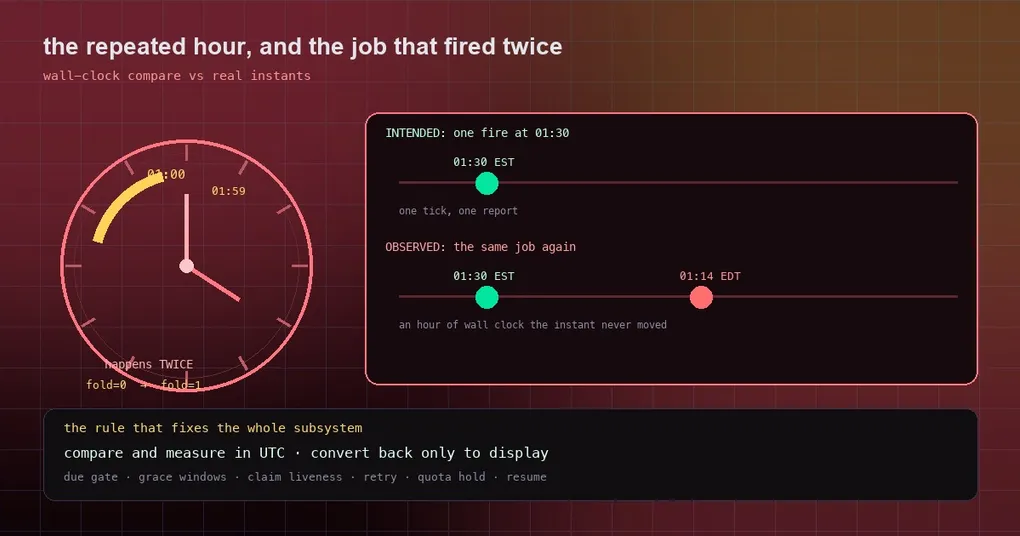
时钟回拨那一晚,你那班 01:30 的夜间报表跑了两遍;或者本该 09:00 发的晨间简报,08:00 就到了。你没改过任何东西,服务器也没重启,日志里调度器做的正是它被要求做的事。你的配置一点没错。错的是算术:Python 在同一个时区内对带时区的 datetime 做加减比较时,用的是墙上时间;而重复的那一个小时,恰恰是墙上时间和真实时间不再一致的地方。
Hermes 把它修了(#120314,salvage 自 #119710)。只要你有配了时区的任务,这件事值得花十分钟看一下。
重复的那一小时是 fold 的陷阱
Hermes 按计划跑的每个任务都带着一个时间瞬时。时区来自该 profile 配置的 ZoneInfo——hermes_time.get_timezone() 返回它,服务器本地时区则返回 None。hermes cron create 本身没有时区参数,真正起作用的是 profile 里的这个设置。
现在考虑一个使用夏令时的时区。在回拨的那一刻,本地时间 01:00 到 02:00 会出现两次:一次用旧偏移(EDT),一次用新偏移(EST)。Python 靠一个 fold 标记把两者区分开——第一遍是 fold=0,第二遍是 fold=1。
坑就在这里:当你比较或相减的两个带时区 datetime 共享同一个 tzinfo 对象时,Python 按墙上时间比较,完全忽略 fold。于是 01:11 EST(也就是 06:11 UTC)会被当成 01:14 EDT(05:14 UTC)该触发了。同一个盲区还在 aware + timedelta 里——那也是墙上时间运算,出来的时候 fold 已经丢了。
源码里有一行注释比一整段解释说得更清楚:
def _seconds_after(dt, seconds):
    """*dt* plus real *seconds*, in *dt*'s zone. Aware ``+ timedelta`` is wall-clock arithmetic
    that drops ``fold``, so inside a fall-back hour it lands an hour off."""
return (dt.astimezone(timezone.utc) + timedelta(seconds=seconds)).astimezone(dt.tzinfo)整个子系统的修复就是这一个思路,然后铺到所有地方:比较和计时都在 UTC 里做,只在展示时换回调用方的时区。
到底改了什么
到期扫描逻辑围绕 UTC 瞬时和真实流逝秒数重写了。清单长到足以说明墙上时间运算渗透得有多深:
- 到期判断本身、快进宽限窗口、一次性任务的宽限窗口,
- 派发迟到判定,
- 抢占活跃度——另一个 worker 对任务的抢占是否还在有效期内,
- 过期错误重新武装、时区修复前置闸门、一次性任务恢复,
- 外部提供商兜底的漏触发补跑(把逾期任务补发出去的那条路径)。
同一类 bug 还在另外四处冒头,现在都改成按瞬时比较:
unreachable_retry.plan_retry。 一个失败后要求 300 秒后重试的任务,在01:30 EST算出现在 + 300 秒,落在01:35 EDT——也就是过去 55 分钟。于是重试在下一个 tick 就跑了,根本没等那五分钟。quota_hold。 提供商用量窗口的结束时间可能差一小时,而hold_active用的是墙上时间比较。resume_job。 “暂停期间这一班已经过去”的判断用的是墙上时间。_repeat_alert_withheld。 重复提醒窗口按墙上时间计算的。
有一处是检查过后刻意不动的:claim_job_for_fire 里的偏差判定本来就是按瞬时工作的,因为它比较的那个计划时间存的是 UTC 字符串,两个值的 tzinfo 不同,Python 于是“歪打正着”地做了实时比较。这类 bug 最爱藏身的就是这种细节。
两个相邻的坑,Hermes 已经处理了
如果你在看自己写的调度器,有两个邻近问题值得知道,因为 Hermes 也踩过:
没有时区的历史时间戳。 早期数据行存的时间完全没有时区信息。Hermes 会把它们读作系统本地的墙上时间——也就是当初写入它们的那个时间——再换算,而不是假设它们本来就是 UTC。这么做是为了避免因为机器时区和 profile 时区不同,就把一个还没到点的任务判成“不该跑”。
时区变更后残留的旧偏移。 如果你把 profile 从一个时区搬到另一个,某个存下来的时间戳可能带着旧偏移,让一个未来的任务看起来早就逾期了——源码注释给的例子是 21:00+10 变成 13:00+02。Hermes 会拿裸墙上时间比一比,把“你的钟还没走到这里”和“这次真的没跑”分开。
还有第三种情况,也正是“陈旧的 next_run_at 要分类处理而不是一丢了之”的原因:合法的时区迁移和手工改过 cron 表达式需要完全相反的处理。把一条历史 UTC 记录归一化到 profile 时区,只改变了表示方式、没有改变意图;如果当成有人改了表达式去重新锚定,就会把一次本该到期、而且从未跑过的执行静默跳过。所以 Hermes 会检查存下来的墙上时间是否仍是当前表达式的合法触发点:是,就来自迁移;不是,就来自手工编辑。
对你意味着什么
- 只有配了时区的任务受影响。 服务器本地时区的安装从来没算错过。
- 窗口很窄、也很罕见——大约一小时,一年两次,只发生在使用夏令时的时区。如果你从没察觉,多半是你没有任务落在那一小时里。
- 症状不一定只是“提前”。 取决于比较落在切换的哪一侧,也可能晚一小时。
- 不需要任何配置。 没有开关要拨,没有配置项要改;代码更新了,任务就跟着修好了。
- 如果今天没法升级,实用的规避办法是把关键任务挪出那一小时——在两个夏令时切换日,把 01:30 的任务临时改成 03:30。
想看自己的任务认为下一次什么时候跑,hermes cron list 会列出计划任务,hermes cron status 告诉你调度器到底有没有在跑——很多“任务提前跑了”的报告,最后发现是起了第二个调度器进程。hermes cron runs 显示每个任务的持久化执行记录,hermes cron incidents 列出记录在案的失败事件,hermes cron doctor 检查任务的常见健康问题,是任何触发异常之后最快的排查起点。
这个修复在 v0.21.4 打标签之后进的 main,所以会在你下次拉取 main 或下一个正式版本时到来。想看更全的画面,cron doctor 指南详细过了一遍健康检查,cron 自动化完全指南从最基础的排期和投递方式讲起。