Votre cron job s'est déclenché une heure trop tôt : le bug DST que Hermes vient de corriger
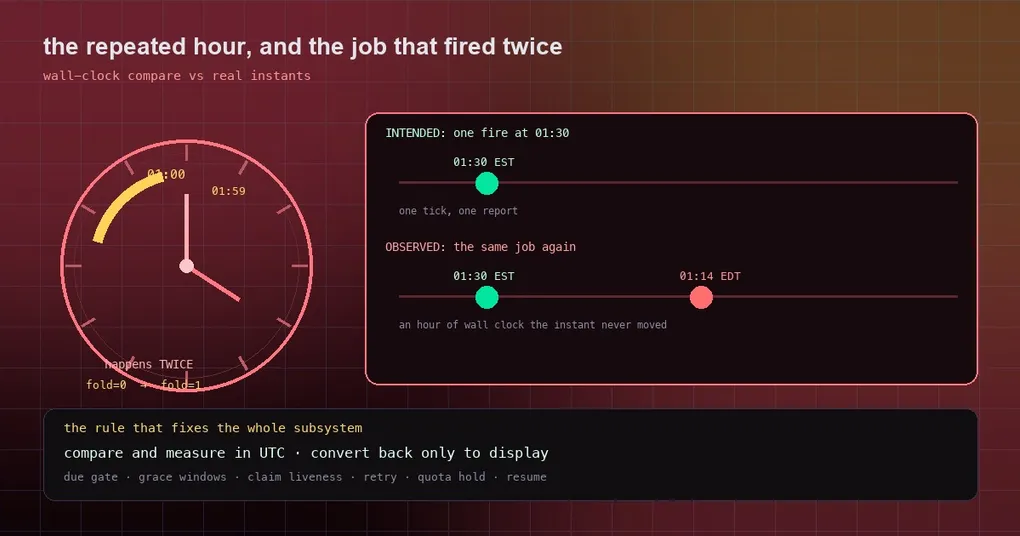
C’est la nuit où l’on recule les horloges, et votre rapport quotidien de 01:30 tourne deux fois — ou votre briefing de 09:00 arrive à 08:00. Vous n’avez rien changé, le serveur n’a jamais redémarré, et les logs montrent le scheduler faisant exactement ce qu’on lui avait dit. Rien dans votre config n’est faux. Le bug était de l’arithmétique : Python additionne et soustrait à l’heure murale des datetimes aware appartenant à un même fuseau, et l’heure répétée est précisément l’endroit où l’heure murale et le temps réel cessent d’être d’accord. Hermes a corrigé le tir (#120314, qui sauve #119710). Si vous faites tourner un job avec un fuseau configuré, cela vaut dix minutes de votre attention.
L’heure répétée est un piège pour fold
Chaque job que Hermes exécute depuis un planning porte un instant. Le fuseau vient du ZoneInfo configuré dans le profile — hermes_time.get_timezone() le renvoie, ou None pour une installation sur le fuseau local du serveur. hermes cron create n’a pas de flag de fuseau à lui ; c’est le réglage du profile qui compte.
Considérez maintenant un fuseau qui observe l’heure d’été. À la transition d’automne, 01:00–02:00 locales se produisent deux fois : une fois à l’ancien offset (EDT) et une fois au nouveau (EST). Python conserve les deux en attachant un flag fold — fold=0 pour le premier passage, fold=1 pour le second.
Le piège : quand vous comparez ou soustrayez deux datetimes aware qui partagent le même objet tzinfo, Python les compare à l’heure murale et ignore complètement fold. Ainsi 01:11 EST, qui vaut 06:11 UTC, était traité comme dû à 01:14 EDT, qui vaut 05:14 UTC. Le même angle mort se niche dans aware + timedelta, qui est lui aussi de l’arithmétique en heure murale et laisse tomber fold en sortie.
Une ligne du source le dit mieux qu’un paragraphe :
def _seconds_after(dt, seconds):
    """*dt* plus real *seconds*, in *dt*'s zone. Aware ``+ timedelta`` is wall-clock arithmetic
    that drops ``fold``, so inside a fall-back hour it lands an hour off."""
    return (dt.astimezone(timezone.utc) + timedelta(seconds=seconds)).astimezone(dt.tzinfo)
Le correctif pour tout le sous-système tient dans cette seule idée, appliquée partout : comparer et mesurer en UTC, reconvertir dans le fuseau de l’appelant uniquement pour l’affichage.
Ce qui a réellement changé
Le scan des échéances a été réécrit autour d’instants UTC et de secondes réellement écoulées. La liste est assez longue pour montrer à quel point l’arithmétique en heure murale s’était répandue :
- le gate d’échéance lui-même, la fenêtre de grâce du fast-forward et celle du one-shot,
- le retard de dispatch,
- la liveness d’un claim — savoir si le claim d’un autre worker sur un job est encore frais,
- le re-arm des erreurs obsolètes, le pre-gate de réparation de fuseau et la récupération des one-shots,
- le filet de sécurité de misfire du provider externe, qui déclenche les jobs en retard.
La même classe de bug est apparue à quatre autres endroits, et les quatre sont désormais basés sur des instants :
unreachable_retry.plan_retry. Un job qui avait échoué et demandé un retry dans 300 secondes calculaitnow + 300 sà01:30 ESTet atterrissait sur01:35 EDT— 55 minutes dans le passé. Le retry partait alors au tick suivant au lieu d’attendre cinq minutes.quota_hold. La fin de la fenêtre d’usage d’un provider pouvait être décalée d’une heure, ethold_activecomparait des heures murales.resume_job. La vérification « le créneau s’est écoulé pendant que vous étiez en pause » comparait des heures murales._repeat_alert_withheld. La fenêtre d’alerte répétée était mesurée en heure murale.
Un endroit a été examiné et délibérément laissé tel quel : la vérification de skew dans claim_job_for_fire fonctionnait déjà sur des instants, parce que l’heure planifiée à laquelle elle se compare est stockée comme une chaîne UTC, si bien que les deux valeurs portent des objets tzinfo différents et que Python retombe sur une comparaison en temps réel par accident de construction. C’est exactement le genre de détail dont cette classe de bug se nourrit.
Deux pièges voisins que Hermes gère déjà
Pendant que vous êtes dans le code de votre propre scheduler, deux problèmes voisins valent la peine d’être connus, parce que Hermes les rencontre aussi :
Les timestamps legacy naïfs. Des lignes plus anciennes stockaient des heures sans aucun fuseau. Hermes les lit comme de l’heure murale locale au système — ce qui les a créées — et convertit, plutôt que de supposer qu’elles étaient en UTC. Ce choix existe pour éviter de déclarer un job futur « non dû » simplement parce que le fuseau de la machine diffère de celui du profile.
Un offset obsolète après un changement de fuseau. Si vous déplacez votre profile d’un fuseau vers un autre, un timestamp stocké peut porter un offset qui fait paraître un run futur en retard — le commentaire source donne l’exemple de 21:00+10 devenant 13:00+02. Hermes compare les heures murales naïves pour séparer « votre horloge n’a pas encore atteint ce point » de « ceci n’a vraiment jamais tourné ».
Il existe un troisième cas, et c’est la raison pour laquelle un next_run_at obsolète est classé plutôt que simplement jeté : une migration de fuseau légitime et une édition manuelle d’une expression cron demandent des réponses opposées. Normaliser une ligne legacy en UTC vers le fuseau du profile change sa représentation sans changer l’intention, la ré-ancrer comme si quelqu’un avait édité l’expression sauterait donc une occurrence due qui ne s’est jamais déclenchée. Hermes vérifie par conséquent si l’heure murale stockée est encore une occurrence légale de l’expression courante : si oui, la ligne vient d’une migration ; sinon, elle vient d’une édition.
Ce que cela signifie pour vous
- Seuls les jobs avec un fuseau configuré étaient affectés. Une installation sur le fuseau local du serveur n’a jamais eu tort.
- La fenêtre est étroite et rare — environ une heure, deux fois par an, dans les fuseaux qui observent l’heure d’été. Si vous ne l’avez jamais remarqué, vous ne faisiez probablement rien tourner dans cette heure-là.
- Le symptôme n’est pas toujours « trop tôt ». Selon le côté de la transition où tombait une comparaison, un job pouvait aussi atterrir une heure trop tard.
- Rien à configurer. Aucun flag à poser, aucune clé de config à basculer ; les jobs récupèrent le correctif avec le code.
- Si vous ne pouvez pas mettre à jour aujourd’hui, l’atténuation pratique consiste à garder les plannings critiques hors de l’heure répétée — les deux jours de changement d’heure, déplacez un job de 01:30 à 03:30.
Pour voir ce que vos propres jobs pensent être leur prochaine exécution, hermes cron list affiche les jobs planifiés et hermes cron status vous dit si le scheduler tourne tout court — beaucoup de rapports « mon job s’est déclenché trop tôt » se révèlent être un second processus de scheduler. hermes cron runs montre les tentatives d’exécution durables par job, hermes cron incidents liste les incidents d’échec enregistrés, et hermes cron doctor vérifie vos jobs pour les problèmes de santé courants, ce qui en fait le premier arrêt le plus rapide après tout déclenchement bizarre.
Le correctif est sur main après le tag v0.21.4, il arrive donc avec votre prochaine récupération de main ou la prochaine release taguée. Pour la vue d’ensemble, notre guide du cron doctor détaille les vérifications de santé, et le guide de l’automatisation cron couvre les plannings et les modes de livraison depuis le début.