Dein Cron-Job feuerte eine Stunde zu früh: der DST-Bug, den Hermes gerade gefixt hat
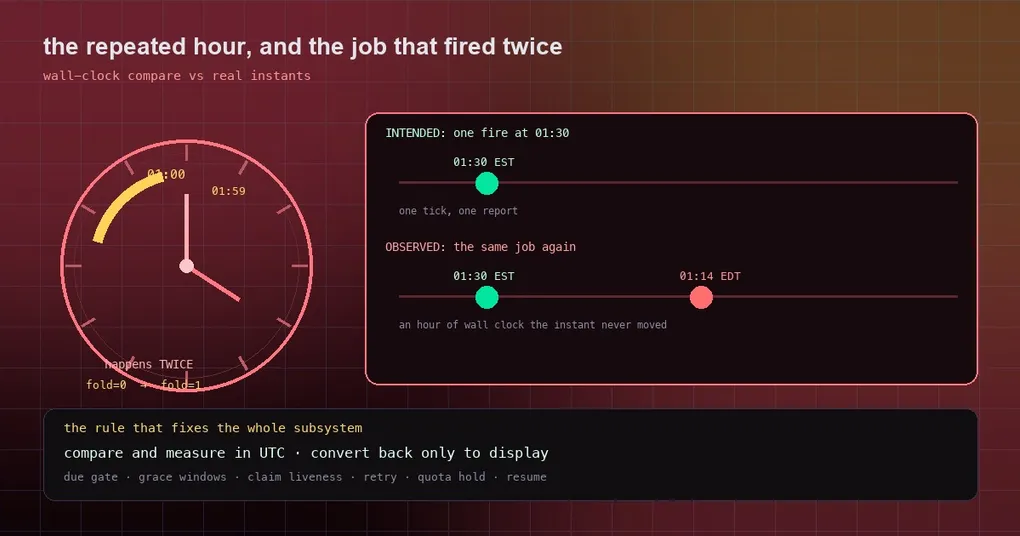
Es ist die Nacht, in der die Uhren zurückgestellt werden, und dein nächtlicher 01:30-Report läuft zweimal — oder dein 09:00-Briefing kommt um 08:00. Du hast nichts geändert, der Server wurde nie neu gestartet, und die Logs zeigen den Scheduler genau das tun, was ihm gesagt wurde. An deiner Konfiguration ist nichts falsch. Der Bug war Arithmetik: Python addiert und subtrahiert aware datetimes innerhalb einer Zeitzone nach Wall Clock, und genau die wiederholte Stunde ist die Stelle, an der Wall Clock und reale Zeit aufhören übereinzustimmen.
Hermes hat das behoben (#120314, rettet #119710). Wenn du irgendeinen Job mit konfigurierter Zeitzone laufen lässt, sind zehn Minuten Aufmerksamkeit hier gut investiert.
Die wiederholte Stunde ist eine Falle für fold
Jeder Job, den Hermes nach einem Schedule ausführt, trägt einen Zeitpunkt. Die Zone kommt aus dem im Profil konfigurierten ZoneInfo — hermes_time.get_timezone() gibt sie zurück, oder None bei einer server-lokalen Installation. hermes cron create hat kein eigenes Timezone-Flag; die Profileinstellung ist die, die zählt.
Betrachte nun eine Zone, die Sommerzeit kennt. Am Rückwärts-Übergang findet 01:00–02:00 lokal zweimal statt: einmal mit dem alten Offset (EDT) und einmal mit dem neuen (EST). Python hält beide, indem es ein fold-Flag anhängt — fold=0 für den ersten Durchlauf, fold=1 für den zweiten.
Der Haken: Wenn du zwei aware datetimes vergleichst oder subtrahierst, die dasselbe tzinfo-Objekt teilen, vergleicht Python sie nach Wall Clock und ignoriert fold vollständig. 01:11 EST, also 06:11 UTC, galt damit als fällig um 01:14 EDT, also 05:14 UTC. Derselbe blinde Fleck steckt in aware + timedelta, was ebenfalls Wall-Clock-Arithmetik ist und fold unterwegs verwirft.
Eine Zeile im Quellcode sagt es besser als ein ganzer Absatz:
def _seconds_after(dt, seconds):
    """*dt* plus echte *seconds*, in der Zone von *dt*. Aware ``+ timedelta`` ist
    Wall-Clock-Arithmetik, die ``fold`` verwirft, deshalb landet sie innerhalb einer
    Rückwärts-Stunde eine Stunde daneben."""
    return (dt.astimezone(timezone.utc) + timedelta(seconds=seconds)).astimezone(dt.tzinfo)
Der Fix für das gesamte Subsystem ist genau diese eine Idee, überall angewandt: in UTC vergleichen und messen, erst zur Anzeige in die Zone des Aufrufers zurückrechnen.
Was sich tatsächlich geändert hat
Der Due-Scan wurde um UTC-Zeitpunkte und echte verstrichene Sekunden herum neu geschrieben. Die Liste ist lang genug, um zu zeigen, wie tief die Wall-Clock-Arithmetik reichte:
- das Due-Gate selbst, das Fast-Forward-Grace-Window und das One-Shot-Grace-Window,
- die Dispatch-Lateness,
- die Claim-Liveness — ob der Claim eines anderen Workers auf einen Job noch frisch ist,
- Stale-Error-Re-Arm, das Timezone-Repair-Pre-Gate und die One-Shot-Recovery,
- der Misfire-Backstop für externe Provider, der überfällige Jobs feuert.
Dieselbe Bug-Klasse tauchte an vier weiteren Stellen auf, und alle vier sind jetzt zeitpunktbasiert:
unreachable_retry.plan_retry. Ein Job, der fehlschlug und in 300 Sekunden erneut versucht werden sollte, berechnetenow + 300 sum01:30 ESTund landete auf01:35 EDT— 55 Minuten in der Vergangenheit. Der Retry feuerte dann direkt beim nächsten Tick, statt fünf Minuten zu warten.quota_hold. Das Ende des Usage-Fensters eines Providers konnte eine Stunde danebenliegen, undhold_activeverglich Wall Clocks.resume_job. Die Prüfung „der Slot ist verstrichen, während du pausiert warst“ verglich Wall Clocks._repeat_alert_withheld. Das Repeat-Alert-Fenster wurde in Wall Time gemessen.
Eine Stelle wurde untersucht und bewusst unangetastet gelassen: Der Skew-Check in claim_job_for_fire arbeitete schon mit Zeitpunkten, weil die geplante Zeit, gegen die er vergleicht, als UTC-String gespeichert ist; die beiden Werte tragen also unterschiedliche tzinfo-Objekte, und Python fällt durch einen Konstruktionszufall auf den Echtzeitvergleich zurück. Genau solche Details sind es, von denen diese Bug-Klasse lebt.
Zwei verwandte Fallen, die Hermes bereits abfängt
Wenn du ohnehin schon im Code deines eigenen Schedulers steckst, lohnen zwei benachbarte Probleme, weil Hermes sie ebenfalls trifft:
Naive Legacy-Timestamps. Ältere Zeilen speicherten Zeiten ganz ohne Zeitzone. Hermes liest sie als system-lokale Wall Time — also als das, was sie erzeugt hat — und rechnet um, statt sie als UTC anzunehmen. Diese Entscheidung existiert, um zu vermeiden, dass ein zukünftiger Job nur deshalb als „nicht fällig“ gilt, weil die Zone der Maschine von der des Profils abweicht.
Ein veralteter Offset nach einer Zeitzonenänderung. Wenn du dein Profil von einer Zone in eine andere verschiebst, kann ein gespeicherter Timestamp einen Offset tragen, der einen zukünftigen Lauf überfällig aussehen lässt — der Quellkommentar nennt das Beispiel 21:00+10, das zu 13:00+02 wird. Hermes vergleicht die naiven Wall Clocks, um „deine Uhr hat das noch nicht erreicht“ von „das lief wirklich nie“ zu trennen.
Es gibt einen dritten Fall, und er ist der Grund, warum ein veraltetes next_run_at klassifiziert statt einfach verworfen wird: Eine legitime Zeitzonen-Migration und eine Handänderung an einem Cron-Ausdruck brauchen entgegengesetzte Reaktionen. Eine Legacy-UTC-Zeile in die Profil-Zeitzone zu normalisieren ändert ihre Darstellung, ohne die Absicht zu ändern; sie neu zu verankern, als hätte jemand den Ausdruck bearbeitet, würde eine fällige Ausführung überspringen, die nie gefeuert hat. Hermes prüft deshalb, ob die gespeicherte Wall Clock noch eine legale Occurrence des aktuellen Ausdrucks ist: Wenn ja, kam die Zeile aus einer Migration; wenn nein, aus einer Bearbeitung.
Was das für dich bedeutet
- Betroffen waren nur Jobs mit konfigurierter Zeitzone. Eine server-lokale Installation lag nie falsch.
- Das Fenster ist schmal und selten — etwa eine Stunde, zweimal im Jahr, in Zonen mit Sommerzeit. Wenn dir nie etwas aufgefallen ist, hattest du innerhalb dieser Stunde vermutlich einfach nichts laufen.
- Das Symptom ist nicht immer „zu früh“. Je nachdem, auf welcher Seite des Übergangs ein Vergleich landete, konnte ein Job auch eine Stunde zu spät kommen.
- Nichts zu konfigurieren. Es gibt kein Flag zum Setzen und keinen Config-Key zum Umlegen; die Jobs übernehmen den Fix mit dem Code.
- Wenn du heute nicht upgraden kannst, ist die praktische Abhilfe, kritische Schedules aus der wiederholten Stunde herauszuhalten — verschiebe an den beiden DST-Tagen einen 01:30-Job auf 03:30.
Um zu sehen, was deine eigenen Jobs für ihren nächsten Lauf halten, zeigt hermes cron list die geplanten Jobs und hermes cron status sagt dir, ob der Scheduler überhaupt läuft — viele Meldungen der Art „mein Job feuerte zu früh“ entpuppen sich als zweiter Scheduler-Prozess. hermes cron runs zeigt dauerhafte Ausführungsversuche pro Job, hermes cron incidents listet aufgezeichnete Fehler-Incidents, und hermes cron doctor prüft deine Jobs auf gängige Health-Probleme — die schnellste erste Anlaufstelle nach jedem seltsamen Feuern.
Der Fix liegt nach dem Tag v0.21.4 auf main, kommt also mit deinem nächsten Pull von main oder dem nächsten getaggten Release. Für das größere Bild geht unser Cron-Doctor-Guide die Health-Checks im Detail durch, und der Cron-Automation-Guide behandelt Schedules und Delivery-Modi von Anfang an.