Tu cron job se disparó una hora antes: el bug de DST que Hermes acaba de arreglar
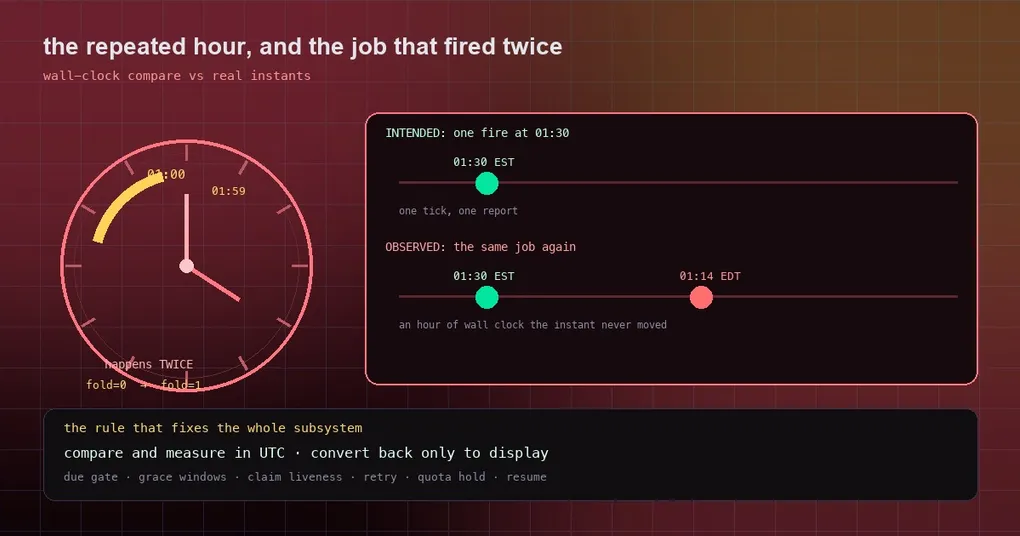
Es la noche en que los relojes atrasan y tu informe nocturno de las 01:30 se ejecuta dos veces — o tu briefing de las 09:00 aparece a las 08:00. No has tocado nada, el servidor no se ha reiniciado y los logs muestran que el scheduler hizo exactamente lo que se le dijo. Nada en tu configuración está mal. El bug era aritmética: Python suma y resta datetimes aware dentro de una misma zona horaria por reloj de pared, y la hora repetida es justo donde el reloj de pared y el tiempo real dejan de coincidir.
Hermes lo arregló (#120314, rescatando #119710). Si ejecutas algún job con una zona horaria configurada, esto merece diez minutos de tu atención.
La hora repetida es una trampa para fold
Cada job que Hermes lanza desde un schedule lleva un instante asociado. La zona sale del ZoneInfo configurado en el profile: hermes_time.get_timezone() lo devuelve, o None para una instalación con la zona local del servidor. hermes cron create no tiene un flag propio de zona horaria; el ajuste del profile es el que cuenta.
Ahora piensa en una zona que observa horario de verano. En la transición de otoño, las 01:00–02:00 locales ocurren dos veces: una con el offset antiguo (EDT) y otra con el nuevo (EST). Python conserva ambos casos añadiendo un flag fold: fold=0 para el primer paso, fold=1 para el segundo.
El detalle está en que, cuando comparas o restas dos datetimes aware que comparten el mismo objeto tzinfo, Python los compara por reloj de pared e ignora fold por completo. Así, 01:11 EST, que son las 06:11 UTC, se trataba como vencido a las 01:14 EDT, que son las 05:14 UTC. El mismo punto ciego aparece en aware + timedelta, que también es aritmética de reloj de pared y va perdiendo fold por el camino.
Una línea del código fuente lo explica mejor que un párrafo entero:
def _seconds_after(dt, seconds):
    """*dt* plus real *seconds*, in *dt*'s zone. Aware ``+ timedelta`` is wall-clock arithmetic
    that drops ``fold``, so inside a fall-back hour it lands an hour off."""
    return (dt.astimezone(timezone.utc) + timedelta(seconds=seconds)).astimezone(dt.tzinfo)
El arreglo de todo el subsistema es esa única idea, aplicada en todas partes: comparar y medir en UTC, y convertir de vuelta a la zona de quien llama solo para mostrar.
Qué cambió realmente
El scan de vencimientos se reescribió en torno a instantes UTC y a segundos reales transcurridos. La lista es lo bastante larga como para mostrar hasta dónde había llegado la aritmética de reloj de pared:
- la propia puerta de vencimiento, la ventana de gracia de fast-forward y la de one-shot,
- el retraso del dispatch,
- la liveness de los claims — si el claim de otro worker sobre un job sigue fresco,
- el re-arm de errores obsoletos, la pre-puerta de reparación de zona horaria y la recuperación de one-shot,
- el backstop de misfire de proveedores externos que dispara los jobs atrasados.
La misma clase de bug apareció en cuatro sitios más, y los cuatro son ahora basados en instantes:
unreachable_retry.plan_retry. Un job que falló y pidió reintentarse en 300 segundos calculabanow + 300 sa las01:30 ESTy caía en las01:35 EDT— 55 minutos en el pasado. El retry se disparaba entonces en el siguiente tick en lugar de esperar cinco minutos.quota_hold. El final de la ventana de uso de un proveedor podía irse una hora, yhold_activecomparaba relojes de pared.resume_job. La comprobación de “el slot pasó mientras estabas en pausa” comparaba relojes de pared._repeat_alert_withheld. La ventana de alerta repetida se medía en tiempo de reloj de pared.
Hay un sitio que se examinó y se dejó a propósito como estaba: la comprobación de skew en claim_job_for_fire ya trabajaba con instantes, porque la hora programada contra la que compara se guarda como cadena UTC, así que los dos valores llevan objetos tzinfo distintos y Python cae en una comparación de tiempo real por accidente de construcción. Es exactamente el tipo de detalle del que se alimenta esta clase de bug.
Dos trampas relacionadas que Hermes ya maneja
Ya que estás en el código de tu propio scheduler, hay dos problemas vecinos que conviene conocer, porque Hermes también se los encuentra:
Timestamps legacy naive. Las filas antiguas guardaban horas sin zona horaria alguna. Hermes las lee como hora de reloj de pared local del sistema —lo que las creó— y convierte, en lugar de asumir que eran UTC. Esa decisión existe para no declarar “no vencido” un job futuro solo porque la zona de la máquina difiere de la del profile.
Un offset obsoleto tras cambiar de zona horaria. Si mueves tu profile de una zona a otra, un timestamp guardado puede llevar un offset que haga que una ejecución futura parezca vencida; el comentario del código da el ejemplo de 21:00+10 convertido en 13:00+02. Hermes compara los relojes de pared naive para separar “tu reloj todavía no ha llegado aquí” de “esto genuinamente nunca se ejecutó”.
Hay un tercer caso, y es la razón por la que un next_run_at obsoleto se clasifica en lugar de descartarse sin más: una migración de zona horaria legítima y una edición a mano de una expresión cron necesitan respuestas opuestas. Normalizar una fila legacy en UTC hacia la zona del profile cambia su representación sin cambiar la intención, así que volver a anclarla como si alguien hubiera editado la expresión se saltaría una ocurrencia vencida que nunca llegó a dispararse. Por eso Hermes comprueba si el reloj de pared guardado sigue siendo una ocurrencia legal de la expresión actual: si lo es, la fila viene de una migración; si no, viene de una edición.
Qué significa esto para ti
- Solo se vieron afectados los jobs con una zona horaria configurada. Una instalación con la zona local del servidor nunca estuvo mal.
- La ventana es estrecha y poco frecuente: aproximadamente una hora, dos veces al año, en las zonas que observan horario de verano. Si nunca lo notaste, probablemente no ejecutabas nada dentro de esa hora.
- El síntoma no siempre es “antes”. Según de qué lado de la transición cayera una comparación, un job podía irse también una hora tarde.
- Nada que configurar. No hay flag que poner ni clave de config que tocar; los jobs recogen el arreglo con el código.
- Si no puedes actualizar hoy, la mitigación práctica es mantener los schedules críticos fuera de la hora repetida: en los dos días del cambio de DST, mueve un job de las 01:30 a las 03:30.
Para ver qué cree cada uno de tus jobs que es su próxima ejecución, hermes cron list muestra los jobs programados y hermes cron status te dice si el scheduler está corriendo siquiera — muchísimos informes de “mi job se disparó antes” resultan ser un segundo proceso del scheduler. hermes cron runs muestra los intentos de ejecución durables por job, hermes cron incidents lista los incidentes de fallo registrados, y hermes cron doctor revisa tus jobs en busca de problemas de salud habituales, la primera parada más rápida después de cualquier disparo raro.
El arreglo está en main después del tag v0.21.4, así que llega con tu próximo pull de main o con la próxima release etiquetada. Para tener la foto completa, nuestra guía de cron doctor repasa las comprobaciones de salud en detalle y la guía de automatización con cron cubre los schedules y los modos de entrega desde el principio.