定时任务跑了 2 小时 02 分就被判"卡死":现在按沉默时间算,不按运行时长算
周日凌晨三点,你的周报任务开始跑。它要拉十几个数据源、写文件、发消息,正常要跑两个半小时。凌晨五点零二分,日志里出现一行:
RuntimeError: Cron job 'weekly-digest' lost its durable fire claim ownership然后任务停了。那一周的输出全没了,jobs.json 里留下 last_status: error。你去看进程,外部 worker 的 PID 还活着——刚才它明明正在调工具。
十月初合并的 #133791 修的就是这件事。它的根因很有意思:一个判断“这个任务是不是卡死了”的机制,用的是运行了多久,而不是多久没动静。
2 小时这个数字从哪来
Hermes 的 cron 每次执行都会先在 ~/.hermes/cron/executions.db 里记一条账,状态从 claimed 到 running,最后落到唯一的终态之一:completed、failed 或 unknown。这个账本是给“进程突然死掉”兜底的:重启之后,Hermes 会把那些被遗弃、且能证明原进程已经不在的尝试标成 unknown,这样它们不会被误当成还在跑。
问题出在“能证明”的判定上。除了“原 PID 和进程启动指纹都证明它没了”这条硬证据之外,还有一个基于时间的兜底:如果账本上的 owner 看起来还活着,但它“安静”太久了,也按丢失处理。这个“太久”的上界是这样算出来的:
max(3 × HERMES_CRON_TIMEOUT, 脚本超时, 2 小时)HERMES_CRON_TIMEOUT 是空闲(inactivity)超时,不是墙钟超时——默认 600 秒,设 0 表示不限制。所以 3 × 600 = 1800 秒,但还有一个 7200 秒的下限(LIVE_OWNER_STALE_CLAIM_FLOOR_SECONDS)兜着,最终结果就是2 小时。
于是每个健康的长任务都踩了同一个雷:只要一次运行超过 2 小时,无论它在多积极地调工具,都会被扫进“owner 卡死”,账本被翻成 unknown 并带上 _OWNER_WEDGED_REASON;网关的等待循环看到一个终态行,心跳立刻失败(_FireOwnership.lost()),任务被中断。PR 里那台机器有 61 个 cron 任务,其中两个周任务在同一天以完全相同的方式死掉——启动后 2 小时 02 分,误差只在秒级。
真正讽刺的地方在这里:空闲看门狗本来就一直知道 agent 是活跃的(它按空闲时间中断任务),只是账本没被告知这件事。两个组件读同一个信号,一个用它中断,一个却用运行时长做判断。
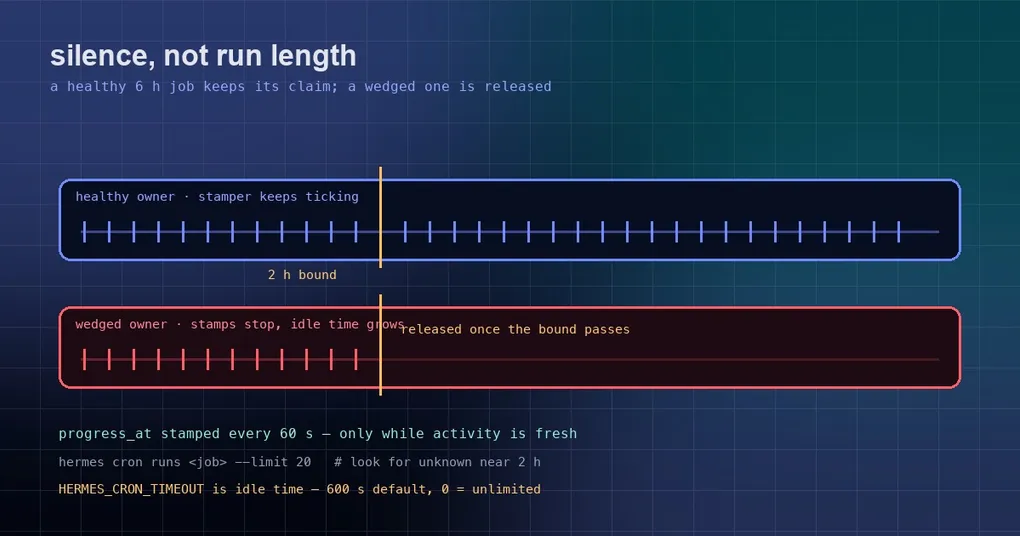
修复:把“运行了多久”换成“多久没说话”
改动分三块:
cron/executions.py里给executions表加了一个可空的progress_at列(用补列方式,不影响老库),并新增touch_execution_progress(execution_id),由持有该行的进程盖章;- 扫描逻辑改为用
_stale_age_seconds(claimed_at, progress_at)判断——优先看最后一次盖章时间,老数据没有盖章时才退回认领时间; - 新文件
cron/scheduler_liveness.py里加了盖章器:它挂在_run_agent_with_watchdog已有的 5 秒监控循环上,每 60 秒盖一次章,但只在agent.get_activity_summary()显示活动时间足够新的时候才盖。
第 3 条是关键的对称设计:一个真的卡在锁上的 worker,它的空闲时间会持续增长,于是停止盖章,等上界过去之后照样被释放。换句话说:
| 情况 | progress_at |
结果 |
|---|---|---|
| 跑了 6 小时,一直在调工具 | 每分钟都在更新 | 保留认领,不会被回收 |
| 卡在锁上,2 小时没动静 | 停止更新 | 到达上界后被释放 |
老账本行,没有 progress_at |
不存在 | 退回按认领时间判断(行为同以前) |
开销是每个运行中的任务每分钟多一条 UPDATE。顺带一个重构收益:cron/scheduler.py 从 4457 行降到 4436 行,看门狗循环搬去了新文件。
你能调什么
没有新配置项,也没有新开关——这次改的是判定依据,不是策略。你能控制的仍然是那个环境变量:
# 空闲多久算"卡死"(单位秒)。默认 600;设为 0 表示不限制
export HERMES_CRON_TIMEOUT=1800要注意它的语义是空闲时间,不是总时长:一个连着调工具的任务不算空闲。所以你不必为了跑长任务把它调大——这正是本次修复要做到的事。填错的值会被忽略并回落到 600 秒。
脚本类任务还有自己的超时(script timeout),它也参与上界的计算。
怎么确认自己踩过这个坑
hermes cron runs weekly-digest --limit 20 # 别名:hermes cron history看两个东西:终态是不是 unknown,以及它在 running 里待了多久。运行时长正好卡在 2 小时 02 分附近的 unknown,基本就是这次的问题。
需要知道的是,unknown 只是审计记录,Hermes 不会自动重跑它。丢掉的这一轮要你手动补:
hermes cron run weekly-digest     # 立刻补跑一次
hermes cron list                  # 检查 last_status 与下一次运行时间
hermes cron status                # 调度器是否还活着、有没有 OVERDUE 的任务
如果这类失败不止一次,建议顺手看一眼 cron 排障指南和定时任务的记忆连续性——前者覆盖调度器与投递层面的问题,后者解释长任务为什么需要跨运行保留上下文。命令参考在 hermes cron。
小结
- 症状:健康的长任务在启动约 2 小时 02 分后被中断,报
lost its durable fire claim ownership,该轮输出丢失,last_status: error; - 根因:实时 owner 的陈旧认领判定用的是认领时长,上界为
max(3 × HERMES_CRON_TIMEOUT, 脚本超时, 2 小时),默认就是 2 小时,而正在调工具的活跃信号从没进过账本; - 修复:新增
progress_at列,运行中的任务每 60 秒盖章(仅在确实活跃时),扫描改为按沉默时长判断;卡死的 worker 停止盖章,仍会被释放; - 你要做的:
hermes cron runs确认历史里有没有 2 小时附近的unknown;丢掉的轮次用hermes cron run手动补。
一句话:判断一个任务是不是死了,应该看它多久没说话,而不是看它活了多久。