Ein gesunder Cron-Job wurde nach 2h02m als 'verklemmt' erklärt — jetzt misst die Grenze Stille, nicht Laufzeit
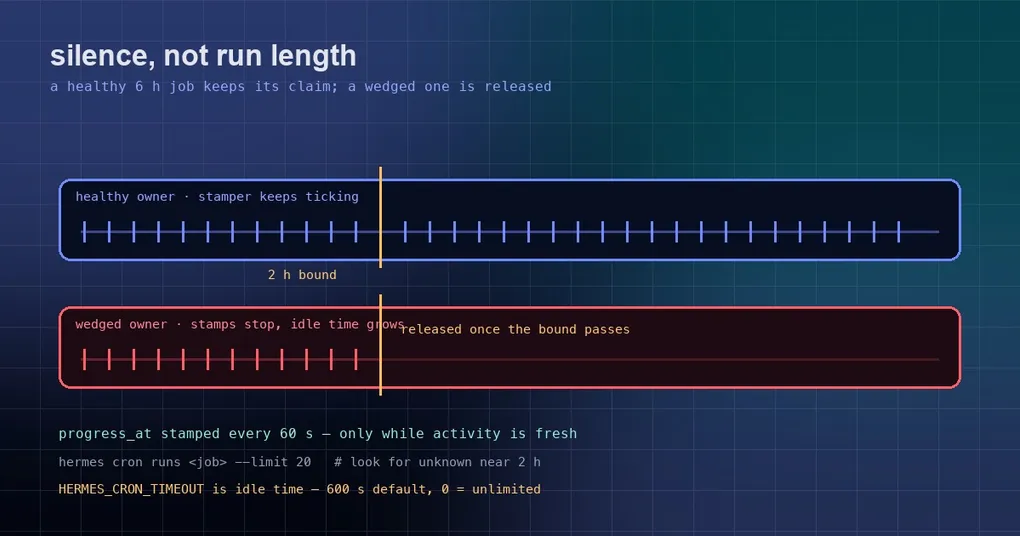
Es ist 3 Uhr nachts und dein wöchentlicher Digest-Job startet. Er zieht ein Dutzend Datenquellen, schreibt Dateien, verschickt Nachrichten — zweieinhalb Stunden Arbeit in einer normalen Woche. Um 5:02 Uhr gibt das Log Folgendes aus:
RuntimeError: Cron job 'weekly-digest' lost its durable fire claim ownershipDer Lauf stoppt. Die Ausgabe dieser Woche ist weg, und jobs.json verzeichnet last_status: error. Du prüfst den Prozess: Die externe Worker-PID lebt, und vor einem Moment war er mitten im Tool-Call-Stream.
PR #133791, Anfang Oktober gemerged, behebt genau das. Die Ursache ist für sich lesenswert: Der Mechanismus, der entscheidet, ob ein Job hängt, fragte wie lange er lief, nicht wie lange er still war.
Woher die zwei Stunden kamen
Jede Cron-Ausführung schreibt zuerst eine Zeile in die profil-lokale ~/.hermes/cron/executions.db. Versuche wandern von claimed nach running und enden in genau einem terminalen Zustand: completed, failed oder unknown. Das Ledger existiert, um einen mitten im Lauf sterbenden Prozess zu überleben: Nach einem Neustart markiert Hermes verwaiste Versuche als unknown, damit sie nicht für lebende Arbeit gehalten werden.
Das Problem lag im „beweis es“-Teil. Neben den harten Beweisen — der ursprünglichen PID und dem Prozessstart-Fingerprint, die zeigen, dass der Owner weg ist — gibt es einen zeitbasierten Fallback: wenn der Owner noch lebendig aussieht, aber zu lange still war, behandle den Claim als verloren. „Zu lange“ wurde so hergeleitet:
max(3 × HERMES_CRON_TIMEOUT, script timeout, 2 hours)HERMES_CRON_TIMEOUT ist ein Inaktivitäts-Limit, kein Wall-Clock-Limit — standardmäßig 600 Sekunden, und 0 bedeutet unbegrenzt. Also 3 × 600 = 1800 Sekunden, aber darunter sitzt ein Floor von 7200 Sekunden (LIVE_OWNER_STALE_CLAIM_FLOOR_SECONDS), und das Ergebnis ist zwei Stunden.
Jeder gesunde lange Job löste damit denselben Draht aus. Jeder Lauf über zwei Stunden, egal wie aktiv er Tools aufrief, wurde als toter Owner abgeräumt: Die Ledger-Zeile wurde mit _OWNER_WEDGED_REASON auf unknown umgestellt, die Warteschleife des Gateways sah eine terminale Zeile, _FireOwnership.lost() ließ den Heartbeat scheitern, und der Lauf wurde unterbrochen. Der Host im Bericht hatte 61 Cron-Jobs, und zwei wöchentliche starben am selben Tag auf genau dieselbe Weise — 2h02m nach dem Start, in Fehlerbegriffen Sekunden auseinander.
Die Ironie ist präzise: Der Inaktivitäts-Watchdog wusste bereits, dass der Agent aktiv war — er unterbricht Läufe anhand der Idle-Zeit. Das Ledger wurde es einfach nie gesagt. Zwei Komponenten lesen dasselbe Signal, und nur eine davon nutzte es.
Der Fix: Stille messen statt Laufzeit
Drei Änderungen:
cron/executions.pybekommt eine nullableprogress_at-Spalte aufexecutions(additiv hinzugefügt, sodass bestehende Datenbanken in-place upgraden) plustouch_execution_progress(execution_id), gestempelt vom Prozess, dem die Zeile gehört.- Der Sweep verzweigt jetzt auf
_stale_age_seconds(claimed_at, progress_at)— der letzte Stempel gewinnt, mit Rückfall auf das Claim-Alter nur für Legacy-Zeilen ohne Stempel. - Eine neue
cron/scheduler_liveness.pyenthält den Stamper: Er reitet auf der bestehenden 5-Sekunden-Monitor-Schleife in_run_agent_with_watchdogmit und stempelt alle 60 Sekunden, aber nur dann, wennagent.get_activity_summary()ausreichend aktuelle Aktivität meldet.
Punkt 3 ist das Design, das es sicher macht. Ein Worker, der echt auf einem Lock hängt, meldet wachsende Idle-Zeit, stempelt also nicht mehr, und wird trotzdem freigegeben, sobald die Grenze überschritten ist:
| Situation | progress_at |
Ergebnis |
|---|---|---|
| Sechs Stunden echte Arbeit, Tools laufen ständig | Jede Minute erneuert | Claim bleibt; nie zurückgeholt |
| Blockiert auf einem Lock, zwei Stunden Stille | Hört auf zu aktualisieren | Freigegeben, sobald die Grenze überschritten ist |
Legacy-Zeile ohne progress_at |
Fehlt | Fällt auf Claim-Alter zurück (vorheriges Verhalten) |
Die Kosten sind ein zusätzliches UPDATE pro Minute pro laufendem Job. Als Nebeneffekt des Refactorings schrumpfte cron/scheduler.py von 4457 auf 4436 Zeilen, weil die Watchdog-Schleife in das neue thematische Geschwister verschoben wurde.
Was du tunen kannst
Kein neuer Config-Key und kein neuer Schalter — das änderte die Evidenz, nicht die Policy. Der Knopf ist weiterhin die Umgebungsvariable:
# Wie viel Stille als "verklemmt" gilt, in Sekunden. Default 600; 0 = unbegrenzt
export HERMES_CRON_TIMEOUT=1800
Beachte die Semantik: Es ist Idle-Zeit, nicht Gesamtdauer. Ein Job, der ständig Tools aufruft, ist nicht idle, du musst ihn also nicht länger nur hochsetzen, damit lange Jobs fertig werden — genau das ist der Punkt des Fixes. Ungültige Werte werden ignoriert und fallen auf 600 Sekunden zurück.
Skriptbasierte Jobs tragen außerdem ihr eigenes script timeout, das an der hergeleiteten Grenze teilnimmt.
Prüfen, ob es dich erwischt hat
hermes cron runs weekly-digest --limit 20 # Alias: hermes cron historyAchte auf zwei Dinge: einen terminalen Zustand von unknown und darauf, wie lange der Versuch in running saß. Ein unknown, das fast genau bei 2h02m endete, ist dieser Bug.
Eines solltest du wissen: unknown ist ein Audit-Datensatz — Hermes führt ihn nie automatisch erneut aus. Der verlorene Zyklus liegt bei dir:
hermes cron run weekly-digest     # jetzt erneut auslösen
hermes cron list                  # last_status und die nächste Laufzeit prüfen
hermes cron status                # lebt der Scheduler, ist irgendetwas OVERDUE
Wenn dich das mehr als einmal erwischt hat, deckt der Cron-Troubleshooting-Leitfaden Scheduler- und Delivery-Fehler ab, und Memory-Kontinuität für geplante Jobs erklärt, warum lang laufende Jobs Kontext brauchen, um zwischen Läufen zu überleben. Kommandoreferenz: hermes cron.
Die Kurzfassung
- Symptom: Ein gesunder langer Job wird etwa 2h02m nach seinem Start mit
lost its durable fire claim ownershipunterbrochen, verliert die Ausgabe dieses Laufs und verzeichnetlast_status: error; - Ursache: Die Live-Owner-Stale-Claim-Grenze maß das Claim-Alter, mit einer Obergrenze von
max(3 × HERMES_CRON_TIMEOUT, script timeout, 2 hours)— standardmäßig zwei Stunden —, während das Aktivitätssignal das Ledger nie erreichte; - Fix: eine
progress_at-Spalte, alle 60 Sekunden gestempelt, aber nur während der Agent wirklich aktiv ist, und ein Sweep, der Stille misst; ein verklemmter Worker hört auf zu stempeln und wird trotzdem freigegeben; - Was zu tun ist: in
hermes cron runsnachunknown-Zeilen nahe der Zwei-Stunden-Marke suchen und mithermes cron rundie verlorenen Zyklen zurückholen.
Einfach gesagt: Um zu entscheiden, ob ein Job tot ist, frag, wie lange er still war, nicht wie lange er gelebt hat.