Un cron job saludable fue declarado "wedged" a las 2h02m — ahora el límite mide el silencio, no la duración de la ejecución
Son las 3 de la mañana y tu job semanal de resumen empieza a ejecutarse. Saca una docena de fuentes de datos, escribe archivos, envía mensajes — dos horas y media de trabajo en una semana normal. A las 5:02 el log imprime esto:
RuntimeError: Cron job 'weekly-digest' lost its durable fire claim ownershipLa ejecución se detiene. La salida de esa semana se ha perdido y jobs.json registra last_status: error. Compruebas el proceso: el PID del worker externo está vivo, y hace un momento estaba en medio de un flujo de llamadas a herramientas.
El PR #133791, fusionado a principios de octubre, arregla exactamente esto. La causa raíz merece leerse por sí sola: el mecanismo que decidía si un job estaba atascado preguntaba cuánto tiempo llevaba ejecutándose, no cuánto tiempo llevaba en silencio.
De dónde salían las dos horas
Cada ejecución de cron escribe primero una fila en el ~/.hermes/cron/executions.db local del perfil. Los intentos pasan de claimed a running y terminan en exactamente un estado terminal: completed, failed o unknown. El libro mayor existe para sobrevivir a un proceso que muere a mitad de ejecución: tras un reinicio, Hermes marca los intentos abandonados como unknown para que no se confundan con trabajo vivo.
El problema estaba en la parte de “demuéstralo”. Junto a la evidencia dura — el PID original y la huella de arranque del proceso que muestran que el owner se ha ido — hay un respaldo basado en el tiempo: si el owner todavía parece vivo pero lleva demasiado tiempo callado, trata el claim como perdido. Ese “demasiado tiempo” se derivaba así:
max(3 × HERMES_CRON_TIMEOUT, script timeout, 2 hours)HERMES_CRON_TIMEOUT es un límite de inactividad, no un límite de reloj de pared — 600 segundos por defecto, y 0 significa ilimitado. Así que 3 × 600 = 1800 segundos, pero por debajo hay un suelo de 7200 segundos (LIVE_OWNER_STALE_CLAIM_FLOOR_SECONDS), y el resultado son dos horas.
Por tanto, todo job largo y saludable tropezaba con el mismo cable. Cualquier ejecución de más de dos horas, por muy activamente que llamara a herramientas, se barría como owner muerto: la fila del libro mayor pasaba a unknown con _OWNER_WEDGED_REASON, el bucle de espera del gateway veía una fila terminal, _FireOwnership.lost() hacía fallar el heartbeat, y la ejecución se interrumpía. El host del informe tenía 61 cron jobs, y dos jobs semanales murieron el mismo día exactamente de la misma forma — 2h02m después del arranque, con segundos de diferencia en términos del error.
La ironía es precisa: el watchdog de inactividad ya sabía que el agente estaba activo — interrumpe ejecuciones en función del tiempo de inactividad. Al libro mayor simplemente nunca se le dijo. Dos componentes leen la misma señal, y solo uno la usó.
El arreglo: medir el silencio en lugar de la duración
Tres cambios:
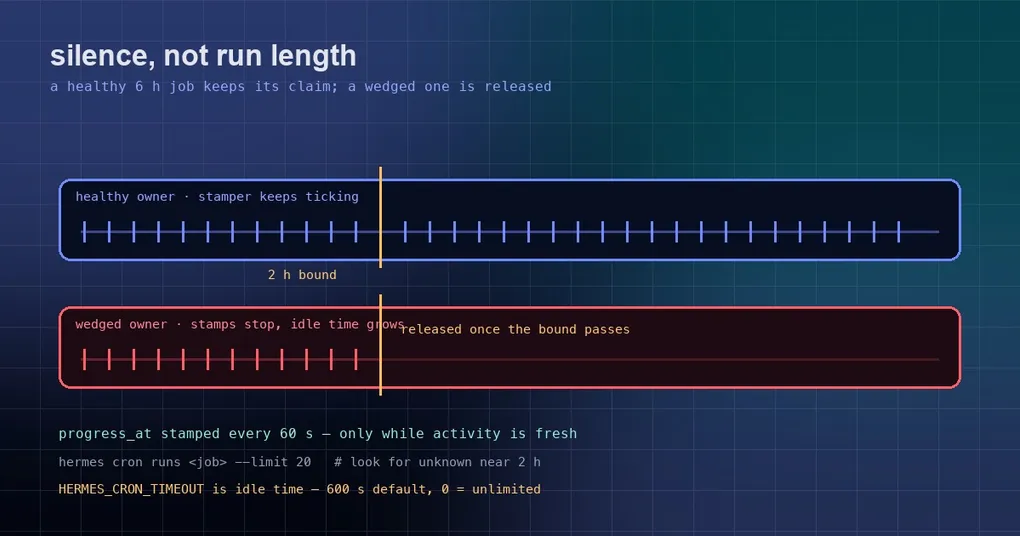
cron/executions.pygana una columnaprogress_atanulable enexecutions(añadida de forma aditiva, así que las bases de datos existentes se actualizan in situ) mástouch_execution_progress(execution_id), sellada por el proceso que posee la fila.- El barrido ahora ramifica sobre
_stale_age_seconds(claimed_at, progress_at)— gana el último sello, y solo recurre a la antigüedad del claim para filas heredadas que no tienen sello. - Un nuevo
cron/scheduler_liveness.pyalberga el sellador: se monta sobre el bucle de monitorización de 5 segundos que ya existe dentro de_run_agent_with_watchdogy sella cada 60 segundos, pero solo mientrasagent.get_activity_summary()informa de actividad lo bastante reciente.
El punto 3 es el diseño que lo hace seguro. Un worker realmente atascado en un lock informa de un tiempo de inactividad creciente, así que deja de sellar, y aun así se libera cuando pasa el límite:
| Situación | progress_at |
Resultado |
|---|---|---|
| Seis horas de trabajo real, herramientas siempre activas | Se refresca cada minuto | El claim se mantiene; nunca se reclama |
| Bloqueado en un lock, dos horas de silencio | Deja de actualizarse | Se libera cuando pasa el límite |
Fila heredada sin progress_at |
Ausente | Recurre a la antigüedad del claim (comportamiento anterior) |
El coste es un UPDATE extra por minuto por job en ejecución. Como efecto secundario del refactor, cron/scheduler.py pasó de 4457 a 4436 líneas, con el bucle del watchdog movido al nuevo hermano temático.
Qué puedes ajustar
Ninguna clave de config nueva y ningún interruptor nuevo — esto cambió la evidencia, no la política. El mando sigue siendo la variable de entorno:
# Cuánto silencio cuenta como "atascado", en segundos. Por defecto 600; 0 = ilimitado
export HERMES_CRON_TIMEOUT=1800
Ojo con la semántica: es tiempo de inactividad, no duración total. Un job que no deja de llamar a herramientas no está inactivo, así que ya no necesitas subirlo solo para dejar que los jobs largos terminen — que es justo el objetivo del arreglo. Los valores inválidos se ignoran y vuelven a 600 segundos.
Los jobs basados en scripts también llevan su propio script timeout, que participa en el límite derivado.
Comprobar si te ha afectado
hermes cron runs weekly-digest --limit 20 # alias: hermes cron historyBusca dos cosas: un estado terminal unknown, y cuánto tiempo permaneció el intento en running. Un unknown que terminó a casi exactamente 2h02m es este bug.
Una cosa que conviene saber: unknown es un registro de auditoría — Hermes nunca lo reejecuta automáticamente. El ciclo perdido es tuyo para recuperarlo:
hermes cron run weekly-digest     # lánzalo de nuevo ahora
hermes cron list                  # comprueba last_status y la próxima ejecución
hermes cron status                # ¿está vivo el scheduler?, ¿hay algo OVERDUE?
Si esto te ha mordido más de una vez, la guía de resolución de problemas de cron cubre fallos del scheduler y de entrega, y continuidad de memoria para jobs programados explica por qué los jobs de larga duración necesitan contexto que sobreviva entre ejecuciones. Referencia de comandos: hermes cron.
La versión corta
- Síntoma: un job largo y saludable se interrumpe aproximadamente 2h02m después de empezar con
lost its durable fire claim ownership, perdiendo la salida de esa ejecución y registrandolast_status: error; - Causa raíz: el límite de claim obsoleto del owner vivo medía la antigüedad del claim, con un tope superior de
max(3 × HERMES_CRON_TIMEOUT, script timeout, 2 hours)— dos horas por defecto — mientras que la señal de trabajo activo nunca llegaba al libro mayor; - Arreglo: una columna
progress_atsellada cada 60 segundos, pero solo mientras el agente está realmente activo, y un barrido que mide el silencio; un worker bloqueado deja de sellar y aun así se libera; - Qué hacer: revisa
hermes cron runsen busca de filasunknowncerca de la marca de las dos horas, y usahermes cron runpara recuperar los ciclos perdidos.
Dicho de forma simple: para decidir si un job está muerto, pregunta cuánto tiempo lleva callado, no cuánto tiempo lleva vivo.