Un job cron en bonne santé déclaré « bloqué » à 2h02 — désormais la borne mesure le silence, pas la durée d'exécution
Il est 3 h du matin et votre job de digest hebdomadaire démarre. Il interroge une douzaine de sources de données, écrit des fichiers, envoie des messages — deux heures et demie de travail lors d’une semaine normale. À 5 h 02, le journal imprime ceci :
RuntimeError: Cron job 'weekly-digest' lost its durable fire claim ownershipL’exécution s’arrête. La sortie de cette semaine est perdue et jobs.json enregistre last_status: error. Vous vérifiez le processus : le PID du worker externe est vivant, et il y a un instant il était au milieu d’un flux d’appels d’outils.
La PR #133791, fusionnée début octobre, corrige exactement cela. La cause racine mérite d’être lue en soi : le mécanisme qui décidait si un job était coincé demandait depuis combien de temps il tournait, pas depuis combien de temps il était silencieux.
D’où venaient les deux heures
Chaque exécution cron écrit d’abord une ligne dans la base locale au profil ~/.hermes/cron/executions.db. Les tentatives passent de claimed à running et se terminent dans exactement un état terminal : completed, failed ou unknown. Ce registre existe pour survivre à la mort d’un processus en pleine exécution : après un redémarrage, Hermes marque les tentatives abandonnées unknown pour qu’elles ne soient pas prises pour du travail vivant.
Le problème était dans la partie « prouve-le ». À côté des preuves dures — le PID d’origine et l’empreinte de démarrage du processus montrant que le propriétaire a disparu — il existe un repli basé sur le temps : si le propriétaire semble encore vivant mais est resté silencieux trop longtemps, considérer la revendication comme perdue. Ce « trop longtemps » était dérivé ainsi :
max(3 × HERMES_CRON_TIMEOUT, script timeout, 2 hours)HERMES_CRON_TIMEOUT est une limite d’inactivité, pas une limite de temps réel — 600 secondes par défaut, et 0 signifie illimité. Donc 3 × 600 = 1800 secondes, mais un plancher de 7200 secondes (LIVE_OWNER_STALE_CLAIM_FLOOR_SECONDS) se trouve en dessous, et le résultat est deux heures.
Chaque long job en bonne santé déclenchait donc le même piège. Toute exécution au-delà de deux heures, peu importe à quel point elle appelait activement des outils, était balayée comme propriétaire mort : la ligne du registre passait à unknown avec _OWNER_WEDGED_REASON, la boucle d’attente du gateway voyait une ligne terminale, _FireOwnership.lost() faisait échouer le heartbeat, et l’exécution était interrompue. L’hôte du rapport avait 61 jobs cron, et deux jobs hebdomadaires sont morts le même jour exactement de la même façon — 2h02 après le démarrage, à quelques secondes d’écart en termes d’erreur.
L’ironie est précise : le chien de garde d’inactivité savait déjà que l’agent était actif — il interrompt les exécutions selon le temps d’inactivité. Le registre, lui, n’en a jamais été informé. Deux composants lisaient le même signal, et un seul l’utilisait.
Le correctif : mesurer le silence au lieu de la durée d’exécution
Trois changements :
cron/executions.pygagne une colonneprogress_atnullable surexecutions(ajoutée de façon additive, donc les bases existantes se mettent à niveau sur place) plustouch_execution_progress(execution_id), estampillée par le processus qui détient la ligne.- Le balayage se branche désormais sur
_stale_age_seconds(claimed_at, progress_at)— la dernière estampille gagne, avec repli sur l’âge de la revendication uniquement pour les lignes héritées qui n’ont pas d’estampille. - Un nouveau
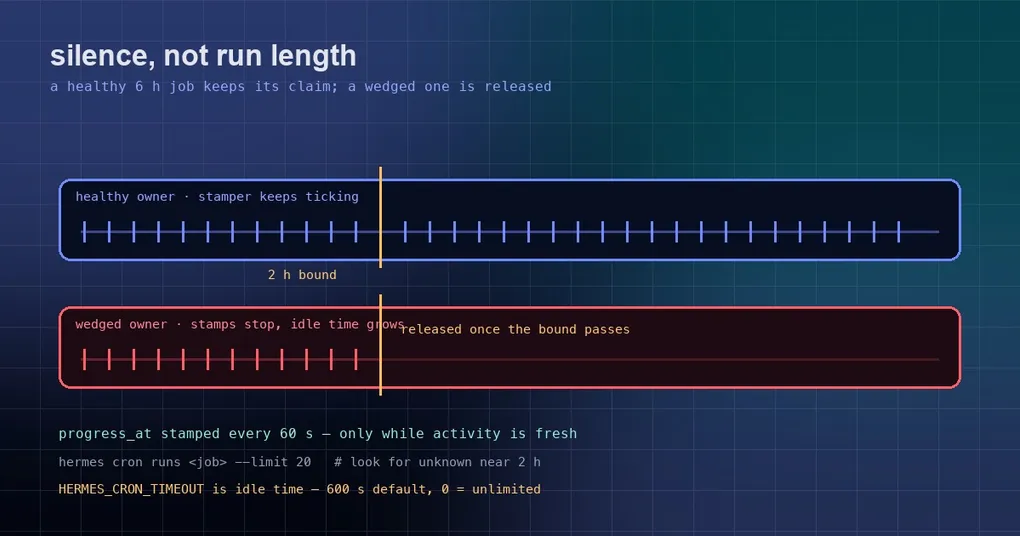
cron/scheduler_liveness.pyhéberge l’estampilleur : il s’appuie sur la boucle de surveillance existante de 5 secondes à l’intérieur de_run_agent_with_watchdoget estampille toutes les 60 secondes, mais seulement tant queagent.get_activity_summary()rapporte une activité assez récente.
Le point 3 est la conception qui le rend sûr. Un worker réellement bloqué sur un verrou rapporte un temps d’inactivité croissant, donc il arrête d’estampiller, et il est quand même libéré une fois la borne dépassée :
| Situation | progress_at |
Résultat |
|---|---|---|
| Six heures de travail réel, outils toujours en cours d’exécution | Rafraîchi chaque minute | La revendication est conservée ; jamais récupérée |
| Bloqué sur un verrou, deux heures de silence | Arrête de se mettre à jour | Libéré une fois la borne dépassée |
Ligne héritée sans progress_at |
Absent | Repli sur l’âge de la revendication (comportement précédent) |
Le coût est un UPDATE supplémentaire par minute et par job en cours. Effet secondaire du refactor, cron/scheduler.py est passé de 4457 à 4436 lignes, la boucle de surveillance ayant été déplacée vers le nouveau fichier frère thématique.
Ce que vous pouvez régler
Aucune nouvelle clé de config et aucun nouvel interrupteur — cela a changé les preuves, pas la politique. Le réglage reste la variable d’environnement :
# Combien de silence compte comme « wedged », en secondes. Défaut 600 ; 0 = illimité
export HERMES_CRON_TIMEOUT=1800
Notez la sémantique : c’est le temps d’inactivité, pas la durée totale. Un job qui continue d’appeler des outils n’est pas inactif, donc vous n’avez plus besoin de l’augmenter juste pour laisser les longs jobs se terminer — ce qui est tout l’intérêt du correctif. Les valeurs invalides sont ignorées et retombent à 600 secondes.
Les jobs basés sur des scripts portent aussi leur propre script timeout, qui participe à la borne dérivée.
Vérifier si vous avez été touché
hermes cron runs weekly-digest --limit 20 # alias : hermes cron historyCherchez deux choses : un état terminal unknown, et combien de temps la tentative est restée en running. Un unknown qui s’est terminé à presque exactement 2h02 est ce bug.
Une chose à savoir : unknown est un enregistrement d’audit — Hermes ne le relance jamais automatiquement. Le cycle perdu est à vous de récupérer :
hermes cron run weekly-digest     # le relancer maintenant
hermes cron list                  # vérifier last_status et la prochaine exécution
hermes cron status                # le scheduler est-il vivant, quelque chose est-il OVERDUE
Si cela vous a mordu plus d’une fois, le guide de dépannage cron couvre les échecs du scheduler et de la livraison, et la continuité de mémoire pour les jobs planifiés explique pourquoi les jobs de longue durée ont besoin de contexte pour survivre entre les exécutions. Référence des commandes : hermes cron.
En bref
- Symptôme : un long job en bonne santé est interrompu environ 2h02 après son démarrage avec
lost its durable fire claim ownership, perdant la sortie de cette exécution et enregistrantlast_status: error; - Cause racine : la borne de revendication périmée du propriétaire vivant mesurait l’âge de la revendication, avec une limite supérieure de
max(3 × HERMES_CRON_TIMEOUT, script timeout, 2 hours)— deux heures par défaut — alors que le signal de travail actif n’atteignait jamais le registre ; - Correctif : une colonne
progress_atestampillée toutes les 60 secondes mais seulement tant que l’agent est réellement actif, et un balayage qui mesure le silence ; un worker bloqué arrête d’estampiller et est quand même libéré ; - Que faire : vérifiez
hermes cron runspour les lignesunknownproches de la barre des deux heures, et utilisezhermes cron runpour récupérer les cycles perdus.
Dit simplement : pour décider si un job est mort, demandez depuis combien de temps il est silencieux, pas depuis combien de temps il est vivant.