Um cron job saudável foi declarado "travado" em 2h02m — agora o limite mede o silêncio, não a duração da execução
São 3 da manhã e seu job semanal de digest começa a rodar. Ele puxa uma dúzia de fontes de dados, escreve arquivos, envia mensagens — duas horas e meia de trabalho em uma semana normal. Às 5h02 o log imprime isto:
RuntimeError: Cron job 'weekly-digest' lost its durable fire claim ownershipA execução para. A saída daquela semana se foi e o jobs.json registra last_status: error. Você verifica o processo: o PID do worker externo está vivo, e um instante atrás ele estava no meio de um fluxo de chamadas de ferramentas.
O PR #133791, mesclado no início de outubro, corrige exatamente isso. A causa raiz merece ser lida por si só: o mecanismo que decidia se um job estava travado perguntava há quanto tempo ele estava rodando, não há quanto tempo estava quieto.
De onde vieram as duas horas
Toda execução de cron primeiro escreve uma linha no ~/.hermes/cron/executions.db, local ao profile. As tentativas passam de claimed para running e terminam em exatamente um estado terminal: completed, failed ou unknown. O ledger existe para sobreviver a um processo que morre no meio da execução: após um reinício, o Hermes marca as tentativas abandonadas como unknown para que não sejam confundidas com trabalho vivo.
O problema estava na parte do “prove isso”. Junto com a evidência dura — o PID original e a impressão digital de início do processo mostrando que o dono sumiu — há um fallback baseado em tempo: se o dono ainda parecer vivo mas estiver quieto por tempo demais, trate o claim como perdido. O “tempo demais” era derivado assim:
max(3 × HERMES_CRON_TIMEOUT, script timeout, 2 hours)HERMES_CRON_TIMEOUT é um limite de inatividade, não de tempo de relógio — 600 segundos por padrão, e 0 significa ilimitado. Então 3 × 600 = 1800 segundos, mas um piso de 7200 segundos (LIVE_OWNER_STALE_CLAIM_FLOOR_SECONDS) fica por baixo disso, e o resultado é duas horas.
Todo job longo saudável, portanto, esbarrava no mesmo fio. Qualquer execução além de duas horas, por mais ativamente que estivesse chamando ferramentas, era varrida como dono morto: a linha do ledger era virada para unknown com _OWNER_WEDGED_REASON, o loop de espera do gateway via uma linha terminal, _FireOwnership.lost() derrubava o heartbeat, e a execução era interrompida. O host no relato tinha 61 cron jobs, e dois semanais morreram no mesmo dia exatamente da mesma forma — 2h02m após o início, separados por segundos em termos de erro.
A ironia é precisa: o watchdog de inatividade já sabia que o agente estava ativo — ele interrompe execuções com base no tempo ocioso. O ledger simplesmente nunca foi informado. Dois componentes leem o mesmo sinal, e só um deles o usou.
A correção: medir o silêncio em vez da duração da execução
Três mudanças:
cron/executions.pyganha uma coluna anulávelprogress_atemexecutions(adicionada de forma aditiva, então bancos de dados existentes são atualizados no lugar) maistouch_execution_progress(execution_id), carimbada pelo processo que é dono da linha.- A varredura agora ramifica em
_stale_age_seconds(claimed_at, progress_at)— o último carimbo vence, caindo para a idade do claim apenas em linhas legadas que não têm carimbo. - Um novo
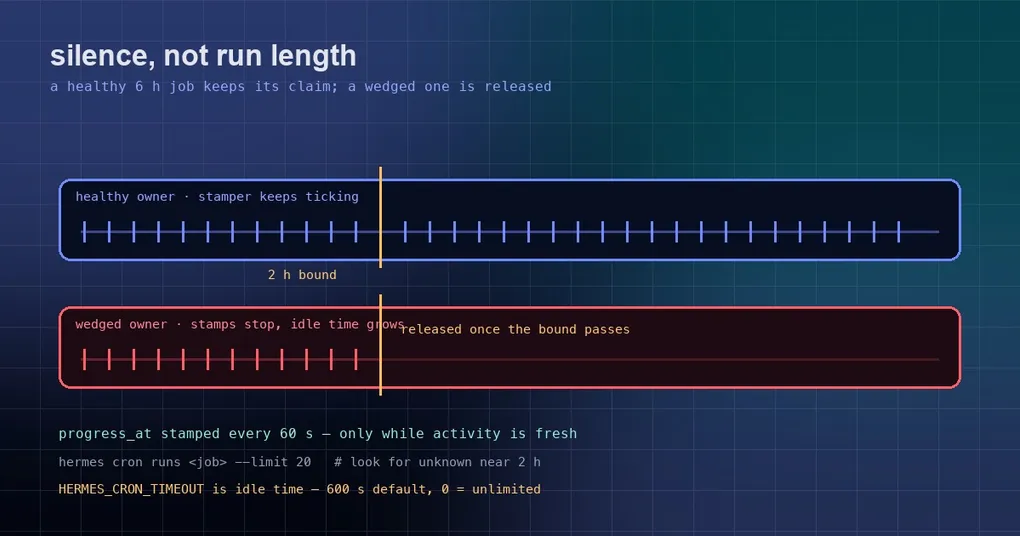
cron/scheduler_liveness.pyguarda o carimbador: ele pega carona no loop de monitoramento de 5 segundos existente dentro de_run_agent_with_watchdoge carimba a cada 60 segundos, mas apenas enquantoagent.get_activity_summary()relata atividade recente o suficiente.
O ponto 3 é o design que o torna seguro. Um worker genuinamente travado em um lock relata tempo ocioso crescente, então ele para de carimbar, e ainda assim é liberado quando o limite passa:
| Situação | progress_at |
Resultado |
|---|---|---|
| Seis horas de trabalho real, ferramentas sempre rodando | Atualizado a cada minuto | O claim é mantido; nunca recuperado |
| Bloqueado em um lock, duas horas de silêncio | Para de atualizar | Liberado quando o limite passa |
Linha legada sem progress_at |
Ausente | Cai para a idade do claim (comportamento anterior) |
O custo é um UPDATE extra por minuto por job em execução. Como efeito colateral da refatoração, cron/scheduler.py encolheu de 4457 para 4436 linhas, com o loop do watchdog movido para o novo irmão temático.
O que você pode ajustar
Nenhuma nova chave de config e nenhum novo interruptor — isso mudou a evidência, não a política. O botão continua sendo a variável de ambiente:
# Quanto silêncio conta como "travado", em segundos. Padrão 600; 0 = ilimitado
export HERMES_CRON_TIMEOUT=1800
Repare na semântica: é tempo ocioso, não duração total. Um job que continua chamando ferramentas não está ocioso, então você não precisa mais aumentar esse valor só para deixar jobs longos terminarem — que é o ponto da correção. Valores inválidos são ignorados e caem para 600 segundos.
Jobs baseados em script também carregam seu próprio script timeout, que participa do limite derivado.
Verificando se você foi atingido
hermes cron runs weekly-digest --limit 20 # alias: hermes cron historyProcure duas coisas: um estado terminal unknown e quanto tempo a tentativa ficou em running. Um unknown que terminou em quase exatamente 2h02m é este bug.
Uma coisa a saber: unknown é um registro de auditoria — o Hermes nunca o reexecuta automaticamente. O ciclo perdido é seu para recuperar:
hermes cron run weekly-digest     # dispare de novo agora
hermes cron list                  # verifique last_status e o horário da próxima execução
hermes cron status                # o scheduler está vivo, há algo OVERDUE
Se isso já te mordeu mais de uma vez, o guia de solução de problemas de cron cobre falhas de scheduler e de entrega, e continuidade de memória para jobs agendados explica por que jobs de longa duração precisam de contexto para sobreviver entre execuções. Referência de comando: hermes cron.
A versão curta
- Sintoma: um job longo saudável é interrompido cerca de 2h02m após começar com
lost its durable fire claim ownership, perdendo a saída daquela execução e registrandolast_status: error; - Causa raiz: o limite de stale-claim do dono vivo media a idade do claim, com um teto de
max(3 × HERMES_CRON_TIMEOUT, script timeout, 2 hours)— duas horas por padrão — enquanto o sinal de trabalho ativo nunca chegava ao ledger; - Correção: uma coluna
progress_atcarimbada a cada 60 segundos, mas só enquanto o agente está genuinamente ativo, e uma varredura que mede o silêncio; um worker em deadlock para de carimbar e ainda é liberado; - O que fazer: verifique
hermes cron runsem busca de linhasunknownperto da marca de duas horas, e usehermes cron runpara recuperar os ciclos que você perdeu.
Dito de forma simples: para decidir se um job morreu, pergunte há quanto tempo ele está quieto, não há quanto tempo está vivo.