别人的密钥,跑进了你的定时任务
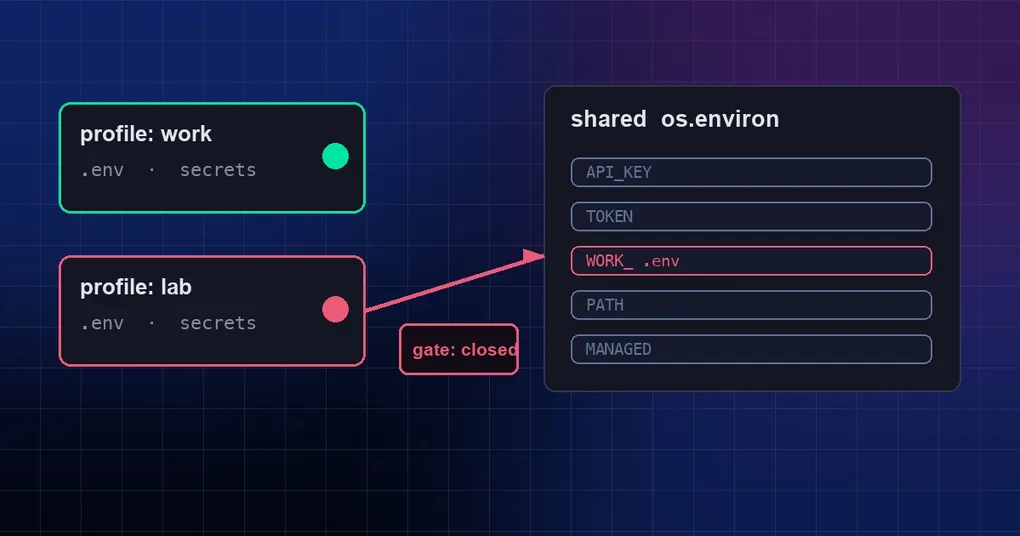
你在 work 这个 Profile 里放公司的 API Key,在 lab 里放自己的实验 Key,两边的定时任务互不相干——这是 Profile 最基本的承诺。然后某天你翻日志,发现 lab 的定时任务手上握着的是 work 的 Key。你没配错,是隔离机制在某次更新里被整段删掉了,而且删得一声不响。
这篇文章讲清楚三件事:什么叫「路由触发」、密钥是怎么串过去的、以及你该在自己的机器上检查什么。
先搞清楚:什么叫「路由触发」
Hermes 的 cron 默认不是「每个 Profile 起一个进程」。一个 ticker 会待在自己所在的进程里,把每个 Profile 到点的任务都点一遍。当这个进程属于 A Profile,而它触发的是 B Profile 的任务时,这次触发就叫 routed fire(路由触发)。
这本来是个很合理的复用:省内存,也少一个常驻进程。前提是——B 的任务在运行期间必须临时切换到 B 的密钥视野,跑完立刻撤掉。Hermes 管这个临时视野叫 secret scope(密钥作用域)。
隔离是什么时候没的
2026-09-15,修复 #111187 落到 main 上(提交 cedf4a3d78),它给路由触发加上了完整的作用域隔离。
几个小时之后,另一个提交 23036e20a6(标题是 “fix(ux): plain-language, actionable user-facing messages (core)”)改了 234 个文件,把这整套隔离连同它的测试一起删了。提交信息里一个字都没提这次删除。
代码删掉之后,真正危险的地方不是「少了几个函数」,而是失败的方式太安静。原本有四道关卡:
- 路由 dotenv 守卫——阻止 B 的
.env进入进程共享环境; get_secret的 fail-closed——查不到就报错,而不是回落到别人的值;- 子进程清洗——spawn 出来的子进程不该继承启动 Profile 的变量;
- 启动残留剥离——把上一个 Profile 留下的痕迹清干净。
这四道关卡的判断条件都是「当前是否处于 multiplex 语义」。而桌面版后端和独立 gateway 恰恰是在 multiplex 标志为关的状态下 tick 所有 Profile 的——于是它们全部变成空操作:不报错、不告警,看起来一切正常。
泄漏出去的到底是什么
两件事,都值得你在自己机器上确认一遍。
第一,B 的 .env 留在了进程环境里。 任务跑完之后这些变量并没有被清掉,于是启动 Profile 之后的每一轮对话、它 spawn 出的每个子进程,都能读到 B 的密钥。也就是说,泄漏范围不止那一次定时任务。
第二,托管 .env 那一层丢了。 build_profile_secret_scope 原本是按顺序叠加的,托管层(管理员或团队统一下发的凭据)放在最后、优先级最高。这一层没了之后:
- 如果同一个 key 你自己也配了一份,你自己的值会盖过管理员下发的值;
- 如果这个 key 只有管理员配过,那它对 Profile 来说等于不存在。
第二种情况更隐蔽——没有报错、没有异常,只有一个「为什么这个工具突然说没凭据」的疑问。
修复:四道关卡接回来,并且这次有测试守着
PR #126982 把之前那份修复原样接回当前的 main(保留原作者),并补上了托管 .env 层。具体改动如下:
| 位置 | 做了什么 |
|---|---|
agent/secret_scope.py |
新增 set_multiplex_context():一个 context-local 标志,与 is_multiplex_active() 做或运算;build_profile_secret_scope 把托管 .env 放回最后一层 |
cron/scheduler_provider.py |
_profile_cron_scope 判断「本次触发属于别的 Profile」,记为 routed_profile_fire |
cron/scheduler.py |
_install_fire_secret_scope / _reset_fire_secret_scope 负责注入与撤销;路由触发额外装上 multiplex 上下文,作用范围刚好就是这一次触发 |
tools/environments/local.py |
strip_launch_profile_env 剥离更多启动残留但不碰托管 key;新增 restore_managed_env;build_subprocess_env(strip_launch_profile=True) 先叠路由作用域、再叠托管 key |
验证方式是「先证明红、再证明绿」:把这 6 个测试放回修复前的 main(b9df1cccae)上,全部失败;修复后跑 205 个相关文件、1920 个测试通过、0 失败。
判断路由触发用的是「这次调用实际打到了哪个 endpoint」,而不是 Profile 的配置状态——所以一个付费池的 key 配在 guest Profile 旁边,不会被误判成免费层。
你该做什么
- 确认你的构建里有没有这个修复。 修复在 2026-09-30 合并进
main,而最新标签 v0.21.5 的日期是 9-24,所以标签里还没有它;走 git 安装并跟进main的用户已经在修复里了。 - 别把所有密钥都堆进全局
.env。 每个 Profile 该有自己的.env:hermes config set OPENROUTER_API_KEY ...这类 UPPER_SNAKE 名字写的正是当前 Profile 的.env,这也是平台配置流程和/sethome写的那一个文件。 - 一个进程 tick 多 Profile 的部署,就是这次的泄漏窗口。 桌面后端、独立 gateway 属于这一类;如果你跑的是 每个主机一个 gateway 且每个 Profile 各自独立,暴露面小得多。
- 跑一次只读体检。 hermes cron doctor 会列出失败的运行、失败的投递、过期的
next_run_at、缺失的脚本或工作目录,有问题时退出码非零。它不会直接告诉你「密钥串了」,但能告诉你哪些任务其实一直没跑成。命令参考见 hermes cron。 - 顺手确认托管凭据有没有生效。 如果团队统一下发了凭据,检查 Profile 里读到的值是不是你期望的那一份。凭据本身的加密存储方式,见 keychain 密钥加密指南。
- 多 Profile 的密钥边界值得整体过一遍。 如果你同时用多个 Profile 跑任务,Profile 独立 bot 的做法可以让每个 Profile 的 cron 走自己的通道,减少共享进程里的交叉面。
小结
这次事故的形状很典型:隔离逻辑本身没写错,是被一个和它毫无关系的 UX 提交顺手删掉的,而且删得没有任何提示。事后回看,值得记住的不是「某个函数被删了」,而是两层防线同时缺席——代码层没有测试守着,运行时也没有任何断言在隔离消失时喊一声。
对使用者来说,结论很朴素:Profile 之间密钥互不串门是承诺,但承诺需要验证。给你的每个 Profile 一份自己的 .env,把全局环境变量留空,然后定期用 hermes cron doctor 看一眼后台到底有没有在按你以为的方式跑。