A chave de API de outra pessoa rodou dentro do seu cron job
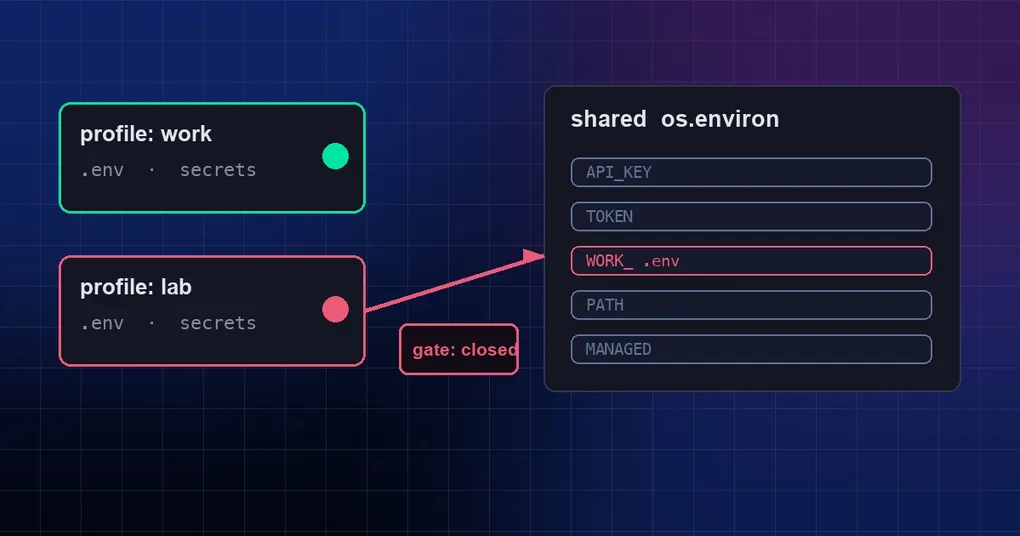
Você guarda a chave de API da sua empresa no profile work e seus próprios experimentos no lab. Os dois profiles não têm nada a ver um com o outro — é essa a promessa inteira dos profiles. Aí, numa manhã, você lê um log do cron e o job do lab está segurando a chave do work. Você não configurou nada errado: a camada de isolamento foi apagada inteira por um commit que nunca mencionou mexer nela.
Este texto cobre três coisas: o que é exatamente um “routed fire”, como as chaves atravessaram de um lado para o outro e o que checar na sua própria máquina.
Comece por aqui: o que é um routed fire
O Hermes cron não roda um processo por profile. Um único ticker fica no processo que o possui e percorre os jobs vencidos de todos os profiles. Quando esse processo pertence ao profile A, mas o job pertence ao profile B, a execução é um routed fire.
Reutilizar um processo é razoável — economiza memória e evita um daemon de longa duração a mais. A pré-condição é que o job de B receba a visão de chaves de B durante toda a execução, e perca essa visão no instante em que a execução termina. O Hermes chama essa visão temporária de secret scope.
Quando o isolamento desapareceu
Em 2026-09-15 a correção do #111187 chegou à main (commit cedf4a3d78), dando aos routed fires isolamento total de escopo.
Poucas horas depois, o commit 23036e20a6 — intitulado “fix(ux): plain-language, actionable user-facing messages (core)” — mexeu em 234 arquivos e apagou o mecanismo inteiro junto com os seus testes. A mensagem do commit não diz nada sobre a remoção.
A parte perigosa não são as funções que faltam. É o quão silenciosamente as guardas falham. Existiam quatro delas:
- a guarda routed-dotenv, que mantinha o
.envde B fora do ambiente compartilhado do processo; - a falha fail-closed do
get_secret, que dá erro em vez de cair para o valor de outra pessoa; - a limpeza do subprocesso, para que um processo filho nunca herde as variáveis do profile de lançamento;
- a remoção dos resíduos de lançamento, que tirava as sobras do profile anterior.
Todas elas dependem da pergunta “estamos sob semântica multiplex agora?”. O backend do desktop e um gateway standalone fazem o tick de cada profile com essa flag desligada — então as quatro viraram no-ops. Sem erro, sem aviso, nada com cara de errado.
O que de fato vazou
Duas coisas, e vale checar as duas na sua própria máquina.
Primeiro, o .env do profile B ficou no ambiente do processo. Nada limpou essas variáveis depois que o job terminou, então todo turno posterior do profile de lançamento — e todo processo filho que ele gerou — podia ler as chaves de B. O raio de impacto é maior que o de uma única execução agendada.
Segundo, a camada gerenciada do .env sumiu. O build_profile_secret_scope empilha valores em ordem, com a camada gerenciada (credenciais que um administrador ou um time distribui) aplicada por último e vencendo. Sem essa camada:
- se você também definir a mesma chave por conta própria, agora o seu valor bate o gerenciado;
- se só a camada gerenciada definia a chave, ela simplesmente não existe para aquele profile.
O segundo caso é o traiçoeiro: sem erro, sem exceção, só uma ferramenta que de repente afirma não ter credencial nenhuma.
A correção: quatro guardas restauradas, agora com testes protegendo elas
O PR #126982 restaura a correção anterior sobre a main atual, preservando a autoria original, e devolve a camada gerenciada do .env. Concretamente:
| Onde | O que mudou |
|---|---|
agent/secret_scope.py |
Adiciona set_multiplex_context(), uma flag local de contexto combinada com OR em is_multiplex_active(); build_profile_secret_scope restabelece o .env gerenciado como última camada |
cron/scheduler_provider.py |
_profile_cron_scope marca um fire cujo home não é o home fixado de lançamento — routed_profile_fire |
cron/scheduler.py |
_install_fire_secret_scope / _reset_fire_secret_scope hidratam e instalam o escopo; um routed fire recebe também o contexto multiplex, exatamente por esse intervalo |
tools/environments/local.py |
strip_launch_profile_env tira mais resíduo de lançamento sem tocar nas chaves gerenciadas; adiciona restore_managed_env; build_subprocess_env(strip_launch_profile=True) sobrepõe o escopo roteado, depois as chaves gerenciadas |
A verificação segue o padrão red-then-green: jogue os seis testes restaurados sobre a main anterior à correção (b9df1cccae) e todos falham; com a correção no lugar, 205 arquivos relacionados e 1.920 testes passam com zero falhas.
A checagem de roteamento lê o endpoint que a chamada realmente usou, em vez do estado do profile — então uma chave de pool paga ao lado de um profile convidado não é lida por engano como o tier gratuito.
O que você deveria fazer
- Cheque se a sua build tem isso. A correção foi mesclada na
mainem 2026-09-30, enquanto a tag mais nova, v0.21.5, é de 9-24 — ou seja, as tags ainda não a têm. Instalações via git que seguem amainjá estão corrigidas. - Não empilhe toda chave no
.envglobal. Dê um próprio a cada profile: nomes no estilohermes config set OPENROUTER_API_KEY ...gravam no.envdo profile atual, o mesmo arquivo que os fluxos de setup de plataforma e o/sethomeusam. - Um deployment que faz o tick de todo profile num mesmo processo é a janela de exposição. Backends desktop e gateways standalone estão nessa classe. Se você roda um gateway por host com profiles de fato independentes, a superfície é bem menor.
- Rode o check-up somente leitura. O hermes cron doctor lista execuções que falharam, entregas que falharam, valores de
next_run_atatrasados e scripts ou workdirs ausentes, saindo com código diferente de zero quando encontra problemas. Ele não vai te dizer “suas chaves atravessaram”, mas vai dizer quais jobs nunca de fato tiveram sucesso. Referência de comando: hermes cron. - Confirme que credenciais gerenciadas ainda vencem. Se o seu time distribui credenciais de forma centralizada, verifique se o valor que o profile lê é o que você espera. Para saber como essas credenciais são armazenadas e criptografadas, veja o guia de criptografia de secrets no keychain.
- Vale revisar as suas fronteiras entre múltiplos profiles como um todo. Se vários profiles rodam jobs para você, dar a cada profile o seu próprio bot mantém o tráfego do cron em canais por profile e encolhe a superfície de conversa cruzada dentro de um processo compartilhado.
A conclusão
A forma deste incidente é familiar: a lógica de isolamento nunca esteve errada, ela foi apagada de lado por um commit de UX sem relação que não disse nada a respeito. O que vale lembrar é que duas camadas de defesa estavam ausentes ao mesmo tempo — nenhum teste guardava o código, e nenhuma checagem em runtime reclamou quando o isolamento sumiu.
Para os usuários a conclusão é simples: profiles que não compartilham secrets são uma promessa, e promessas merecem verificação. Dê a cada profile o seu próprio .env, deixe o ambiente global enxuto e aponte periodicamente hermes cron doctor para a sua agenda para ver se o background está realmente rodando como você imagina.