La clé API de quelqu'un d'autre a tourné dans votre cron job
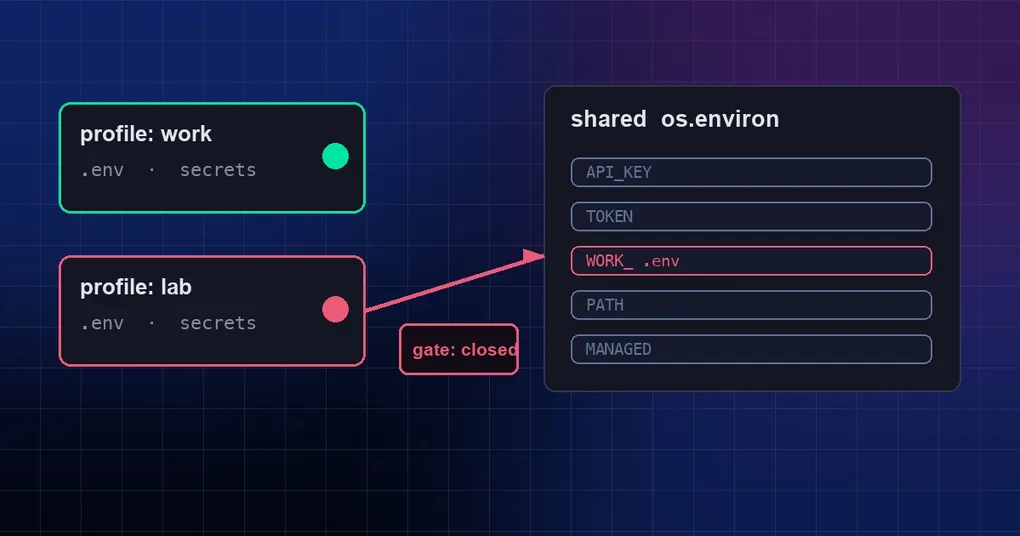
Vous gardez la clé API de votre entreprise dans le profile work et vos propres expérimentations dans lab. Ces deux profiles n’ont rien à voir l’un avec l’autre — c’est toute la promesse des profiles. Puis un matin vous lisez un log de cron et le job lab détient la clé de work. Vous n’avez rien mal configuré : la couche d’isolation a été supprimée en bloc par un commit qui n’a jamais mentionné y toucher.
Cet article couvre trois choses : ce qu’est réellement un « routed fire », comment les clés ont traversé la frontière, et quoi vérifier sur votre propre machine.
Commençons par le début : qu’est-ce qu’un routed fire
Hermes cron ne fait pas tourner un processus par profile. Un seul ticker vit dans le processus qui le possède et parcourt les jobs dus de chaque profile. Quand ce processus appartient au profile A mais que le job appartient au profile B, l’exécution est un routed fire.
Réutiliser un seul processus est raisonnable — cela économise de la mémoire et un démon longue durée. La condition préalable est que le job de B obtienne la vue des clés de B pendant toute la durée de l’exécution, et la perde dès que l’exécution se termine. Hermes appelle cette vue temporaire un secret scope.
Quand l’isolation a disparu
Le 2026-09-15, le correctif de #111187 a atterri sur main (commit cedf4a3d78), donnant aux routed fires une isolation complète du scope.
Quelques heures plus tard, le commit 23036e20a6 — intitulé « fix(ux): plain-language, actionable user-facing messages (core) » — a touché 234 fichiers et supprimé tout le mécanisme ainsi que ses tests. Le message de commit ne dit rien sur cette suppression.
La partie dangereuse n’est pas les fonctions manquantes. C’est la discrétion avec laquelle les garde-fous échouent. Il en existait quatre :
- le garde-fou routed-dotenv, qui tenait le
.envde B hors de l’environnement partagé du processus ; - l’échec fail-closed de
get_secret, qui renvoie une erreur au lieu de retomber sur la valeur de quelqu’un d’autre ; - la purge des sous-processus, pour qu’un enfant lancé n’hérite jamais des variables du launch profile ;
- le nettoyage des résidus de lancement, qui retirait les restes du profile précédent.
Chacun d’eux repose sur la question « sommes-nous sous sémantique multiplex en ce moment ? » Le backend desktop et un gateway autonome tickent chaque profile avec ce flag désactivé — les quatre sont donc devenus des no-ops. Aucune erreur, aucun avertissement, rien qui ait l’air anormal.
Ce qui a réellement fuité
Deux choses, et les deux méritent d’être vérifiées sur votre propre machine.
Premièrement, le .env du profile B est resté dans l’environnement du processus. Rien n’a nettoyé ces variables après la fin du job, si bien que chaque tour ultérieur du launch profile — et chaque processus enfant qu’il lançait — pouvait lire les clés de B. Le rayon d’impact est plus large que la seule exécution planifiée.
Deuxièmement, la couche .env managée a disparu. build_profile_secret_scope empile les valeurs dans l’ordre, la couche managée (les identifiants qu’un administrateur ou une équipe distribue) étant appliquée en dernier et l’emportant. Sans cette couche :
- si vous définissez aussi la même clé vous-même, votre valeur bat désormais celle de la couche managée ;
- si seule la couche managée la définissait, la clé n’existe simplement plus pour ce profile.
Le second cas est le plus sournois : aucune erreur, aucune exception, juste un outil qui prétend soudain ne pas avoir d’identifiants.
Le correctif : quatre garde-fous restaurés, cette fois avec des tests pour les protéger
La PR #126982 restaure le correctif précédent sur le main actuel en préservant l’authorship d’origine, et remet le .env managé en place. Concrètement :
| Où | Ce qui a changé |
|---|---|
agent/secret_scope.py |
Ajoute set_multiplex_context(), un flag local au contexte OR’é dans is_multiplex_active() ; build_profile_secret_scope rétablit le .env managé comme dernière couche |
cron/scheduler_provider.py |
_profile_cron_scope marque une exécution dont le home n’est pas le launch home épinglé — routed_profile_fire |
cron/scheduler.py |
_install_fire_secret_scope / _reset_fire_secret_scope hydratent et installent le scope ; un routed fire reçoit en plus le contexte multiplex, pour exactement cet intervalle |
tools/environments/local.py |
strip_launch_profile_env retire davantage de résidus de lancement sans toucher aux clés managées ; ajoute restore_managed_env ; build_subprocess_env(strip_launch_profile=True) superpose le scope routé, puis les clés managées |
La vérification suit le schéma red-then-green : déposez les six tests restaurés sur le main d’avant le correctif (b9df1cccae) et ils échouent tous ; avec le correctif en place, 205 fichiers liés et 1 920 tests passent sans aucun échec.
Le contrôle de routage lit l’endpoint que l’appel a réellement utilisé plutôt que l’état du profile — ainsi une clé de pool payante à côté d’un profile invité n’est pas confondue avec le tier gratuit.
Ce que vous devriez faire
- Vérifiez si votre build l’a. Le correctif a été fusionné dans
mainle 2026-09-30, alors que le tag le plus récent, v0.21.5, date du 9-24 — les tags ne l’ont donc pas encore. Les installations git qui suiventmainsont déjà corrigées. - Ne mettez pas toutes vos clés dans le
.envglobal. Donnez à chaque profile le sien : les noms du stylehermes config set OPENROUTER_API_KEY ...écrivent dans le.envdu profile courant, le même fichier que les flux de configuration de plateforme et/sethomeutilisent. - Un déploiement qui ticke chaque profile dans un seul processus, voilà la fenêtre d’exposition. Les backends desktop et les gateways autonomes sont dans cette catégorie. Si vous faites tourner un gateway par hôte avec des profiles réellement indépendants, la surface est bien plus réduite.
- Lancez le check-up en lecture seule. hermes cron doctor liste les exécutions en échec, les livraisons en échec, les valeurs
next_run_aten retard et les scripts ou workdirs manquants, en sortant avec un code non nul quand il trouve des problèmes. Il ne vous dira pas « vos clés ont traversé la frontière », mais il vous dira quels jobs n’ont jamais réellement abouti. Référence de commande : hermes cron. - Confirmez que les identifiants managés l’emportent toujours. Si votre équipe distribue les identifiants de façon centralisée, vérifiez que la valeur que lit le profile est bien celle que vous attendez. Pour la façon dont ces identifiants sont stockés et chiffrés, voir le guide de chiffrement des secrets du keychain.
- Cela vaut la peine de revoir vos frontières multi-profils dans leur ensemble. Si plusieurs profiles font tourner des jobs pour vous, donner à chaque profile son propre bot garde le trafic cron sur des canaux par profile et réduit la surface de cross-talk au sein d’un processus partagé.
À retenir
La forme de cet incident est familière : la logique d’isolation n’a jamais été fausse, elle a été supprimée en passant par un commit UX sans rapport qui n’en disait rien. Ce qu’il faut retenir, c’est que deux couches de défense étaient absentes en même temps — aucun test ne protégeait le code, et aucune assertion runtime ne se plaignait quand l’isolation a disparu.
Pour les utilisateurs, la conclusion est simple : des profiles qui ne partagent pas de secrets, c’est une promesse, et les promesses méritent vérification. Donnez à chaque profile son propre .env, laissez l’environnement global mince, et pointez régulièrement hermes cron doctor sur votre planning pour voir si l’arrière-plan tourne vraiment comme vous le pensez.