La clave de API de otra persona se ejecutó dentro de tu cron job
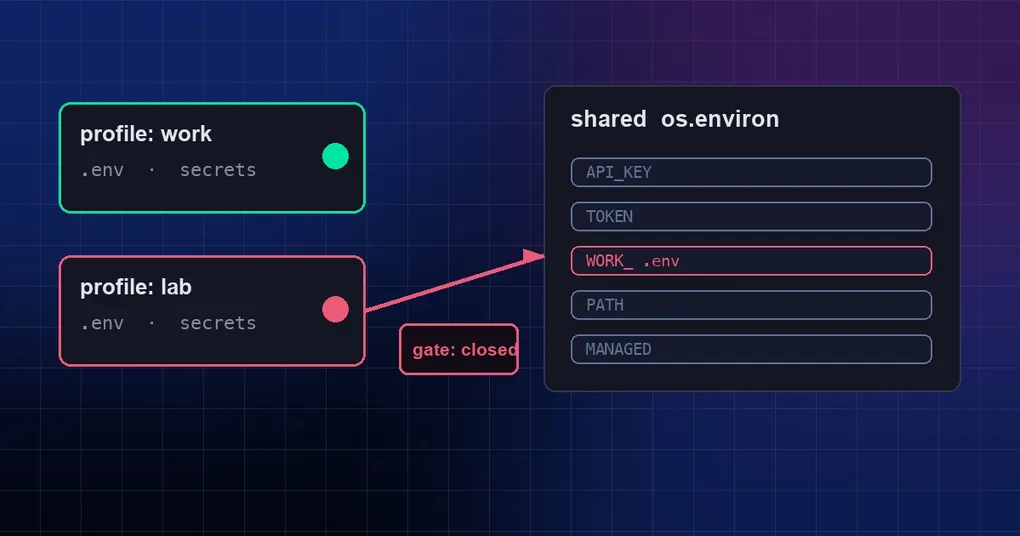
Guardas la clave de API de tu empresa en el perfil work y tus experimentos en el perfil lab. Los dos perfiles no tienen nada que ver entre sí: esa es precisamente la promesa de los perfiles. Y una mañana lees un log de cron y el job de lab tiene la clave de work. No has configurado nada mal: la capa de aislamiento la borró por completo un commit que nunca mencionó que la estaba tocando.
Este artículo cubre tres cosas: qué es exactamente un «routed fire», cómo se cruzaron las claves y qué deberías comprobar en tu propia máquina.
Empecemos por el principio: qué es un routed fire
Hermes cron no ejecuta un proceso por perfil. Hay un único ticker que vive en el proceso que lo posee y va recorriendo los jobs vencidos de todos los perfiles. Cuando ese proceso pertenece al perfil A pero el job pertenece al perfil B, esa ejecución es un routed fire.
Reutilizar un solo proceso tiene sentido: ahorra memoria y un daemon de larga duración. La condición previa es que el job de B reciba la vista de claves de B mientras dura la ejecución, y que la pierda en el momento en que esta termina. Hermes llama a esa vista temporal secret scope.
Cuándo desapareció el aislamiento
El 2026-09-15 aterrizó en main el arreglo del #111187 (commit cedf4a3d78), que daba a los routed fires aislamiento de alcance completo.
Unas horas después, el commit 23036e20a6 —titulado «fix(ux): plain-language, actionable user-facing messages (core)»— tocó 234 archivos y borró todo el mecanismo junto con sus tests. El mensaje del commit no dice nada de esa eliminación.
Lo peligroso no son las funciones que faltan. Lo peligroso es lo silenciosamente que fallan las defensas. Había cuatro:
- la defensa del dotenv enrutado, que mantenía el
.envde B fuera del entorno del proceso compartido; - el fallo cerrado de
get_secret, que da error en lugar de recurrir al valor de otro perfil; - el scrub del subproceso, para que un hijo lanzado nunca herede las variables del perfil de lanzamiento;
- la limpieza de residuos de lanzamiento, que eliminaba los restos del perfil anterior.
Las cuatro dependen de la pregunta «¿estamos bajo semántica de multiplexación ahora mismo?». El backend de escritorio y un gateway independiente recorren cada perfil con ese flag desactivado, así que todas se convirtieron en no-ops. Sin error, sin aviso, nada que parezca raro.
Qué se filtró de verdad
Dos cosas, y las dos merecen una comprobación en tu propia máquina.
Primero, el .env del perfil B se quedó en el entorno del proceso. Nada limpió esas variables al terminar el job, así que cada turno posterior del perfil de lanzamiento —y cada proceso hijo que lanzara— podía leer las claves de B. El radio de impacto es más amplio que la única ejecución programada.
Segundo, faltaba la capa de .env gestionado. build_profile_secret_scope aplica los valores por capas, y la capa gestionada (las credenciales que distribuye un administrador o un equipo) se aplica la última y gana. Sin esa capa:
- si tú también defines la misma clave, tu valor ahora se impone al gestionado;
- si solo la capa gestionada la definía, la clave simplemente no existe para ese perfil.
El segundo caso es el traicionero: ningún error, ninguna excepción, solo una herramienta que de pronto dice no tener credenciales.
La solución: cuatro defensas restauradas, esta vez con tests que las protegen
El PR #126982 restaura el arreglo anterior sobre el main actual conservando la autoría original y devuelve el .env gestionado. En concreto:
| Dónde | Qué cambió |
|---|---|
agent/secret_scope.py |
Añade set_multiplex_context(), un flag local al contexto que se combina con OR en is_multiplex_active(); build_profile_secret_scope reincorpora el .env gestionado como última capa |
cron/scheduler_provider.py |
_profile_cron_scope marca una ejecución cuyo home no es el home de lanzamiento fijado — routed_profile_fire |
cron/scheduler.py |
_install_fire_secret_scope / _reset_fire_secret_scope hidratan e instalan el alcance; un routed fire recibe además el contexto de multiplexación, exactamente durante ese intervalo |
tools/environments/local.py |
strip_launch_profile_env elimina más residuos de lanzamiento sin tocar las claves gestionadas; añade restore_managed_env; build_subprocess_env(strip_launch_profile=True) superpone el alcance enrutado y luego las claves gestionadas |
La verificación sigue el patrón rojo-y-luego-verde: si dejas los seis tests restaurados sobre el main previo al arreglo (b9df1cccae), todos fallan; con el arreglo aplicado, 205 archivos relacionados y 1.920 tests pasan sin un solo fallo.
La comprobación de enrutado lee el endpoint que la llamada realmente usó en lugar del estado del perfil, así que una clave de pool de pago que convive con un perfil invitado no se confunde con el nivel gratuito.
Qué deberías hacer
- Comprueba si tu build lo incluye. El arreglo se fusionó en
mainel 2026-09-30, mientras que el tag más reciente, v0.21.5, es del 9-24, así que los tags todavía no lo tienen. Las instalaciones por git que siguenmainya están corregidas. - No amontones todas las claves en el
.envglobal. Dale uno propio a cada perfil: los nombres tipohermes config set OPENROUTER_API_KEY ...escriben en el.envdel perfil actual, el mismo archivo que usan los flujos de configuración de la plataforma y/sethome. - Un despliegue que recorre todos los perfiles en un solo proceso es la ventana de exposición. Los backends de escritorio y los gateways independientes están en esa categoría. Si ejecutas un gateway por host con perfiles realmente independientes, la superficie es mucho menor.
- Ejecuta el chequeo de solo lectura. hermes cron doctor lista ejecuciones fallidas, entregas fallidas, valores de
next_run_atvencidos y scripts o directorios de trabajo ausentes, y sale con código distinto de cero cuando encuentra problemas. No te dirá «tus claves se cruzaron», pero sí qué jobs nunca llegaron a completarse. Referencia del comando: hermes cron. - Confirma que las credenciales gestionadas siguen ganando. Si tu equipo distribuye credenciales de forma centralizada, comprueba que el valor que lee el perfil es el que esperas. Para saber cómo se almacenan y cifran esas credenciales, consulta la guía de cifrado de secretos del keychain.
- Merece la pena revisar tus fronteras entre perfiles en conjunto. Si varios perfiles ejecutan jobs para ti, darle a cada perfil su propio bot mantiene el tráfico de cron en canales por perfil y reduce la superficie de cruce dentro de un proceso compartido.
La conclusión
La forma de este incidente resulta familiar: la lógica de aislamiento nunca estuvo mal, la borró de refilón un commit de UX sin relación que no decía nada al respecto. Lo que conviene recordar es que faltaban dos capas de defensa a la vez: ningún test protegía el código y ninguna aserción en tiempo de ejecución se quejó cuando el aislamiento desapareció.
Para los usuarios la conclusión es sencilla: que los perfiles no compartan secretos es una promesa, y las promesas merecen verificación. Dale a cada perfil su propio .env, deja el entorno global delgado y apunta hermes cron doctor a tu planificación de vez en cuando para ver si el fondo está funcionando de verdad como crees.