1,393 个子代理、19 小时、一台 i7:官方是怎么让 agent 重构掉百万行代码的
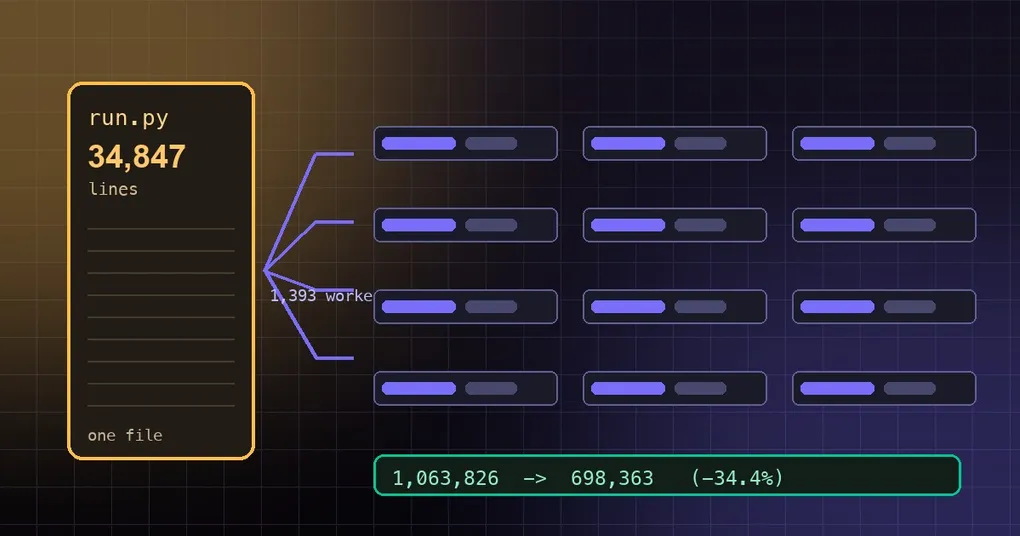
每个维护过几年以上的仓库里,都躺着几个你不敢碰的文件:一个 run.py 三万四千行、一个函数七百行、一串 if/elif 深到 92 层。你清楚该拆,但它排不进排期——拆它不产出任何新功能,却可能引入回归,而团队的时间全花在给用户发货上。Nous Research 面对的正是这个处境,他们的选择是:让 agent 自己干。2026 年 9 月 2 日,一个 /goal 跑了 19 个小时,调度了 1,393 个子代理,产出 PR #102117,把非测试源码减少了 34.4%。官方随后把自己的运行数据、成本账、以及“规模化时会崩掉的九个环节”全部公开,这份复盘对任何想在自己仓库里复刻一次的人都很有用。
先看结果:一周内落地的数字
| 指标 | 重构前 | 重构后 |
|---|---|---|
| 非测试源码行数(所有目录) | 1,063,826 | 698,363(−34.4%) |
| 5,000 行以上的文件 | 37 | 6 |
| 300 行以上的函数 | 192 | 2 |
最长的 if/elif 链 |
92 个分支 | 9 |
gateway/run.py |
34,847 行 | 5,512 行 |
| 最差函数圈复杂度 | 1,075 | 84 |
最终差异是 4,271 个提交、2,655 个文件、+436,199 / −784,430,每个验证过的步骤提交一次。主运行约 19 小时,用了 93,284 次调用、约 19,300 美元;加上后续会话约 2.5 万美元。官方估算人工做同样的事成本 15 万到 180 万美元——也就是说这活儿本来根本排不上。
官方也很坦率地列出了反向指标:模块数从 1,152 涨到 1,551,import 依赖边从 5,245 涨到 7,135;拆分后的入口导入变慢了一点(run_agent 270 → 292 毫秒,gateway.run 154 → 196 毫秒)。拆分换来的是可读性,不是免费的。
为什么“让 agent 读代码”本身值得优化
这次重构最值得学的一点是:他们把“agent 读懂这个仓库要花多少 token”当作可测量的指标,而不是修辞。为此他们提交了四套测量脚本(evals/codebase_navigability/ 下的 bench.py、lookup_sim.py、static_metrics.py、runtime_bench.py,带 README),任何人都能复现:
| 每次“给我看这个符号” | 重构前 | 重构后 |
|---|---|---|
| 需要一个文件在 128k 上下文里装不下 | 1,589 次查询 | 0 次 |
| 该文件 token 数(中位数) | 30,762 | 10,333(−66%) |
| 该文件 token 数(最大值) | 330,028 | 85,075(−74%) |
| 一次查找实际返回的 token(均值) | 2,218 | 993(−55%) |
用人话说就是:重构前,测试套件会去 import 的符号里有 1,589 个住在一个任何 128k 上下文的模型都装不下的文件里。这不是“代码风格问题”,这是 agent 的物理限制。他们特别指出,均值之所以腰斩,是因为长尾塌了——个别定义从 38,691 token 降到 2,348;而中位数反而微涨(564 → 680),因为注释被压缩后每一行的平均 token 变多了。长尾才是烧上下文的地方。
它是怎么被组织的
- 一个
/goal给出标准,而不是逐条吩咐。原始指令大意是:“我要一次大规模的简化,行数至少降 30%,拆开上帝文件,统一可复用的 helper,少一点 if-if-if 路由,可读性上升,优雅,臃肿代码清掉,全部做完,收集成 PR 给我。“注意最后那两句:“不要等我决策”。 - 编排者先测量、再切分。主代理把代码库分成 36 个互不重叠的区域,自己写任务书,作者不用逐个交代。
- 一个 worktree 一个 worker。worker 在各自的 git worktree 里改,互不覆盖;任务书写明要简化哪些代码、要保住哪些接口、提交前必须过哪些检查。
- 接口比对是硬约束:工具的 JSON schema 必须逐字节一致,CLI 的
--help输出也可以逐字节比对;每个验证过的步骤必须提交。 - 规模:一个 Python 进程编排,跑在一台 i7 + 64GB 内存的台式机上,最高 218 个 agent 同时在跑(平均约 110),推理在远端。全程 478 个委派批次、1,652 个子任务、111,352 次工具调用(terminal 70,046、read_file 14,223、execute_code 9,224、write_file 8,631、patch 5,042、嵌套委派 1,328),中位任务 39 分钟,p90 3.2 小时。
规模化时会崩的九个环节(最实用的一段)
跑完之后的取证审计(追踪 issue #103563)修掉了九类问题——这些才是你复刻时真正会撞到的墙:
| 现象 | 实测数字 | 修复后 |
|---|---|---|
| 认证踩踏:大量 agent 同时刷新令牌 | 单个窗口 620 次 401,父进程死亡、329 个子代理被杀、74 个被重新派发(约 3,900 美元) | 40 个同时过期的 agent:40 次 401 → 0 |
| 子代理死了没人知道 | 66 分钟才发现一整波失效 | 0.3 秒上报 |
| 子代理摘要被砍成桩 | 121 份里 114 份只剩 2K 字符(只有结论、没有过程) | 完整摘要 |
| 嵌套委派超时 | 332 次超时;约 1,400 次嵌套调用里只有 89 次真的返回 | 各层级都豁免截止时间 |
| 缓存档位选错 | 子代理按 1 小时档计费($20/M),而一个 20 分钟的 worker 根本用不到 | 改用 5 分钟档($12.51/M,同一循环实测) |
| 工具磨擦 | 546 次误判硬拦截、454 次超时拒答、661 次整文件重写(约 155 美元) | 三类都消失 |
| 静默丢失公开 API | PR 打开时 1,703 个公开名字和 126 个测试被悄悄删掉,人工评审只找到约 30 个 | 机械检查 18 秒内抓出,进 CI |
| 目标循环停摆 | 在一个孙任务的轮询器上停了 3 小时 22 分,4/5 次催促白费 | 只看自己的进程、30 分钟上限、空闲钩子恢复 |
| 语言服务器泛滥 | 约 30 个 Pyright 实例吃掉 8.7 GB | worktree 共用一个,并校验诊断仍然到位 |
关于那张成本表要读得仔细:官方明确说明这是单次写入的价格对比,不是一个整体节省的金额——他们在追踪 issue 里反复强调四个数字不能混在一起:历史上花了多少、观察到了什么故障、模拟说修完会差多少、以及实际改了多少。这种克制值得学习。
真正的风险在评审环节
自动化跑得再顺,最后仍然要靠人拦下回归。两轮社区评审抓到了两类真实问题:
- 被删掉的公开名字:worker 认为“仓库内没有调用者”就删了,但外部插件会 import 它们。
- 一次自动重写
suppress()改了约 65 处异常处理,现有测试完全没覆盖到。
对应的兼容策略也很具体:2,091 个被移动的名字通过一个 PLUGIN-COMPAT 指针继续可从旧模块导入,并且逐一用对象身份校验指向了新的归属;同时仓库内任何代码都不许用这些指针(AST 检查在 CI 里把关)。这套指针是临时的,2026 年 9 月 14 日已整体撤除。今天你可以用 hermes plugins compat 扫描受影响的插件,逃生口是 plugins.allow_deprecated_imports: true。
验证规模也值得一提:全量套件 44,859 通过 / 51 失败,而那 17 个失败文件在裸 main 上是同样 51 个失败(文件集合与每文件计数都一致)。归因于这次重构的回归:0 个。这个“冻结基线 + 逐项对照”的做法,也是他们日常 skill 里就写着的一条:先在干净环境里复现失败,判断它是不是本来就坏的。
如果你想在自己的仓库里来一次
- 把目标写成可判定的验收条件:行数降幅、要拆哪些文件、哪些接口逐字节不许变。
- 先测量再动手:他们的四套测量脚本已经提交进仓库,可以直接借鉴思路。
- 一个 worktree 一个 worker,每个验证过的步骤提交一次——这是“跑挂之后还能续”的前提。
- 为中断做好准备:他们的主运行跑到约 50 分钟时,供应商的认证令牌过期,整轮直接死掉;因为提交和任务书都活着,才用另一个会话诊断、写好交接、续跑成功。
- 把评审预算算进去:合并后的修复提交里,有 16 个属于“静默丢公开 API”这一类。
- 接受代价:模块数和导入时间会变差;六个文件仍在 5,000 行以上,官方把它们列为下一轮目标。
来源与口径
本文数字全部来自官方公开材料:Nous Research 官方文章(2026 年 9 月 17 日发布)、PR #102117(2026 年 9 月 4 日合并)、以及后续的取证追踪 issue #103563。这些是官方自己的运行数据与估算(例如成本区间、人工对照估算),不是我们在本机实测的结果——照例说明口径,读者可以自行核对链接。
想看同一套能力的其他侧面,子代理的实时编排讲的是怎么看着这些并行 agent 干活,心跳与目标门禁解释 /goal 这类长任务为什么需要心跳与验收,插件目录则关系到上面那段“外部插件兼容”的现实约束;如果你的团队是多个人各自的 agent 在同一个仓库里改代码,合并冲突的中立仲裁是自然的下一步。
小结
- 一个
/goal、19 小时、1,393 个子代理(峰值 218 并发):非测试源码 1,063,826 → 698,363 行(−34.4%),gateway/run.py从 34,847 行降到 5,512 行,300 行以上的函数从 192 个降到 2 个。 - 成本约 1.93 万美元(含后续约 2.5 万),官方估算人工需 15 万–180 万美元;代价是模块数与导入时间上升。
- 他们把“agent 读代码要多少 token”做成了可复现的指标:128k 上下文装不下的查询从 1,589 次降到 0 次。
- 规模化真正的坑在编排层:认证踩踏(620 次 401 → 0)、死子代理 66 分钟才被发现(→ 0.3 秒)、摘要被砍成桩(114/121)、缓存档位选错、静默丢公开 API(1,703 个名字,机械检查 18 秒抓出)。