1.393 Subagents, 19 Stunden, ein Desktop: Wie Nous mit Hermes eine Million Zeilen refaktorierte
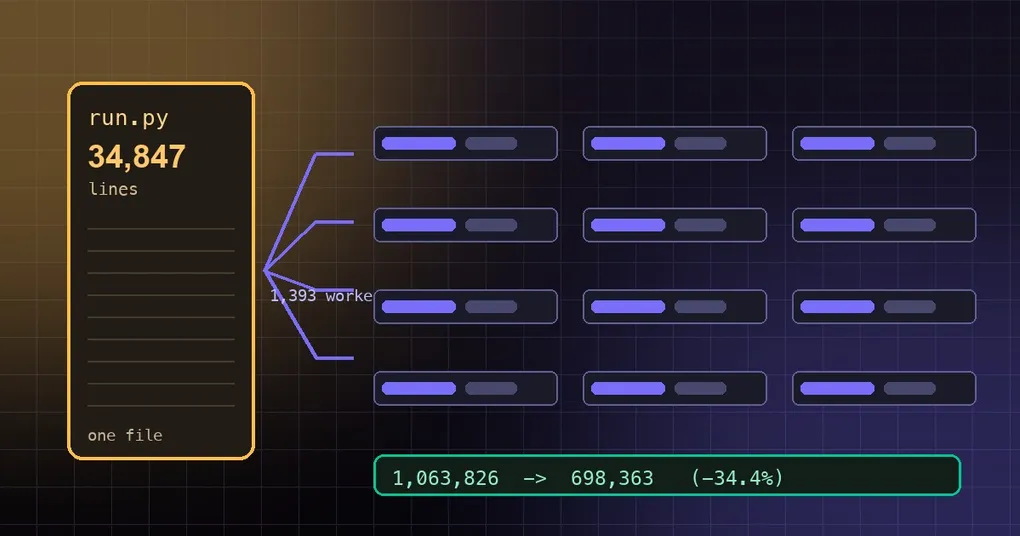
Jedes Repository, das ein paar Jahre gepflegt wurde, hat eine Handvoll Dateien, die niemand mehr aufzumachen wagt: ein run.py mit 34.000 Zeilen, eine einzelne Funktion mit 700 Zeilen, eine if/elif-Leiter mit 92 Verzweigungen. Du weißt, dass man das aufteilen müsste, aber es schafft es nie in den Sprint — es liefert keine Features und riskiert Regressionen, während die Stunden des Teams zu den Nutzern fließen. Genau in dieser Lage war Nous Research, und ihre Antwort war, den Agenten die Arbeit machen zu lassen. Am 2. September 2026 lief ein einzelnes /goal 19 Stunden, verteilte 1.393 Subagents und brachte PR #102117 hervor, der 34,4 % des Nicht-Test-Quellcodes entfernte. Danach haben sie ihre eigene Telemetrie, die Kostenrechnung und die neun Dinge veröffentlicht, die bei dieser Größenordnung brechen — was das Ganze zu einer nützlichen Postmortem für alle macht, die denselben Schritt erwägen.
Zuerst das Ergebnis
| Metrik | Vorher | Nachher |
|---|---|---|
| Nicht-Test-Quellzeilen (alle Verzeichnisse) | 1.063.826 | 698.363 (−34,4 %) |
| Dateien mit über 5.000 Zeilen | 37 | 6 |
| Funktionen mit über 300 Zeilen | 192 | 2 |
Längste if/elif-Kette |
92 Verzweigungen | 9 |
gateway/run.py |
34.847 Zeilen | 5.512 Zeilen |
| Schlechteste zyklomatische Komplexität | 1.075 | 84 |
Der finale Diff umfasste 4.271 Commits über 2.655 Dateien (+436.199 / −784.430), ein Commit pro verifiziertem Schritt. Der Hauptlauf dauerte rund 19 Stunden und 93.284 Aufrufe und kostete etwa 19.300 US-Dollar, mit den Folgesitzungen rund 25.000 US-Dollar. Ihre Schätzung für eine Umsetzung von Hand lag bei 150.000 bis 1,8 Mio. US-Dollar — und genau deshalb wurde sie nie eingeplant.
Sie haben auch die Gegenmetriken veröffentlicht. Die Modulanzahl stieg von 1.152 auf 1.551 und die Import-Kanten von 5.245 auf 7.135; die aufgeteilten Einstiegspunkte importieren etwas langsamer (run_agent 270 auf 292 ms, gateway.run 154 auf 196 ms). Die Aufteilung brachte Lesbarkeit, und sie war nicht kostenlos.
Warum es sich lohnt zu messen, was einem Agenten das Lesen des Codes kostet
Die übertragbarste Idee hier ist, dass sie wie viele Tokens ein Agent ausgeben muss, um das Repo zu verstehen als messbare Metrik behandelt haben statt als Slogan. Sie haben vier Harnesses committet (bench.py, lookup_sim.py, static_metrics.py, runtime_bench.py unter evals/codebase_navigability/, mit einer README), sodass jeder sie reproduzieren kann:
| Pro Aufgabe vom Typ „zeig mir dieses Symbol“ | Vorher | Nachher |
|---|---|---|
| Lookups, deren Datei nicht in einen 128k-Kontext passt | 1.589 | 0 |
| Tokens der Definitionsdatei (Median) | 30.762 | 10.333 (−66 %) |
| Tokens der Definitionsdatei (Max) | 330.028 | 85.075 (−74 %) |
| Tatsächlich pro Lookup zurückgegebene Tokens (Mittelwert) | 2.218 | 993 (−55 %) |
In einfachen Worten: Vor dem Refactoring lagen 1.589 der Symbole, die die Testsuite importiert, in einer Datei, die kein Modell mit 128k-Kontext überhaupt laden kann. Das ist kein Stilproblem, sondern eine harte Fähigkeitsgrenze. Der Mittelwert halbierte sich, weil der Ausläufer wegbrach — einzelne Definitionen fielen von 38.691 Tokens auf 2.348 —, während der Median leicht stieg (564 auf 680), weil das Entfernen von Kommentaren jede verbleibende Zeile token-dichter macht. Der lange Ausläufer war der Ort, an dem Kontext verbrannt wurde.
Wie es organisiert wurde
- Ein
/goalsetzte den Standard, statt Anweisungen zu geben. Der ursprüngliche Prompt lautete im Kern: eine massive Vereinfachung, mindestens 30 % weniger Zeilen, God-Files aufgeteilt, Helfer vereinheitlicht, weniger if-if-if-Routing, Lesbarkeit und Eleganz hoch, Ballast raus, alles erledigt, als PR geliefert — und, entscheidend, „nicht auf meine Entscheidungen warten“. - Der Orchestrator hat erst gemessen, dann geteilt. Er zerlegte die Codebasis in 36 überlappungsfreie Gruppen und schrieb die Zuweisungen selbst, sodass der Autor nie einen Worker einzeln einweisen musste.
- Ein Git-Worktree pro Worker. Die Worker bearbeiteten getrennte Checkouts, damit sie sich nicht gegenseitig überschreiben konnten; jedes Briefing nannte den zu vereinfachenden Code, die zu erhaltenden Interfaces und die vor dem Commit nötigen Prüfungen.
- Interface-Parität war eine harte Vorgabe. Das JSON-Schema eines Tools musste byte-identisch bleiben, und die
--help-Ausgabe einer CLI ließ sich Byte für Byte vergleichen. Jeder verifizierte Schritt musste committet werden. - Der Umfang des Ganzen. Die Orchestrierung lief als einzelner Python-Prozess auf einem i7-Desktop mit 64 GB RAM und erreichte 218 gleichzeitige Agenten in der Spitze (im Schnitt etwa 110), wobei die Inferenz remote lief. Über den gesamten Lauf: 478 Delegations-Batches, 1.652 Subagent-Aufgaben, 111.352 Tool-Aufrufe (70.046 Terminal, 14.223 read_file, 9.224 execute_code, 8.631 write_file, 5.042 patch, 1.328 verschachtelte Delegationen), eine mediane Aufgabe von 39 Minuten und ein p90 von 3,2 Stunden.
Die neun Dinge, die bei dieser Größenordnung brechen
Das forensische Audit, das folgte (Tracking-Issue #103563), behob neun Problemklassen. Das sind die Wände, gegen die du tatsächlich laufen wirst:
| Symptom | Gemessen | Nach dem Fix |
|---|---|---|
| Auth-Stampede — viele Agenten erneuern gleichzeitig Tokens | 620 × 401 in einem Fenster; das Parent starb, 329 Kinder verwaisten, 74 wurden neu verteilt (rund 3.900 US-Dollar) | 40 ablaufende Agenten: 40 × 401 → 0 |
| Tote Subagents, die niemand bemerkt | eine ganze tote Welle blieb 66 Minuten unbemerkt | in 0,3 Sekunden sichtbar |
| Kind-Zusammenfassungen zu Stubs gekürzt | 114 von 121 auf 2K Zeichen gekürzt — Schlussfolgerungen ohne Prozess | vollständige Zusammenfassungen |
| Timeouts bei verschachtelter Delegation | 332 Timeouts; nur 89 von rund 1.400 verschachtelten Aufrufen kamen je zurück | von der Deadline ausgenommen auf jeder Ebene |
| Falscher Cache-Tier | Kinder schrieben auf dem 1-Stunden-Tier (20 US-Dollar/M) für eine Aufbewahrung, die ein 20-Minuten-Worker nie nutzt | 5-Minuten-Tier (12,51 US-Dollar/M, gleiche Schleife, gemessen) |
| Tool-Reibung | 546 falsche Hardline-Blocks, 454 Timeout-Ablehnungen, 661 Ganzdatei-Neuschreibungen (rund 155 US-Dollar) | alle drei Klassen verschwunden |
| Stiller Verlust öffentlicher API | 1.703 öffentliche Namen und 126 Tests fielen beim Öffnen des PR weg; die menschliche Prüfung fand etwa 30 | mechanisch erkannt in 18 Sekunden, in CI verdrahtet |
| Stillstand der Goal-Schleife | 3 h 22 min auf dem Poller eines Enkels geparkt; 4 von 5 Nudges verschwendet | nur eigene Prozesse, 30-Minuten-Cap, Idle-Hook-Resume |
| Wildwuchs bei Language-Servern | etwa 30 Pyright-Instanzen mit 8,7 GB | Worktrees teilen sich einen Server, mit einer Prüfung, dass Diagnosen weiterhin ankommen |
Lies die Kostenzeile genau: Die Autoren beschreiben sie ausdrücklich als Preisvergleich pro Schreibvorgang, nicht als Gesamtersparnis, und das Tracking-Issue trennt bewusst vier Dinge — was der Lauf historisch gekostet hat, was beim Beobachten schiefging, was eine Simulation als Wirkung eines Fixes vorhersagt und was sich tatsächlich geändert hat. Diese Zurückhaltung ist nachahmenswert.
Das eigentliche Risiko liegt im Review
So reibungslos die Automatisierung auch läuft: Die Regressionen fangen weiterhin Menschen. Zwei Review-Runden in der Community fanden:
- Gelöschte öffentliche Namen, weil ein Worker keine Aufrufer im Repo sah — während externe Plugins sie importieren.
- Eine automatisierte
suppress()-Umschreibung, die die Exception-Behandlung an rund 65 Stellen veränderte, was die bestehenden Tests überhaupt nicht abdeckten.
Die Antwort auf die Kompatibilität war konkret: 2.091 verschobene Namen blieben über einen PLUGIN-COMPAT-Zeiger aus ihren alten Modulen importierbar, jeder per Objektidentität gegen seinen neuen Eigentümer verifiziert, und kein Code im Baum durfte einen Zeiger verwenden (eine AST-Prüfung erzwang das in CI). Die Zeiger waren ausdrücklich temporär und wurden am 14. September 2026 zurückgenommen. Heute scannt hermes plugins compat betroffene Plugins, mit plugins.allow_deprecated_imports: true als Notausgang.
Auch die Größenordnung der Verifikation ist erwähnenswert: Die vollständige Suite meldete 44.859 bestanden / 51 fehlgeschlagen, und dieselben 17 Dateien scheitern auf barem main identisch (gleiche Dateimenge, gleiche Zähler pro Datei). Der Refaktorierung zurechenbare Regressionen: 0. Diese Disziplin einer eingefrorenen Baseline ist eine Gewohnheit, die ihre eigenen Skills kodieren — reproduziere einen Fehler zuerst in einer sauberen Umgebung, um zu erfahren, ob er schon vorher kaputt war.
Wenn du das in deinem eigenen Repo ausprobieren willst
- Schreibe das Ziel als entscheidbare Abnahmekriterien: die LOC-Reduktion, welche Dateien aufgeteilt werden, welche Interfaces byte-identisch bleiben müssen.
- Miss, bevor du etwas bewegst. Ihre vier Harnesses liegen im Repo; die Idee überträgt sich, auch wenn die Skripte es nicht tun.
- Ein Worktree pro Worker, ein Commit pro verifiziertem Schritt — das ist es, was einen gescheiterten Lauf fortsetzbar macht.
- Plane Unterbrechungen ein. Etwa fünfzig Minuten nach Laufbeginn lief der Auth-Token des Providers ab und tötete das Ganze; weil Commits und Briefings überlebten, konnte eine separate Sitzung diagnostizieren, ein Handoff schreiben und erfolgreich fortsetzen.
- Kalkuliere Review-Zeit ein. Von den Fix-Commits nach dem Merge gehörten sechzehn zur Klasse der still verlorenen öffentlichen API.
- Akzeptiere den Kompromiss. Modulanzahl und Importzeit wurden schlechter; sechs Dateien bleiben über 5.000 Zeilen, was das Team als nächste Runde nennt.
Quellen und Abrechnung
Alle Zahlen hier stammen aus offiziellem, öffentlichem Material: dem eigenen Write-up von Nous Research (veröffentlicht am 17. September 2026), PR #102117 (gemergt am 4. September 2026) und dem anschließenden forensischen Tracking-Issue #103563. Das sind die eigenen Laufdaten und Schätzungen des Projekts — die Kostenspanne und der Vergleich mit dem Personaleinsatz von Menschen eingeschlossen —, nicht von uns lokal reproduzierte Messungen, und die Links sind da, damit du es selbst nachprüfen kannst.
Andere Blickwinkel auf dieselbe Fähigkeit: Live-Orchestrierung von Subagents zeigt, wie man parallelen Agenten bei der Arbeit zusieht, Heartbeats und Goal-Gates erklärt, warum lang laufende /goal-Läufe Heartbeats und Abnahmeprüfungen brauchen, der Plugin-Katalog liefert den praktischen Kontext für den Abschnitt zur Kompatibilität externer Plugins, und wenn die Agenten mehrerer Leute ein Repository bearbeiten, ist die neutrale Schlichtung von Merge-Konflikten der natürliche nächste Schritt.
Zusammenfassung
- Ein
/goal, 19 Stunden, 1.393 Subagents (218 gleichzeitig in der Spitze): Nicht-Test-Quellcode 1.063.826 → 698.363 Zeilen (−34,4 %),gateway/run.pyvon 34.847 auf 5.512 Zeilen, Funktionen mit über 300 Zeilen von 192 auf 2. - Kosten von etwa 19.300 US-Dollar (rund 25.000 US-Dollar mit Folgesitzungen) gegenüber einer Personalkostenschätzung von 150.000 bis 1,8 Mio. US-Dollar; der Preis dafür sind mehr Module und langsamere Importe.
- Sie haben aus den Tokens, die ein Agent beim Lesen des Codes ausgibt, eine reproduzierbare Metrik gemacht: Lookups, deren Datei nicht in einen 128k-Kontext passt, fielen von 1.589 auf 0.
- Die eigentlichen Hindernisse liegen auf Orchestrierungsebene: Auth-Stampedes (620 × 401 → 0), tote Kinder, die 66 Minuten unbemerkt blieben (→ 0,3 s), für 114 von 121 Kindern gekürzte Zusammenfassungen, der falsche Cache-Tier und 1.703 still verlorene öffentliche Namen — inzwischen in 18 Sekunden von einer mechanischen Prüfung erkannt.