1,393 subagents, 19 heures, un seul ordinateur : comment Nous a refactorisé un million de lignes avec Hermes
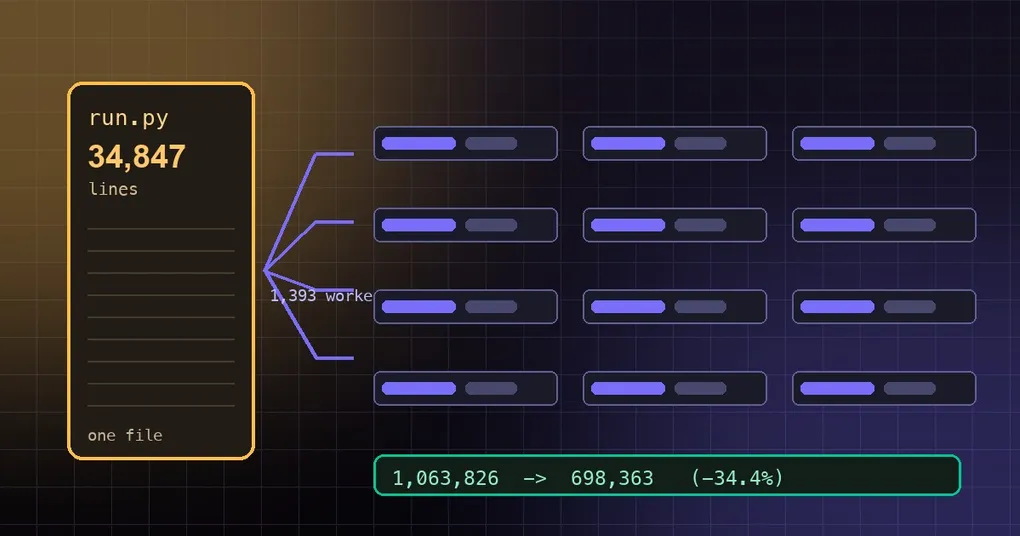
Tout dépôt maintenu depuis quelques années contient une poignée de fichiers que personne n’ose ouvrir : un run.py de 34,000 lignes, une fonction unique de 700 lignes, une échelle d’if/elif profonde de 92 branches. Vous savez qu’il faudrait découper tout ça, mais cela n’entre jamais dans un sprint — ça ne livre aucune fonctionnalité et ça risque d’introduire des régressions, alors que les heures de l’équipe partent aux utilisateurs. C’était exactement la position de Nous Research, et leur réponse a été de laisser l’agent s’en charger. Le 2 septembre 2026, un seul /goal a tourné pendant 19 heures, a lancé 1,393 subagents et a produit la PR #102117, supprimant 34.4% du code source hors tests. Ils ont ensuite publié leur propre télémétrie, la comptabilité des coûts et les neuf choses qui cassent à cette échelle — ce qui en fait un post-mortem utile pour quiconque envisage le même mouvement.
Le résultat, d’abord
| Métrique | Avant | Après |
|---|---|---|
| Lignes de source hors tests (tous répertoires) | 1,063,826 | 698,363 (−34.4%) |
| Fichiers de plus de 5,000 lignes | 37 | 6 |
| Fonctions de plus de 300 lignes | 192 | 2 |
La plus longue chaîne if/elif |
92 branches | 9 |
gateway/run.py |
34,847 lignes | 5,512 lignes |
| Pire complexité cyclomatique | 1,075 | 84 |
Le diff final comptait 4,271 commits répartis sur 2,655 fichiers (+436,199 / −784,430), soit un commit par étape vérifiée. L’exécution principale a pris environ 19 heures et 93,284 appels pour à peu près $19,300, ou environ $25,000 en incluant les sessions de suivi. Leur estimation du coût en personnel pour le faire à la main était de $150,000–$1.8M — ce qui explique précisément pourquoi cela n’a jamais été planifié.
Ils ont aussi publié les indicateurs qui se sont dégradés. Le nombre de modules est passé de 1,152 à 1,551 et les arêtes d’import de 5,245 à 7,135 ; les points d’entrée découpés importent un peu plus lentement (run_agent de 270 à 292 ms, gateway.run de 154 à 196 ms). Le découpage a acheté de la lisibilité, et ça n’a pas été gratuit.
Pourquoi « ce que coûte à un agent la lecture du code » mérite d’être mesuré
L’idée la plus transférable ici, c’est qu’ils ont traité le nombre de tokens qu’un agent doit dépenser pour comprendre le dépôt comme une métrique mesurable plutôt qu’un slogan. Ils ont committé quatre harnais (bench.py, lookup_sim.py, static_metrics.py, runtime_bench.py sous evals/codebase_navigability/, accompagnés d’un README), pour que n’importe qui puisse les reproduire :
| Par tâche « montre-moi ce symbole » | Avant | Après |
|---|---|---|
| Recherches dont le fichier ne tient pas dans un contexte de 128k | 1,589 | 0 |
| Tokens du fichier de définition (médiane) | 30,762 | 10,333 (−66%) |
| Tokens du fichier de définition (max) | 330,028 | 85,075 (−74%) |
| Tokens réellement renvoyés par recherche (moyenne) | 2,218 | 993 (−55%) |
En clair : avant le refactor, 1,589 des symboles importés par la suite de tests vivaient dans un fichier qu’aucun modèle à contexte de 128k ne peut charger du tout. Ce n’est pas une question de style ; c’est une limite de capacité dure. La moyenne a été divisée par deux parce que la queue s’est effondrée — les définitions individuelles sont passées de 38,691 à 2,348 tokens — tandis que la médiane a légèrement augmenté (de 564 à 680) parce que supprimer les commentaires rend chaque ligne survivante plus dense en tokens. C’est dans la longue queue que le contexte brûlait.
Comment tout cela a été organisé
- Un seul
/goalfixait la norme au lieu de distribuer des instructions. Le prompt d’origine disait en substance : une simplification massive, au moins 30% de lignes en moins, les fichiers monolithiques découpés, les helpers unifiés, moins de routage à base de if-if-if, plus de lisibilité et d’élégance, le bloat supprimé, le tout mené à terme et livré sous forme de PR — et, point critique, « pas d’attente de mes décisions ». - L’orchestrateur a mesuré d’abord, puis il a divisé. Il a découpé la base de code en 36 groupes sans chevauchement et a rédigé lui-même les affectations, si bien que l’auteur n’a jamais briefé un worker individuellement.
- Un worktree git par worker. Les workers modifiaient des checkouts séparés pour ne pas pouvoir s’écraser mutuellement ; chaque brief nommait le code à simplifier, les interfaces à préserver et les vérifications exigées avant de committer.
- La parité d’interface était une contrainte dure. Le schéma JSON d’un outil devait rester identique octet pour octet, et la sortie
--helpd’une CLI pouvait être comparée octet par octet. Chaque étape vérifiée devait être committée. - L’échelle impliquée. L’orchestration tournait comme un simple processus Python sur un ordinateur de bureau i7 avec 64 GB de RAM, culminant à 218 agents concurrents (environ 110 en moyenne), l’inférence étant distante. Sur l’ensemble de l’exécution : 478 lots de délégation, 1,652 tâches de subagent, 111,352 appels d’outils (70,046 terminal, 14,223 read_file, 9,224 execute_code, 8,631 write_file, 5,042 patch, 1,328 délégations imbriquées), une tâche médiane de 39 minutes et un p90 de 3.2 heures.
Les neuf choses qui cassent à l’échelle
L’audit médico-légal qui a suivi (issue de suivi #103563) a corrigé neuf classes de problèmes. Voici les murs que vous allez réellement heurter :
| Symptôme | Mesuré | Après le correctif |
|---|---|---|
| Ruée sur l’authentification — de nombreux agents rafraîchissent des tokens en même temps | 620 × 401 dans une seule fenêtre ; le parent est mort, 329 enfants se sont retrouvés orphelins, 74 ont été relancés (~$3,900) | 40 agents expirants : 40 × 401 → 0 |
| Subagents morts que personne ne remarque | une vague entièrement morte est restée invisible pendant 66 minutes | détectée en 0.3 secondes |
| Résumés de subagents tronqués en simples bribes | 114 sur 121 coupés à 2K caractères — des conclusions sans le raisonnement | résumés complets |
| Timeouts de délégation imbriquée | 332 timeouts ; seuls 89 sur environ 1,400 appels imbriqués sont revenus | exemption de deadline à toute profondeur |
| Mauvais palier de cache | les enfants écrivaient au palier 1 heure ($20/M) pour une rétention qu’un worker de 20 minutes n’utilise jamais | palier 5 minutes ($12.51/M, même boucle, mesuré) |
| Friction des outils | 546 faux blocages hardline, 454 refus pour timeout, 661 réécritures de fichier entier (~$155) | les trois classes ont disparu |
| Perte silencieuse d’API publique | 1,703 noms publics et 126 tests perdus à l’ouverture de la PR ; la revue humaine en a trouvé environ 30 | détecté mécaniquement en 18 secondes, câblé dans la CI |
| Blocage de la boucle de goal | s’est arrêté 3 h 22 min sur le poller d’un petit-enfant ; 4 des 5 relances gaspillées | uniquement ses propres processus, plafond de 30 minutes, reprise par idle-hook |
| Prolifération de serveurs de langue | environ 30 instances Pyright consommant 8.7 GB | les worktrees partagent un seul serveur, avec un contrôle vérifiant que les diagnostics arrivent toujours |
Lisez attentivement la ligne des coûts : les auteurs la décrivent explicitement comme une comparaison de prix par écriture, pas une économie globale, et l’issue de suivi sépare délibérément quatre choses — ce que l’exécution a dépensé historiquement, ce qui a été observé en train de mal tourner, ce qu’une simulation annonce qu’un correctif changerait, et ce qui a réellement changé. Cette retenue mérite d’être copiée.
Le vrai risque se trouve dans la revue
Aussi fluide soit l’automatisation, ce sont encore les humains qui attrapent les régressions. Deux tours de revue communautaire ont mis au jour :
- Des noms publics supprimés parce qu’un worker ne voyait aucun appelant dans le dépôt — alors que des plugins externes les importent.
- Une réécriture automatisée de
suppress()qui a modifié la gestion des exceptions à environ 65 endroits, ce que les tests existants ne couvraient pas du tout.
La réponse sur la compatibilité a été concrète : 2,091 noms déplacés sont restés importables depuis leurs anciens modules grâce à un pointeur PLUGIN-COMPAT, chacun vérifié par identité d’objet face à son nouveau propriétaire, et aucun code du dépôt n’était autorisé à utiliser un pointeur (une vérification AST l’imposait dans la CI). Les pointeurs étaient explicitement temporaires et ont été annulés le 14 septembre 2026. Aujourd’hui, hermes plugins compat scanne les plugins concernés, avec plugins.allow_deprecated_imports: true comme porte de sortie.
L’échelle de vérification mérite elle aussi d’être notée : la suite complète a rapporté 44,859 passed / 51 failed, et ces mêmes 17 fichiers échouent à l’identique sur un main nu (même ensemble de fichiers, mêmes comptes par fichier). Régressions attribuables au refactor : 0. Cette discipline de base de référence gelée est une habitude que leurs propres skills encodent — reproduire d’abord une défaillance dans un environnement propre pour savoir si elle était déjà cassée.
Si vous voulez tenter l’expérience dans votre propre dépôt
- Écrivez le goal sous forme de critères d’acceptation décidables : la réduction de LOC, quels fichiers découper, quelles interfaces doivent rester identiques octet pour octet.
- Mesurez avant de bouger. Leurs quatre harnais sont dans le dépôt ; l’idée se transfère même si les scripts ne se transfèrent pas.
- Un worktree par worker, un commit par étape vérifiée — c’est ce qui rend une exécution échouée reprenable.
- Prévoyez l’interruption. Environ cinquante minutes après le début de leur exécution, le token d’authentification du provider a expiré et a tout tué ; comme les commits et les briefs avaient survécu, une session distincte a pu diagnostiquer, écrire un handoff et reprendre avec succès.
- Budgétez la revue. Parmi les commits de correction post-merge, seize appartenaient à la classe « API publique silencieusement perdue ».
- Acceptez le compromis. Le nombre de modules et le temps d’import se sont dégradés ; six fichiers dépassent encore 5,000 lignes, ce que l’équipe liste pour le tour suivant.
Sources et comptabilité
Chaque chiffre ici provient de documents publics officiels : le compte rendu de Nous Research lui-même (publié le 17 septembre 2026), la PR #102117 (fusionnée le 4 septembre 2026) et l’issue de suivi médico-légal #103563. Ce sont les données d’exécution et les estimations du projet lui-même — la fourchette de coûts et la comparaison avec le personnel humain incluses — et non des mesures que nous aurions reproduites localement ; les liens sont là pour que vous puissiez vérifier.
Autres angles sur la même capacité : l’orchestration de subagents en direct montre des agents travaillant en parallèle, les heartbeats et les goal gates explique pourquoi les exécutions /goal de longue durée ont besoin de heartbeats et de contrôles d’acceptation, le catalogue de plugins fournit le contexte pratique de cette section sur la compatibilité des plugins externes, et si les agents de plusieurs personnes modifient un même dépôt, l’arbitrage neutre des conflits de merge est l’étape suivante naturelle.
Résumé
- Un seul
/goal, 19 heures, 1,393 subagents (218 concurrents au pic) : source hors tests 1,063,826 → 698,363 lignes (−34.4%),gateway/run.pyde 34,847 à 5,512 lignes, fonctions de plus de 300 lignes de 192 à 2. - Coût d’environ $19,300 (environ $25,000 avec les suivis) face à une estimation de personnel de $150,000–$1.8M ; le prix payé, ce sont plus de modules et des imports plus lents.
- Ils ont transformé « les tokens qu’un agent dépense à lire le code » en une métrique reproductible : les recherches dont le fichier ne peut pas tenir dans un contexte de 128k sont passées de 1,589 à 0.
- Les vrais obstacles sont au niveau de l’orchestration : ruées sur l’authentification (620 × 401 → 0), enfants morts invisibles pendant 66 minutes (→ 0.3 s), résumés tronqués pour 114 des 121 enfants, mauvais palier de cache et 1,703 noms publics silencieusement perdus — désormais détectés en 18 secondes par un contrôle mécanique.