1.393 subagentes, 19 horas, um desktop: como a Nous refatorou um milhão de linhas com o Hermes
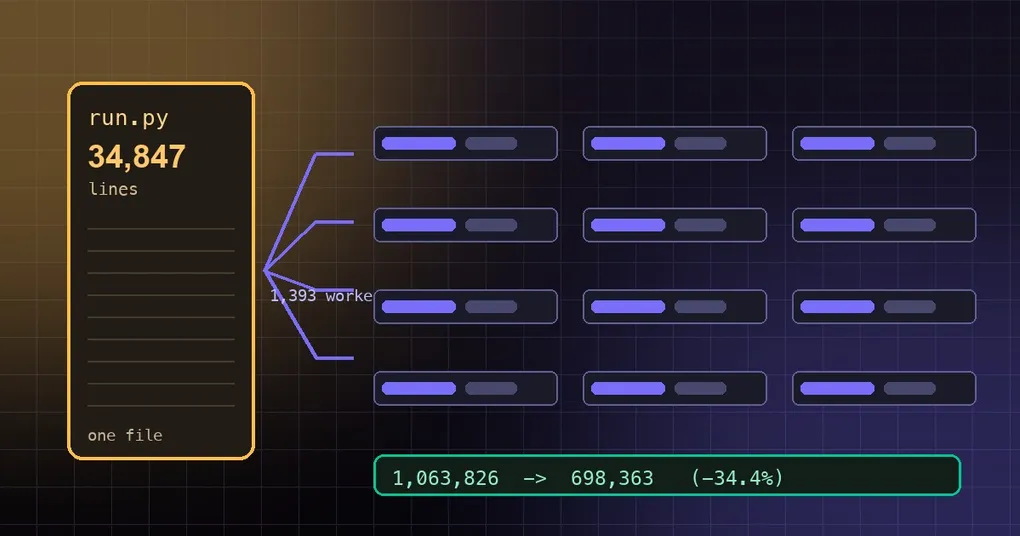
Todo repositório mantido por alguns anos tem um punhado de arquivos que ninguém ousa abrir: um run.py com 34.000 linhas, uma única função com 700 linhas, uma escada de if/elif com 92 ramificações de profundidade. Você sabe que aquilo deveria ser dividido, mas nunca entra no sprint — não entrega nenhuma feature e pode introduzir regressões, enquanto as horas do time vão para os usuários. Essa era exatamente a situação da Nous Research, e a resposta deles foi deixar o agente fazer o trabalho. Em 2 de setembro de 2026, um único /goal rodou por 19 horas, despachou 1.393 subagentes e produziu o PR #102117, removendo 34,4% do código-fonte sem os testes. Eles então publicaram a própria telemetria, a contabilidade de custos e as nove coisas que quebram nessa escala — o que faz disso um postmortem útil para quem estiver pensando em fazer o mesmo movimento.
Primeiro, o resultado
| Métrica | Antes | Depois |
|---|---|---|
| Linhas de código-fonte sem testes (todos os diretórios) | 1.063.826 | 698.363 (−34,4%) |
| Arquivos com mais de 5.000 linhas | 37 | 6 |
| Funções com mais de 300 linhas | 192 | 2 |
Cadeia if/elif mais longa |
92 ramificações | 9 |
gateway/run.py |
34.847 linhas | 5.512 linhas |
| Pior complexidade ciclomática | 1.075 | 84 |
O diff final somou 4.271 commits em 2.655 arquivos (+436.199 / −784.430), um commit por passo verificado. A execução principal levou cerca de 19 horas e 93.284 chamadas, a aproximadamente $19.300, ou cerca de $25.000 incluindo as sessões de acompanhamento. A estimativa da própria equipe para fazer isso à mão era de $150.000–$1,8M — e é exatamente por isso que a tarefa nunca era agendada.
Eles também publicaram as contramétricas. O número de módulos subiu de 1.152 para 1.551, e as arestas de importação de 5.245 para 7.135; os pontos de entrada divididos importam um pouco mais devagar (run_agent de 270 para 292 ms, gateway.run de 154 para 196 ms). A divisão comprou legibilidade, e não saiu de graça.
Por que vale a pena medir “quanto custa para um agente ler o código”
A ideia mais transferível aqui é que eles trataram quantos tokens um agente precisa gastar para entender o repositório como uma métrica mensurável, e não como slogan. Eles commitaram quatro harnesses (bench.py, lookup_sim.py, static_metrics.py, runtime_bench.py em evals/codebase_navigability/, com um README), então qualquer pessoa pode reproduzi-los:
| Por tarefa de “me mostre este símbolo” | Antes | Depois |
|---|---|---|
| Consultas cujo arquivo não cabe em um contexto de 128k | 1.589 | 0 |
| Tokens do arquivo de definição (mediana) | 30.762 | 10.333 (−66%) |
| Tokens do arquivo de definição (máx.) | 330.028 | 85.075 (−74%) |
| Tokens de fato retornados por consulta (média) | 2.218 | 993 (−55%) |
Em termos simples: antes da refatoração, 1.589 dos símbolos importados pela suíte de testes viviam em um arquivo que nenhum modelo com contexto de 128k consegue carregar. Isso não é uma questão de estilo; é um limite duro de capacidade. A média caiu pela metade porque a cauda desabou — definições individuais passaram de 38.691 tokens para 2.348 —, enquanto a mediana subiu um pouco (de 564 para 680) porque remover os comentários deixa cada linha sobrevivente mais densa em tokens. É na cauda longa que o contexto estava queimando.
Como tudo foi organizado
- Um único
/goaldefiniu o padrão em vez de emitir instruções. O prompt original dizia, em essência: uma simplificação massiva, pelo menos 30% menos linhas, god files desmembrados, helpers unificados, menos roteamento if-if-if, legibilidade e elegância em alta, excesso de código removido, tudo isso concluído e entregue como um PR — e, o mais importante, “sem esperar pelas minhas decisões”. - O orquestrador mediu primeiro e só então dividiu. Ele partiu a base de código em 36 grupos sem sobreposição e escreveu as atribuições ele mesmo, então o autor nunca precisou briefar um worker individualmente.
- Um git worktree por worker. Os workers editavam checkouts separados para não conseguirem sobrescrever uns aos outros; cada briefing nomeava o código a simplificar, as interfaces a preservar e as verificações exigidas antes do commit.
- Paridade de interface era uma restrição rígida. O JSON schema de uma ferramenta tinha de permanecer byte a byte idêntico, e a saída de
--helpde uma CLI podia ser comparada byte a byte. Todo passo verificado tinha de virar commit. - A escala envolvida. A orquestração rodou como um único processo Python em um desktop i7 com 64 GB de RAM, chegando ao pico de 218 agentes simultâneos (cerca de 110 em média), com inferência remota. Ao longo da execução: 478 lotes de delegação, 1.652 tarefas de subagente, 111.352 chamadas de ferramenta (70.046 no terminal, 14.223 read_file, 9.224 execute_code, 8.631 write_file, 5.042 patch, 1.328 delegações aninhadas), uma tarefa mediana de 39 minutos e um p90 de 3,2 horas.
As nove coisas que quebram em escala
A auditoria forense que veio depois (issue de acompanhamento #103563) corrigiu nove classes de problema. Estes são os muros que você realmente vai bater:
| Sintoma | Medido | Depois da correção |
|---|---|---|
| Estouro de autenticação (auth stampede) — muitos agentes renovando tokens ao mesmo tempo | 620 × 401 em uma única janela; o pai morreu, 329 filhos ficaram órfãos, 74 foram reenviados (~$3.900) | 40 agentes expirando: 40 × 401 → 0 |
| Subagentes mortos que ninguém percebe | uma onda inteira morta ficou 66 minutos sem ser vista | detectada em 0,3 segundo |
| Resumos dos filhos truncados a esboços | 114 de 121 cortados em 2K caracteres — conclusões sem processo | resumos completos |
| Timeouts de delegação aninhada | 332 timeouts; apenas 89 de cerca de 1.400 chamadas aninhadas chegaram a retornar | isentos de deadline em qualquer profundidade |
| Camada de cache errada | os filhos gravavam na camada de 1 hora ($20/M) para uma retenção que um worker de 20 minutos nunca usa | camada de 5 minutos ($12,51/M, mesmo loop, medido) |
| Atrito com ferramentas | 546 bloqueios falsos de hardline, 454 recusas por timeout, 661 reescritas de arquivo inteiro (~$155) | as três classes eliminadas |
| Perda silenciosa de API pública | 1.703 nomes públicos e 126 testes descartados na abertura do PR; a revisão humana encontrou cerca de 30 | detectada mecanicamente em 18 segundos, integrada ao CI |
| Travamento do goal-loop | estacionado por 3 h 22 min no poller de um processo neto; 4 de 5 nudges desperdiçados | apenas processos próprios, limite de 30 minutos, retomada por idle-hook |
| Proliferação de language servers | cerca de 30 instâncias do Pyright consumindo 8,7 GB | os worktrees compartilham um único servidor, com uma checagem de que os diagnósticos ainda chegam |
Leia a linha de custo com atenção: os próprios autores a descrevem explicitamente como uma comparação de preço por gravação, não uma economia agregada, e a issue de acompanhamento separa quatro coisas de propósito — o que a execução gastou historicamente, o que se observou dando errado, o que uma simulação diz que uma correção mudaria, e o que de fato mudou. Essa contenção vale a pena ser copiada.
O risco de verdade mora na revisão
Por mais fluida que seja a automação, os humanos ainda pegam as regressões. Duas rodadas de revisão da comunidade encontraram:
- Nomes públicos deletados porque um worker não viu chamadores dentro do repositório — enquanto plugins externos os importam.
- Uma reescrita automática de
suppress()que mudou o tratamento de exceções em cerca de 65 pontos, algo que os testes existentes não cobriam de forma alguma.
A resposta de compatibilidade foi concreta: 2.091 nomes movidos continuaram importáveis a partir dos módulos antigos por meio de um ponteiro PLUGIN-COMPAT, cada um verificado por identidade de objeto contra seu novo dono, e nenhum código dentro da árvore podia usar um ponteiro (uma checagem de AST garantia isso no CI). Os ponteiros eram explicitamente temporários e foram revertidos em 14 de setembro de 2026. Hoje hermes plugins compat varre os plugins afetados, com plugins.allow_deprecated_imports: true como válvula de escape.
A escala da verificação também merece nota: a suíte completa reportou 44.859 aprovados / 51 falhas, e esses mesmos 17 arquivos falham de forma idêntica na main pura (mesmo conjunto de arquivos, mesmas contagens por arquivo). Regressões atribuíveis à refatoração: 0. Essa disciplina de baseline congelado é um hábito que as próprias skills deles codificam — reproduza uma falha em um ambiente limpo primeiro para descobrir se ela já estava quebrada.
Se você quiser tentar isso no seu próprio repositório
- Escreva o goal como critérios de aceitação decidíveis: a redução de LOC, quais arquivos são divididos, quais interfaces devem permanecer byte a byte idênticas.
- Meça antes de mexer. Os quatro harnesses deles estão no repositório; a ideia se transfere mesmo que os scripts não.
- Um worktree por worker, um commit por passo verificado — é isso que torna uma execução que falhou retomável.
- Planeje para a interrupção. Cerca de cinquenta minutos depois do início, o token de auth do provider expirou e matou tudo; como os commits e os briefings sobreviveram, uma sessão separada pôde diagnosticar, escrever um handoff e retomar com sucesso.
- Reserve orçamento para a revisão. Dos commits de correção pós-merge, dezesseis pertenciam à classe “API pública descartada em silêncio”.
- Aceite o trade-off. O número de módulos e o tempo de import pioraram; seis arquivos continuam acima de 5.000 linhas, o que a equipe lista como próxima rodada.
Fontes e contabilidade
Todos os números aqui vêm de material público oficial: o próprio write-up da Nous Research (publicado em 17 de setembro de 2026), o PR #102117 (merged em 4 de setembro de 2026) e a issue forense de acompanhamento #103563. Estes são os dados de execução e as estimativas do próprio projeto — incluindo a faixa de custo e a comparação com a equipe humana —, não medições que reproduzimos localmente, e os links estão aí para você conferir.
Outros ângulos sobre a mesma capacidade: orquestração ao vivo de subagentes mostra como acompanhar agentes paralelos trabalhando, heartbeats e goal gates explica por que execuções longas de /goal precisam de heartbeats e checagens de aceitação, o catálogo de plugins é o contexto prático para aquela seção de compatibilidade com plugins externos, e se os agentes de várias pessoas editam um mesmo repositório, a arbitragem neutra de conflitos de merge é o próximo passo natural.
Resumo
- Um
/goal, 19 horas, 1.393 subagentes (218 simultâneos no pico): o código-fonte sem testes passou de 1.063.826 → 698.363 linhas (−34,4%),gateway/run.pyde 34.847 para 5.512 linhas, funções com mais de 300 linhas de 192 para 2. - Custo de aproximadamente $19.300 (cerca de $25.000 com os acompanhamentos) contra uma estimativa de $150.000–$1,8M para fazer à mão; o preço pago é mais módulos e imports mais lentos.
- Eles transformaram “os tokens que um agente gasta lendo o código” em uma métrica reproduzível: as consultas cujo arquivo não cabe em um contexto de 128k caíram de 1.589 para 0.
- Os obstáculos reais estão no nível da orquestração: estouros de autenticação (620 × 401 → 0), filhos mortos invisíveis por 66 minutos (→ 0,3 s), resumos truncados em 114 de 121 filhos, a camada de cache errada e 1.703 nomes públicos descartados em silêncio — agora detectados em 18 segundos por uma checagem mecânica.